
Flussdiagramm
Complementos SQL
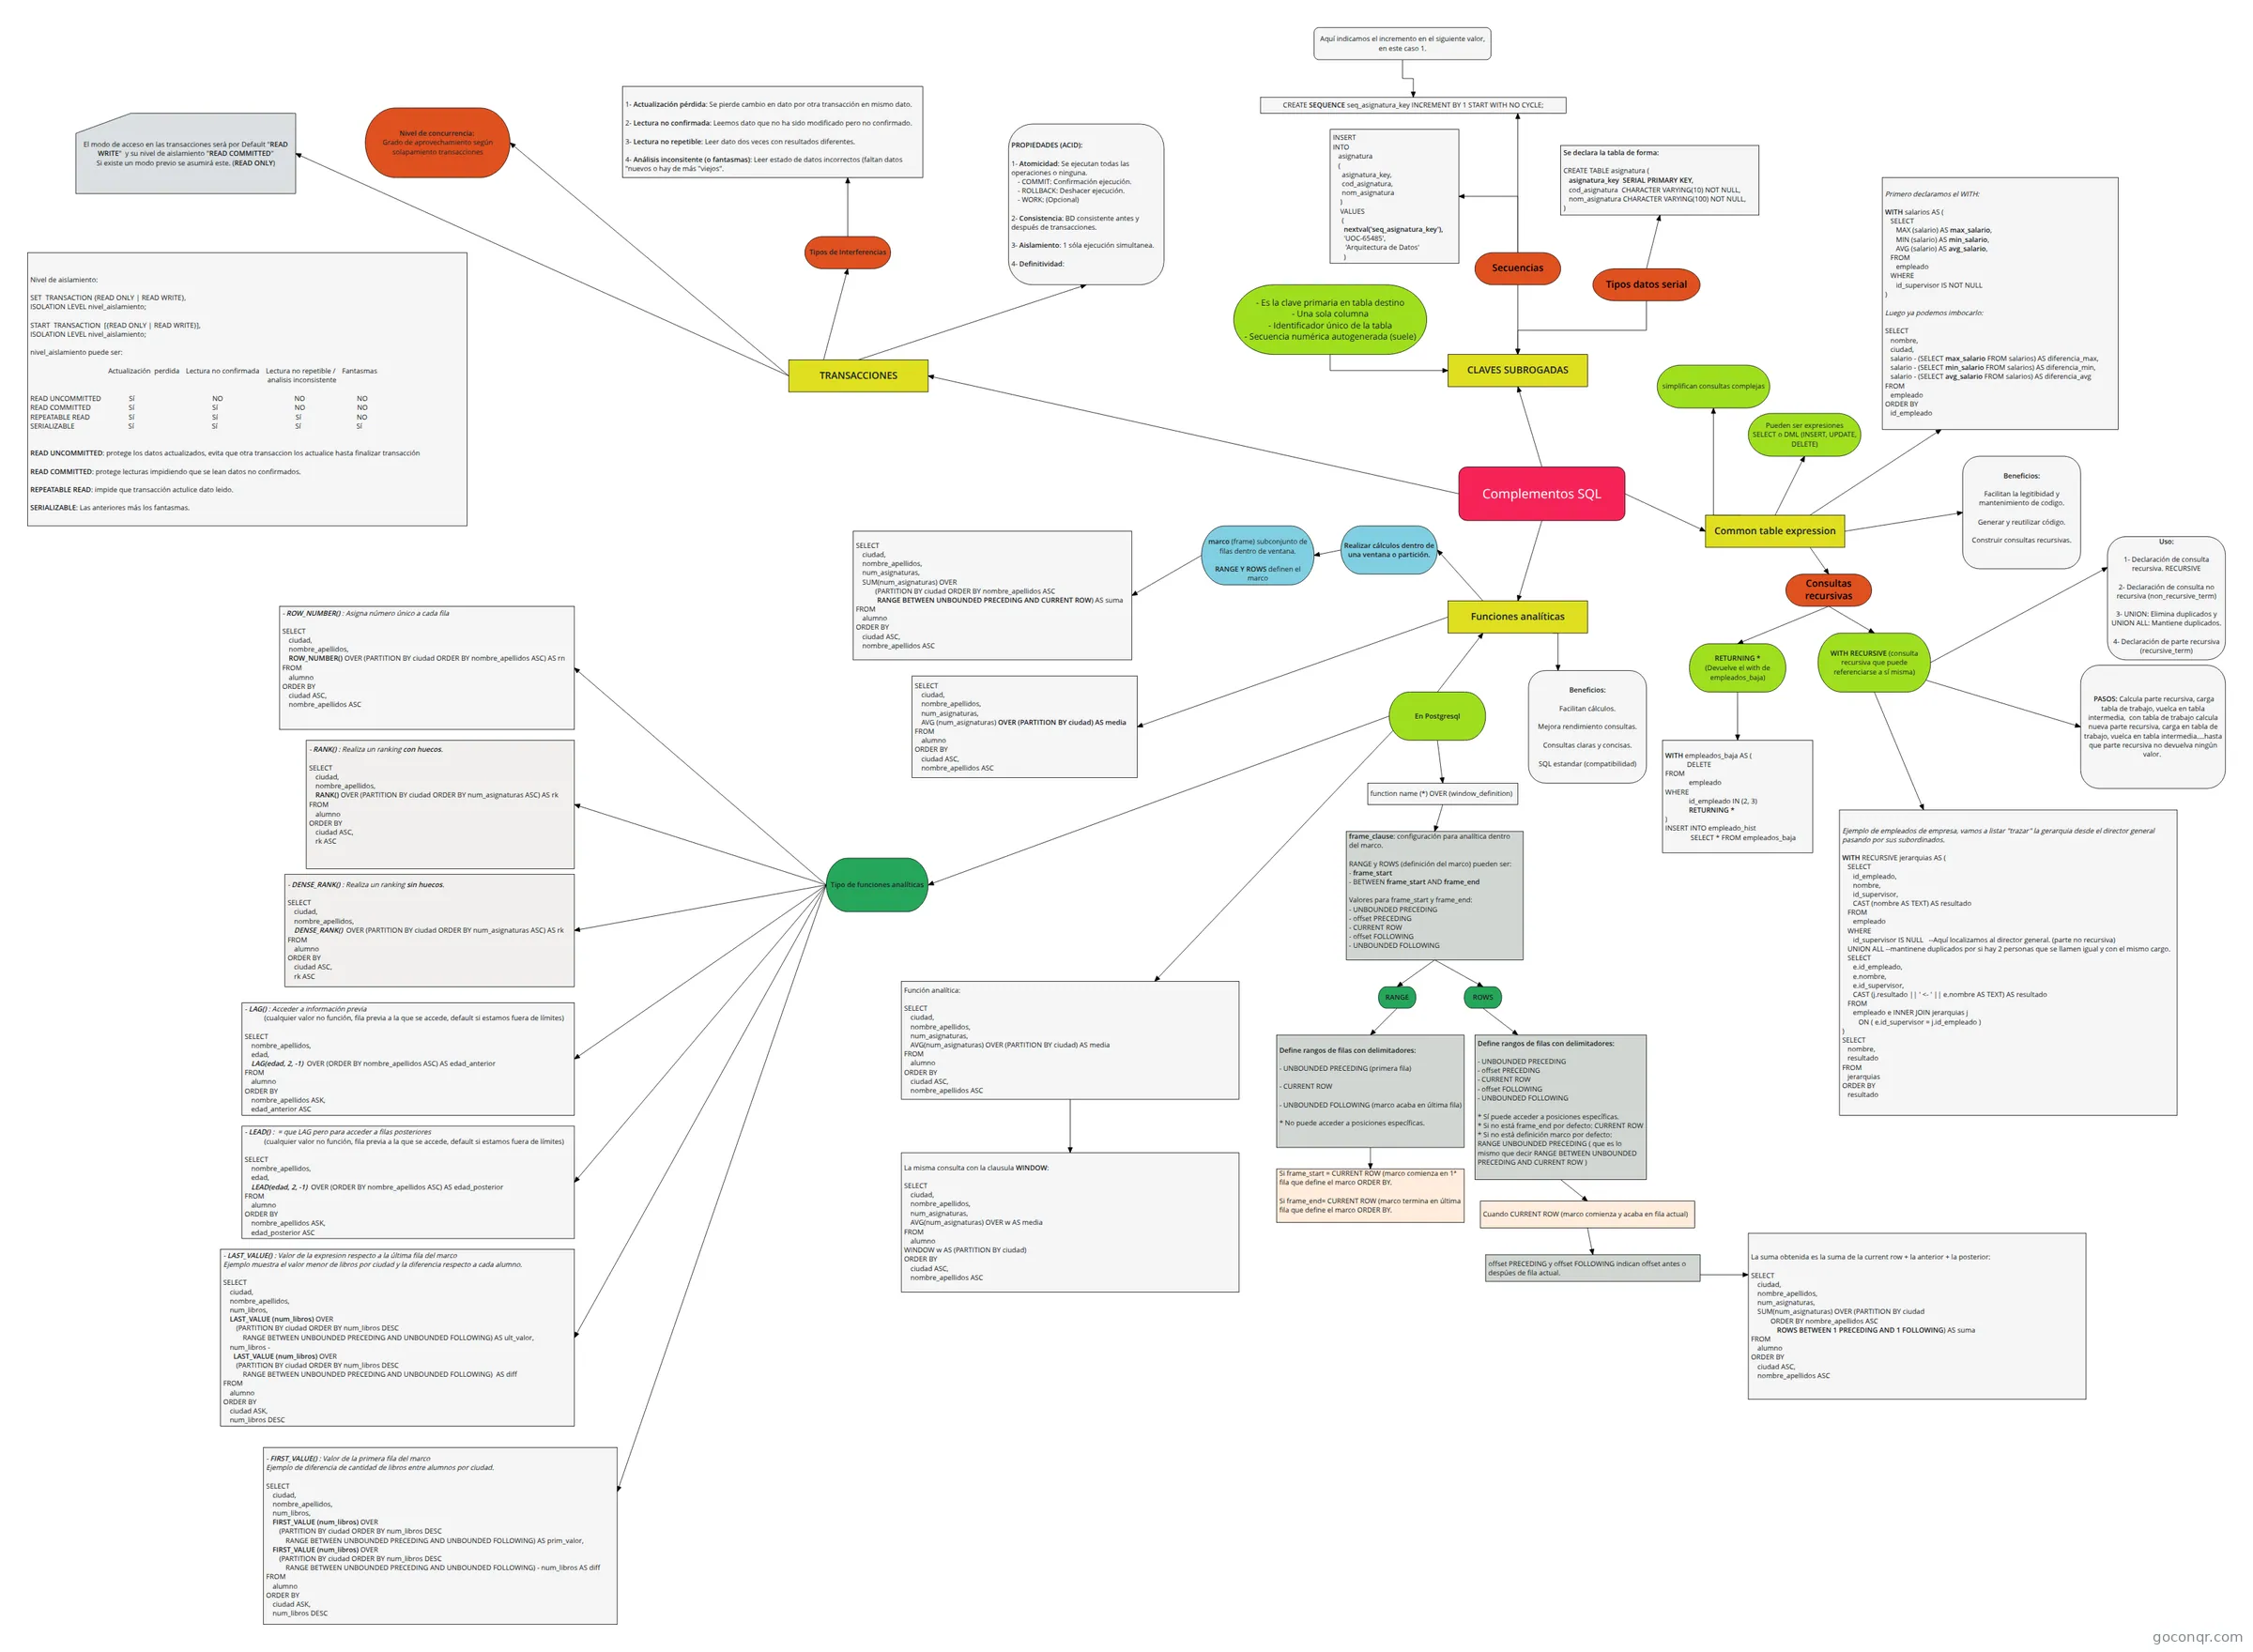
Diagrama de flujo: Complementos SQL
Inhalt des Flussdiagramms
CLAVES SUBROGADAS
Complementos SQL
- Es la clave primaria en tabla destino
- Una sola columna
- Identificador único de la tabla
- Secuencia numérica autogenerada (suele)
Secuencias
Tipos datos serial
CREATE SEQUENCE seq_asignatura_key INCREMENT BY 1 START WITH NO CYCLE;
INSERT
INTO
asignatura
(
asignatura_key,
cod_asignatura,
nom_asignatura
)
VALUES
(
nextval('seq_asignatura_key'),
'UOC-65485',
'Arquitectura de Datos'
)
Aquí indicamos el incremento en el siguiente valor, en este caso 1.
Se declara la tabla de forma:
CREATE TABLE asignatura (
asignatura_key SERIAL PRIMARY KEY,
cod_asignatura CHARACTER VARYING(10) NOT NULL,
nom_asignatura CHARACTER VARYING(100) NOT NULL,
)
Common table expression
simplifican consultas complejas
Primero declaramos el WITH:
WITH salarios AS (
SELECT
MAX (salario) AS max_salario,
MIN (salario) AS min_salario,
AVG (salario) AS avg_salario,
FROM
empleado
WHERE
id_supervisor IS NOT NULL
)
Luego ya podemos imbocarlo:
SELECT
nombre,
ciudad,
salario - (SELECT max_salario FROM salarios) AS diferencia_max,
salario - (SELECT min_salario FROM salarios) AS diferencia_min,
salario - (SELECT avg_salario FROM salarios) AS diferencia_avg
FROM
empleado
ORDER BY
id_empleado
Beneficios:
Facilitan la legitibidad y mantenimiento de codigo.
Generar y reutilizar código.
Construir consultas recursivas.
Pueden ser expresiones
SELECT o DML (INSERT, UPDATE, DELETE)
WITH RECURSIVE (consulta recursiva que puede referenciarse a sí misma)
Uso:
1- Declaración de consulta recursiva. RECURSIVE
2- Declaración de consulta no recursiva (non_recursive_term)
3- UNION: Elimina duplicados y UNION ALL: Mantiene duplicados.
4- Declaración de parte recursiva (recursive_term)
Consultas recursivas
Ejemplo de empleados de empresa, vamos a listar "trazar" la gerarquia desde el director general pasando por sus subordinados.
WITH RECURSIVE jerarquias AS (
SELECT
id_empleado,
nombre,
id_supervisor,
CAST (nombre AS TEXT) AS resultado
FROM
empleado
WHERE
id_supervisor IS NULL --Aquí localizamos al director general. (parte no recursiva)
UNION ALL --mantinene duplicados por si hay 2 personas que se llamen igual y con el mismo cargo.
SELECT
e.id_empleado,
e.nombre,
e.id_supervisor,
CAST (j.resultado || ' <- ' || e.nombre AS TEXT) AS resultado
FROM
empleado e INNER JOIN jerarquias j
ON ( e.id_supervisor = j.id_empleado )
)
SELECT
nombre,
resultado
FROM
jerarquias
ORDER BY
resultado
WITH empleados_baja AS (
DELETE
FROM
empleado
WHERE
id_empleado IN (2, 3)
RETURNING *
)
INSERT INTO empleado_hist
SELECT * FROM empleados_baja
RETURNING *
(Devuelve el with de empleados_baja)
PASOS: Calcula parte recursiva, carga tabla de trabajo, vuelca en tabla intermedia, con tabla de trabajo calcula nueva parte recursiva, carga en tabla de trabajo, vuelca en tabla intermedia....hasta que parte recursiva no devuelva ningún valor.
Funciones analíticas
Realizar cálculos dentro de una ventana o partición.
SELECT
ciudad,
nombre_apellidos,
num_asignaturas,
AVG (num_asignaturas) OVER (PARTITION BY ciudad) AS media
FROM
alumno
ORDER BY
ciudad ASC,
nombre_apellidos ASC
marco (frame) subconjunto de filas dentro de ventana.
RANGE Y ROWS definen el marco
SELECT
ciudad,
nombre_apellidos,
num_asignaturas,
SUM(num_asignaturas) OVER
(PARTITION BY ciudad ORDER BY nombre_apellidos ASC
RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) AS suma
FROM
alumno
ORDER BY
ciudad ASC,
nombre_apellidos ASC
Beneficios:
Facilitan cálculos.
Mejora rendimiento consultas.
Consultas claras y concisas.
SQL estandar (compatibilidad)
En Postgresql
function name (*) OVER (window_definition)
frame_clause: configuración para analítica dentro del marco.
RANGE y ROWS (definición del marco) pueden ser:
- frame_start
- BETWEEN frame_start AND frame_end
Valores para frame_start y frame_end:
- UNBOUNDED PRECEDING
- offset PRECEDING
- CURRENT ROW
- offset FOLLOWING
- UNBOUNDED FOLLOWING
RANGE
ROWS
Define rangos de filas con delimitadores:
- UNBOUNDED PRECEDING (primera fila)
- CURRENT ROW
- UNBOUNDED FOLLOWING (marco acaba en última fila)
* No puede acceder a posiciones específicas.
Define rangos de filas con delimitadores:
- UNBOUNDED PRECEDING
- offset PRECEDING
- CURRENT ROW
- offset FOLLOWING
- UNBOUNDED FOLLOWING
* Sí puede acceder a posiciones específicas.
* Si no está frame_end por defecto: CURRENT ROW
* Si no está definición marco por defecto:
RANGE UNBOUNDED PRECEDING ( que es lo mismo que decir RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW )
Si frame_start = CURRENT ROW (marco comienza en 1ª fila que define el marco ORDER BY.
Si frame_end= CURRENT ROW (marco termina en última fila que define el marco ORDER BY.
Cuando CURRENT ROW (marco comienza y acaba en fila actual)
offset PRECEDING y offset FOLLOWING indican offset antes o despúes de fila actual.
La suma obtenida es la suma de la current row + la anterior + la posterior:
SELECT
ciudad,
nombre_apellidos,
num_asignaturas,
SUM(num_asignaturas) OVER (PARTITION BY ciudad
ORDER BY nombre_apellidos ASC
ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING) AS suma
FROM
alumno
ORDER BY
ciudad ASC,
nombre_apellidos ASC
Función analítica:
SELECT
ciudad,
nombre_apellidos,
num_asignaturas,
AVG(num_asignaturas) OVER (PARTITION BY ciudad) AS media
FROM
alumno
ORDER BY
ciudad ASC,
nombre_apellidos ASC
La misma consulta con la clausula WINDOW:
SELECT
ciudad,
nombre_apellidos,
num_asignaturas,
AVG(num_asignaturas) OVER w AS media
FROM
alumno
WINDOW w AS (PARTITION BY ciudad)
ORDER BY
ciudad ASC,
nombre_apellidos ASC
Tipo de funciones analíticas
- DENSE_RANK() : Realiza un ranking sin huecos.
SELECT
ciudad,
nombre_apellidos,
DENSE_RANK() OVER (PARTITION BY ciudad ORDER BY num_asignaturas ASC) AS rk
FROM
alumno
ORDER BY
ciudad ASC,
rk ASC
- ROW_NUMBER() : Asigna número único a cada fila
SELECT
ciudad,
nombre_apellidos,
ROW_NUMBER() OVER (PARTITION BY ciudad ORDER BY nombre_apellidos ASC) AS rn
FROM
alumno
ORDER BY
ciudad ASC,
nombre_apellidos ASC
- RANK() : Realiza un ranking con huecos.
SELECT
ciudad,
nombre_apellidos,
RANK() OVER (PARTITION BY ciudad ORDER BY num_asignaturas ASC) AS rk
FROM
alumno
ORDER BY
ciudad ASC,
rk ASC
- LAG() : Acceder a información previa
(cualquier valor no función, fila previa a la que se accede, default si estamos fuera de límites)
SELECT
nombre_apellidos,
edad,
LAG(edad, 2, -1) OVER (ORDER BY nombre_apellidos ASC) AS edad_anterior
FROM
alumno
ORDER BY
nombre_apellidos ASK,
edad_anterior ASC
- LEAD() : = que LAG pero para acceder a filas posteriores
(cualquier valor no función, fila previa a la que se accede, default si estamos fuera de límites)
SELECT
nombre_apellidos,
edad,
LEAD(edad, 2, -1) OVER (ORDER BY nombre_apellidos ASC) AS edad_posterior
FROM
alumno
ORDER BY
nombre_apellidos ASK,
edad_posterior ASC
- FIRST_VALUE() : Valor de la primera fila del marco
Ejemplo de diferencia de cantidad de libros entre alumnos por ciudad.
SELECT
ciudad,
nombre_apellidos,
num_libros,
FIRST_VALUE (num_libros) OVER
(PARTITION BY ciudad ORDER BY num_libros DESC
RANGE BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING) AS prim_valor,
FIRST_VALUE (num_libros) OVER
(PARTITION BY ciudad ORDER BY num_libros DESC
RANGE BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING) - num_libros AS diff
FROM
alumno
ORDER BY
ciudad ASK,
num_libros DESC
- LAST_VALUE() : Valor de la expresion respecto a la última fila del marco
Ejemplo muestra el valor menor de libros por ciudad y la diferencia respecto a cada alumno.
SELECT
ciudad,
nombre_apellidos,
num_libros,
LAST_VALUE (num_libros) OVER
(PARTITION BY ciudad ORDER BY num_libros DESC
RANGE BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING) AS ult_valor,
num_libros -
LAST_VALUE (num_libros) OVER
(PARTITION BY ciudad ORDER BY num_libros DESC
RANGE BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING) AS diff
FROM
alumno
ORDER BY
ciudad ASK,
num_libros DESC
TRANSACCIONES
PROPIEDADES (ACID):
1- Atomicidad: Se ejecutan todas las operaciones o ninguna.
- COMMIT: Confirmación ejecución.
- ROLLBACK: Deshacer ejecución.
- WORK: (Opcional)
2- Consistencia: BD consistente antes y después de transacciones.
3- Aislamiento: 1 sóla ejecución simultanea.
4- Definitividad:
Tipos de Interferencias
1- Actualización pérdida: Se pierde cambio en dato por otra transacción en mismo dato.
2- Lectura no confirmada: Leemos dato que no ha sido modificado pero no confirmado.
3- Lectura no repetible: Leer dato dos veces con resultados diferentes.
4- Análisis inconsitente (o fantasmas): Leer estado de datos incorrectos (faltan datos "nuevos o hay de más "viejos".
Nivel de concurrencia:
Grado de aprovechamiento según solapamiento transacciones
El modo de acceso en las transacciones será por Default "READ WRITE" y su nivel de aislamiento "READ COMMITTED"
Si existe un modo previo se asumirá este. (READ ONLY)
Nivel de aislamiento:
SET TRANSACTION {READ ONLY | READ WRITE},
ISOLATION LEVEL nivel_aislamiento;
START TRANSACTION [{READ ONLY | READ WRITE}],
ISOLATION LEVEL nivel_aislamiento;
nivel_aislamiento puede ser:
Actualización perdida Lectura no confirmada Lectura no repetible / Fantasmas
analisis inconsistente
READ UNCOMMITTED Sí NO NO NO
READ COMMITTED Sí Sí NO NO
REPEATABLE READ Sí Sí Sí NO
SERIALIZABLE Sí Sí Sí Sí
READ UNCOMMITTED: protege los datos actualizados, evita que otra transaccion los actualice hasta finalizar transacción
READ COMMITTED: protege lecturas impidiendo que se lean datos no confirmados.
REPEATABLE READ: impide que transacción actulice dato leido.
SERIALIZABLE: Las anteriores más los fantasmas.
Informationen
- Beschreibung
- Claves Subrogadas Common table expression Funciones analíticas Tratamiento de valores nulos Transacciones
- Erstellt von
- Roberto Caride
- Aufrufe
- 16
- Bewertung