
Mindmap
Deep Learning - Modulo IV
Inhalt der Mindmap
Deep Learning - Modulo IV
Shallow NN
- Sem consenso definido
- Apenas um hidden layer
- Input como vetor
Deep NN
- Mais de um hidden layer
- Grande numero de Neurônios artificias
- Alem de vetor, raw datas
- Pega os input de imagens, textos e automáticamente consegue extrair as feautures para que definem os dados.
- Por que começou a crescer só "agora"?
- Avanços no campo de pesquisa
- Exemplo ReLu que aprimorou os estudos de NN
- Data disponível
- Necessitava de um número de dados muito grade para evitar overfit. Mais dados -> melhor performace
- Poder Computacional
- Avanços no campo de pesquisa
Convulational Neural Networks (CNN)
- Algoritmos de DL Supervisionados
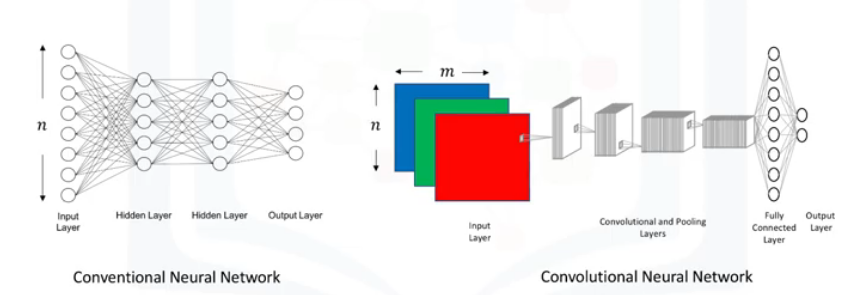
- Similar as NN
- Composta de neurônios, bias e pesos otimizados
- Cada neurõnio combina a entrada, computadndo o produto entre a entreada propriamente dita e o peso. Antes do treino, utiliza-se uma função de ativação, a maior parte das vezes -> Relu
- Pega os inputs como imagens
- Treino mais eficiente
- Problemas de reconhecimento, detecção de objetos / computer vision
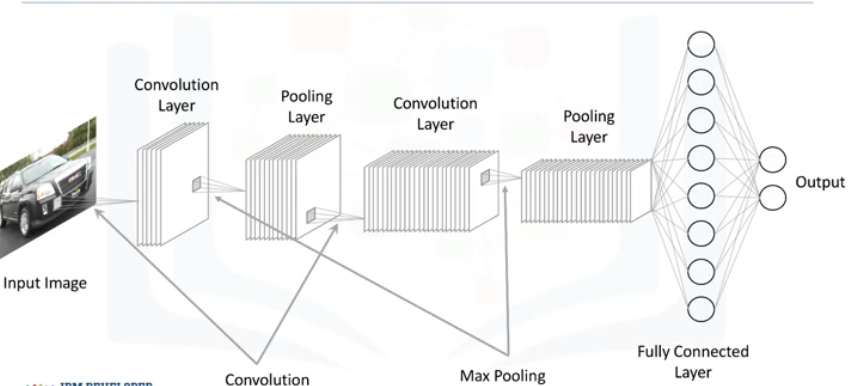
- Arquitetura
- Input (n x m x 1) grayscale
- Input (n x m x 3) colored image
- 3 representa as cores da camada RGB
- Convulational Layer
- Varios grupos / Camadas Convulacionais
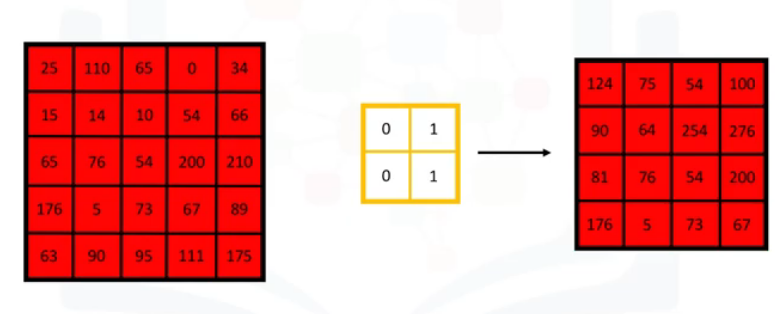
- Filters
- Define filtros e em seguida computar o convulacional entre o filtro e cada camada RGB
- + Filtro indica Melhor preservação de espaço dimencional
- Por que não fazer um flatten desses filtros ?
- Nesse caso teriamos (n x m ) x 1 como vetor de input
- Muitos parametros para se otimizar
- Computacionalmente custoso
- Pode causar overfit
- [ Nova Matriz ] Filter x Pixels Sobrepostos
- No exemplo é apresentado o calculo do produto para o filtro R (red). Mas os demais calculos são iguais.
- Após o calculo move-se 1 passo (stride) até preencher
- ReLU
- Apenas valores positivos
- Negativo se transforma em 0
- Pooling Layers
- Objetivo principal
- Tipos Principais
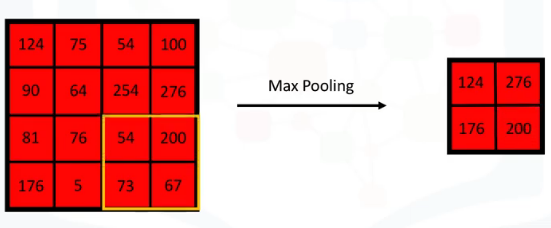
- Max Pooling > Mais comum
- Para cada stride, mantem o maior valor
- Spatial Variance
- Possibilita melhor reconhecimento
- Objeto não precisa ser identico ao comparado
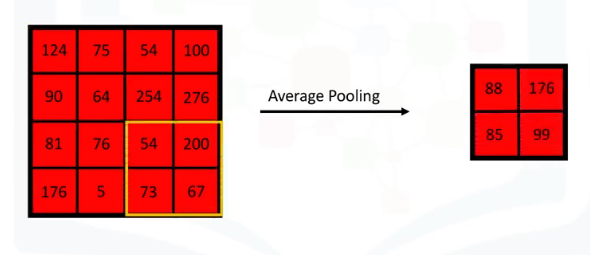
- Avarage Pooling
- Média de cada área em cada passo
- Max Pooling > Mais comum
- Objetivo
- Reduzir a dimenção espacial da propagação de dados correndo na network
- Fully- Connected Layer
- Último layer
- Flatten do output do ultimo layer da CNN
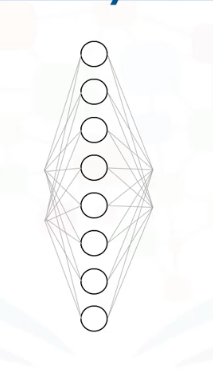
- Conecta cada nó atual com o prox layer
- Input é o output do layer anterior
- Pode ser ReLU, Pooling
- Output
- N-dimensional layer
- N representa o numero de classes possiveis para o problema. Exemplo para classificar digitos, seria 10 dimensões [ 0 .. 9 ]
- N-dimensional layer
- Keras
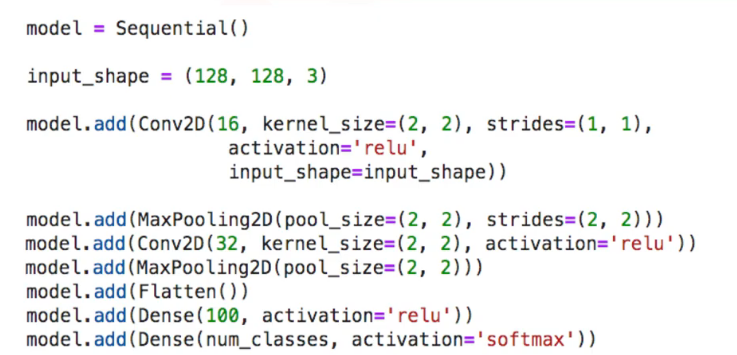
- Explicação do algoritmo vinda do curso =============================== "Training and testing of a convolutional neural network are the same as what we have seen so far. So to begin with, we use the sequential constructor to create our model. Then, we define our input to be the size of the input images. Assuming the input images are 128 by 128 color images, we define the input shape to be a tuple of (128, 128, 3). Next, we start adding layers to the network. We start with a convolutional layer, with 16 filters, each filter being of size 2x2 and slides through the image with a stride of magnitude 1 in the horizontal direction, and of magnitude 1 in the vertical direction. And the layer uses the ReLU activation function. Then, we add a pooling layer and we're using max-pooling here with a filter or pooling size of 2 and the filter slides through the image with a stride of magnitude 2. Next, we add another set of convolutional and pooling layers. The only difference here is we are using more filters in the convolutional layer, actually twice as many filters as the first convolutional layer. Finally, we flatten the output from these layers so that the data can proceed to the fully connected layers. We add another dense layer with 100 nodes and an output layer that has nodes equal to the number of classes in the problem at hand. And we use the softmax activation function in order to convert the outputs into probabilities"
Recurrent Neural Network (RNN)
- Até o momento só foi apresentado modelos que analizam os dados como instancias independentes.
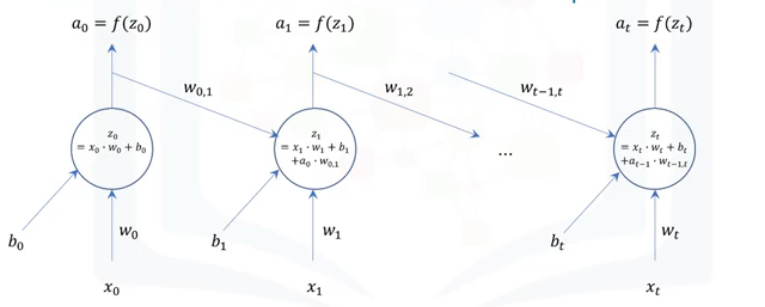
- NN com Loops
- Não apenas um input por vez
- Output da ultima entrada como input
- Exemplos
- LSTM ( Long Short-Term Memory Model)
- Geração Imagem
- Geração de letra de mão
- Legenda Auto. em Imagens
- Descrição Auto em Videos
- LSTM ( Long Short-Term Memory Model)
Não Supervisionado
- Autoencoding
- Compression / Decompression Fun. aprendidas auto. a partir dos dados
- Dados especificos
- Se treinou para carro, só vai pra essa área
- Backpropagation
- Tenta prever sem nenhum rótulo
- Fun. Ativação não linear
- Exemplo
- RBMs ( Restricted Boltzmann Machines
- "Arruma" datasets desbalanceados
- Estimativa de valores faltantes de diferentes features
- Extração de Feautures para data desestruturada
- RBMs ( Restricted Boltzmann Machines
- Autoencoding
Bilder und Dateien der Mindmap
Informationen
- Beschreibung
- EDX - Introduction to Deep Learning (Deep Learning) Mindmap am Deep Learning - Modulo IV, erstellt von Rafael Lucas Souza Altar Baiolim am 02/01/2019.
- Erstellt von
- Rafael Lucas Souza Altar Baiolim
- Aufrufe
- 1
- Verlauf
-
- Erstellt von Rafael Lucas Souza Altar Baiolim · 31 Dez 2018
- Kopiert von Rafael Lucas Souza Altar Baiolim · 2 Jan 2019
- Bewertung