
29322752
Description

Created by Aliss Sáchez

|
Created by Aliss Sáchez
over 5 years ago
|
|
Analizador
Léxico.
- Analizador léxico también conocido como analizador
morfólogico o scanner, es el elemento del compilador de la
division del codigo fuente en un conjunto de unidades
sintácticas con sentido lógico.
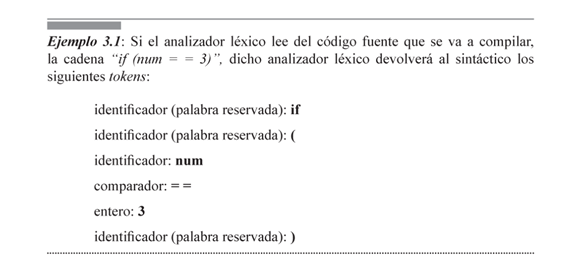
- Que es un token: URL:
https://www.cartagena99.com/recursos/alumnos/apuntes/ININF2_M4_U2_T1.pdf
- Tipos de tokens posibles: URL:
https://elibro.net/es/ereader/umg/106460
- Palabras reservadas del
sistema.
- Identificadores.
- Literales.
- Números.
- Operadores y símbolos
operacionales.
- Palabras reservadas del
sistema.
- Tipos de tokens posibles: URL:
https://elibro.net/es/ereader/umg/106460
- Formas de interaccionar las
fases léxicas y sintácticas,
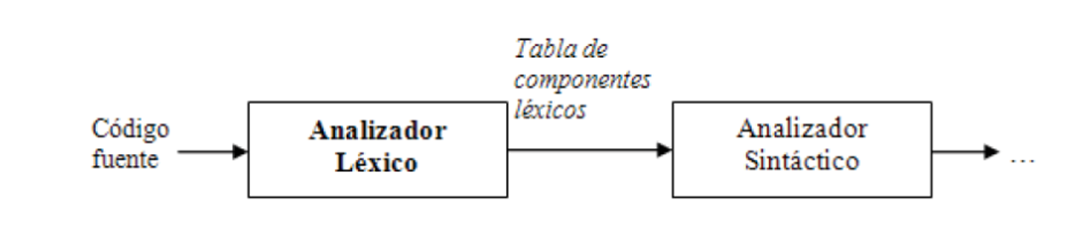
- El analizador léxico opera a
petición del analizador sintáctico.
- La fase léxica puede hacer un análisis de
todos los componentes léxicos del código
fuente.
- El analizador léxico opera a
petición del analizador sintáctico.
- Que es un token: URL:
https://www.cartagena99.com/recursos/alumnos/apuntes/ININF2_M4_U2_T1.pdf
- Responsabilidad de un analizador léxico como
fase de un compilador
- En esta fase de compilación lo principal será leer la
secuencia de caracteres del programa fuente, carácter por
carácter, y agruparlos.
- En esta fase de compilación lo principal será leer la
secuencia de caracteres del programa fuente, carácter por
carácter, y agruparlos.
- ¿Por qué separar el análisis léxico
del análisis sintáctico?
- Primero: Si la fase del análisis léxico y
sintáctico se encuentran separadas, bien en
clases diferentes, bien en objetos distintos o
simplemente en métodos o subprogramas
distintos podremos realizar modificaciones
en la especificación léxica o sintáctica del
código fuente .
- Segundo: el diseño y la
implementación de las distintas
fases del compilador serán mas
simples, a la vez que mas
eficientes.
- Tercero: separar el análisis léxico del
sintáctico nos permitirá centralizar, en
un único módulo o clase, la lectura fisica
de los caracteres, lo que facilita
tratamientos especializados de E/S
- Primero: Si la fase del análisis léxico y
sintáctico se encuentran separadas, bien en
clases diferentes, bien en objetos distintos o
simplemente en métodos o subprogramas
distintos podremos realizar modificaciones
en la especificación léxica o sintáctica del
código fuente .
- Tratamiento De Los Errores Léxicos
- Normalmente los errores durante
esta etapa son escasos, ya que el
compilador tiene todavía una
visión muy local del programa.
- Los errores léxicos se pueden
agrupar entre los siguiente:
- Símbolos no
permitidos.
- Identificadores mal
construidos.
- Valores numéricos
mal construidos.
- Constante literal
mal construida.
- Al detectar un final de
archivo a la mitad de
un componente léxico.
- Símbolos no
permitidos.
- Los errores léxicos se pueden
agrupar entre los siguiente:
- alternativas para el tratamiento
de errores en analizadores
léxicos.
- Ignorar los caracteres no validos
hasta formar un token aceptado.
- Borrar los caracteres
inválidos
- Insertar un carácter
que pudiera ser
necesario.
- Reemplazar un carácter
incorrecto o reemplazar
caracteres adyacentes
- Ignorar los caracteres no validos
hasta formar un token aceptado.
- Normalmente los errores durante
esta etapa son escasos, ya que el
compilador tiene todavía una
visión muy local del programa.
- Definición Del Vocabulario
Básico Para Un Analizador
Léxico.
- Componente léxico o token: Son
los elementos del lenguaje con
sentido lógico propio.
- Lexema: Secuencia de caracteres del
código fuente que concuerda con el
patrón de un token.
- Tabla de componentes léxicos o tablas de
tokens: estructura de datos donde se
almacenan los tokens.
- Atributos de los componentes léxicos: Es la
información adicional sobre los tokens, (el
número de atributos y la forma de
implementar las distintas fases del compilador.
- Alfabeto: Es un conjunto
finito y no vacío de
símbolos.
- Cadena: secuencia finita de símbolos
- Cadena vacía:
- Operación de cadenas o
palabras.
- Longitud:: es el numero de símbolos que
forman la cadena.
- Concatenación
- Igualdad de
cadenas.
- Potencia de
cadenas.
- Longitud:: es el numero de símbolos que
forman la cadena.
- Cadena: secuencia finita de símbolos
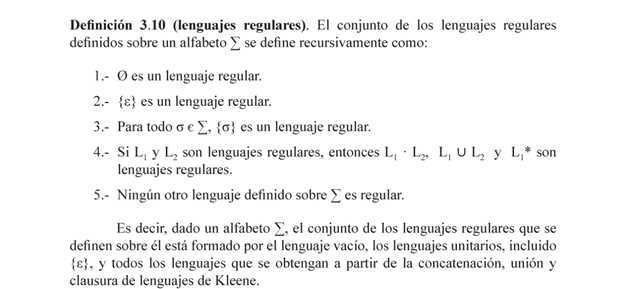
- Lenguajes regulares: ver imagen.
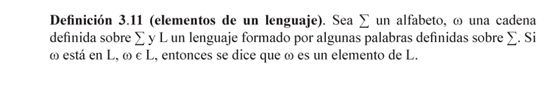
- Elementos de un lenguaje. Ver
imagen.
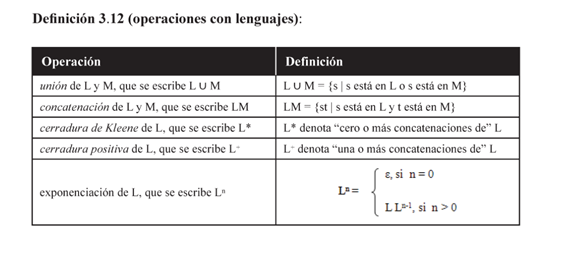
- Operaciones con lenguajes: ver imagen
- Expresiones regulades: una ER es una forma
abreviada de representar cadenas de
caracteres.
- Concatenación
- Unión.
- Cierre o
clausura.
- Concatenación
- Abreviatura en la notación: ver
imagen.
- AFD. un autómata finito
determinista.
- AFN autómata finito no
determinista.
- Diferencia entre AFN y AFD
- Equivalencia entre AFN y AFD
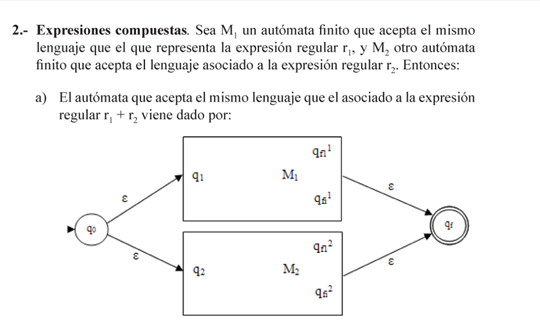
- Autómata finito no determinista con transiciones
nulas.
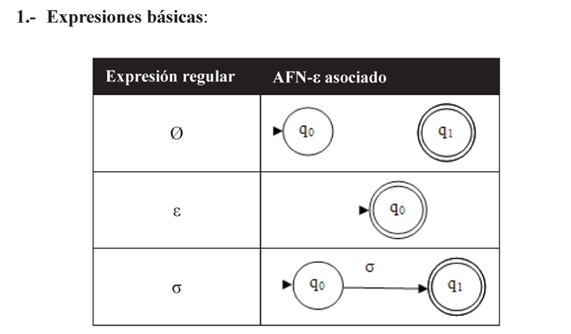
- Expresiones básicas. Ver
imagen.
- AFD. un autómata finito
determinista.
- Expresiones regulades: una ER es una forma
abreviada de representar cadenas de
caracteres.
- Operaciones con lenguajes: ver imagen
- Elementos de un lenguaje. Ver
imagen.
- Componente léxico o token: Son
los elementos del lenguaje con
sentido lógico propio.
- Especificación de un analizador
léxico.
- Existen tres métodos generales.
- Utilizar un generador de analizadores
léxicos, como el compilador LEX.
- Escribir el analizador léxico en un lenguaje
convencional de programación en sistemas.
- Escribir el analizador léxico en lenguaje ensamblador
y manejar explícitamente la lectura de la entrada.
- Utilizar un generador de analizadores
léxicos, como el compilador LEX.
- Reconocimiento de los componentes
léxicos.
- Consta de una serie de pasos a seguir
para la implementacion de un
analizador.
- Crear tabla de tokens con :
- Nombre del componente
léxico.
- Lexema de
ejemplo.
- Descriptor informal del
patrón.
- Nombre del componente
léxico.
- Construir un diagrama de
transiciones para poder
reconocer las diferentes cadenas
del código fuente.
- Para DT podemos seguir los siguientes
pasos.
- Obtener la expresión regular asociada a la
especificación del lenguaje de programación.
- De la expresión regular crearemos el AFN-e que
acepte el lenguaje asociado a dicha expresión
regular.
- Obtener el AFN equivalente al AFN-e anterior,
esto es, que acepte el mismo lenguaje.
- Transformar el AFN obtenido en un
AFD
- Minimizar el AFD resultante, que compruebe si
las cadenas de caracteres pertenecen o no al
lenguaje.
- Obtener el DT a partir del AFD. De este modo,
este s funcionará ya como un analizador léxico.
- Implementación del DT
- La interacción entre las fases léxicas y sintacticas.
- El procedimiento de identificación de palabras
reservadas del lenguaje de programación que
queremos compilar.
- Otros factores que afectan a la implementación es el
lenguaje de programación en el que la llevemos a
cabo.
- La interacción entre las fases léxicas y sintacticas.
- Obtener la expresión regular asociada a la
especificación del lenguaje de programación.
- Para DT podemos seguir los siguientes
pasos.
- Crear tabla de tokens con :
- Consta de una serie de pasos a seguir
para la implementacion de un
analizador.
- Existen tres métodos generales.
- Video de analizador
- Direcci´ñon de video URL:
https://youtu.be/zS2Bw8vOZYU
- Direcci´ñon de video URL:
https://youtu.be/zS2Bw8vOZYU
Media attachments
Want to create your own Mind Maps for free with GoConqr? Learn more.