
Mapa mental
Hive
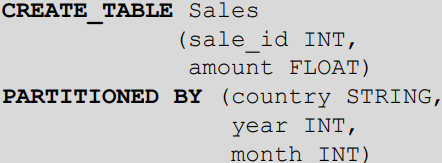
Conteúdo do mapa
Hive
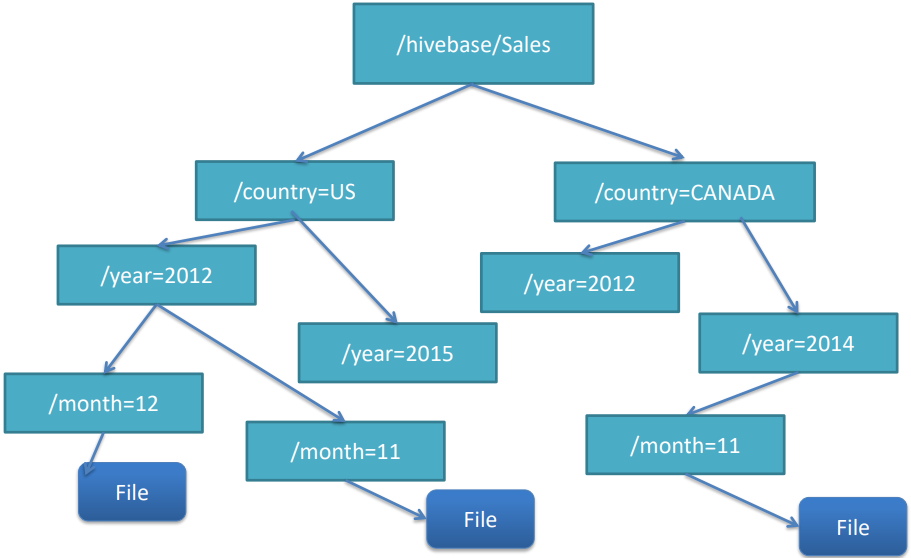
Não estamos criando uma tabela, mas sim estamos criando uma parte lógica que está apontando para um arquivo fisico -> dentro de subdiretórios
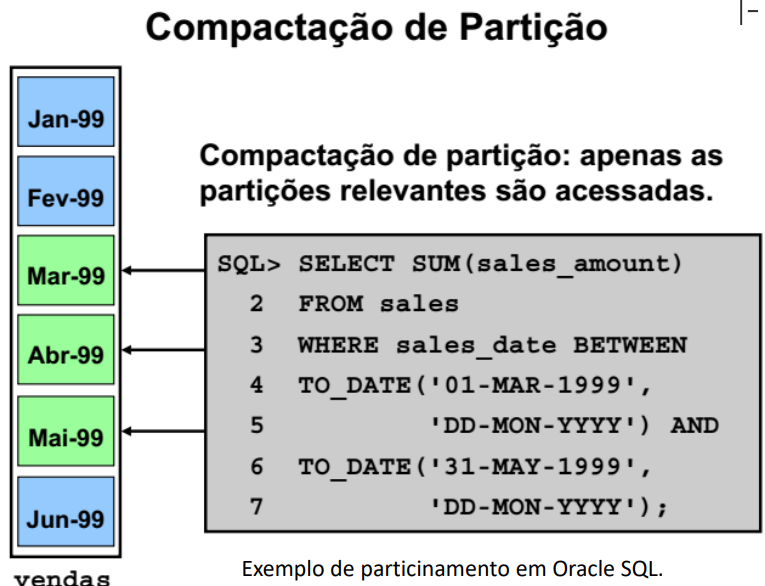
Particionamento
- Exibi dados especificos
- Os dados de cada partição será dividida em subpartições denominadas de buckets. Que é armazenado em um arquivo no diretório particionado.
- Buckets
- Os dados de cada partição será dividida em subpartições denominadas de buckets. Que é armazenado em um arquivo no diretório particionado.
- Exibi dados especificos
Utilizado para -> • Processamento de Logs • Mineração de texto • Indexação de documentos • Business analytics • Modelos Preditivos
É um data warehouse escalável e tolerante a falhas, É um sistema para processamento em batch
- Xnão é: Um banco de dados relacional , (OLTP), Uma linguagem para consultas em tempo real e atualizações de linhas
- O hive é APENAS para DADOS ESTRUTURADOS. Os dados semi-estruturados, em XML devem ser transformados para serem utilizados
- Xnão é: Um banco de dados relacional , (OLTP), Uma linguagem para consultas em tempo real e atualizações de linhas
Comandos
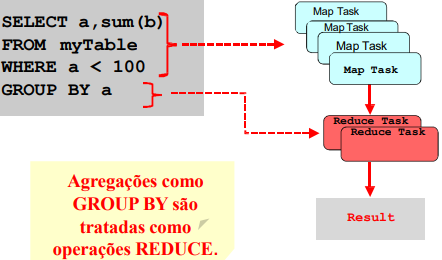
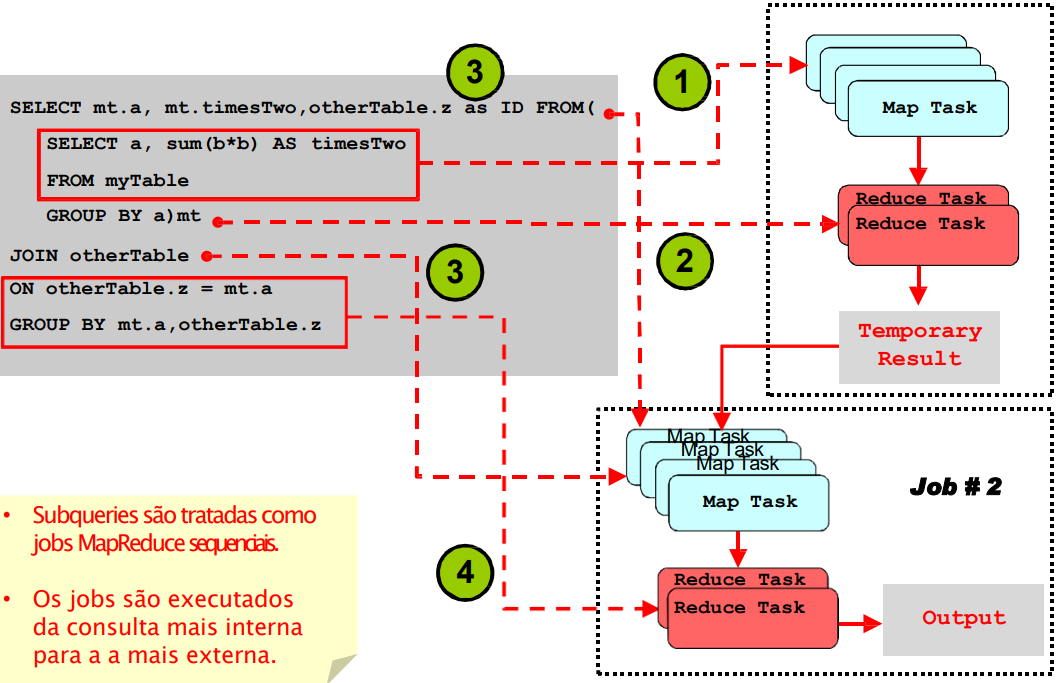
- Para fazer o insert, é necessário fazer todas as operações de map reduce
- Manipulação de dados -> aninhada
- 1. (2) Como criar o banco de dados no hive
- 1. create database nome;
- 2. use database;
- 2 Verificar se foi criado
- 2. criar as tabelas no hive
- create table nome ( col1 STRING, col2 STRING, col3 STRING ) ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.OpenCSVSerde' TBLPROPERTIES("skip.header.line.count"="1");
- parâmetro skip.header.line.count para pular o (cabeçalho do CSV)
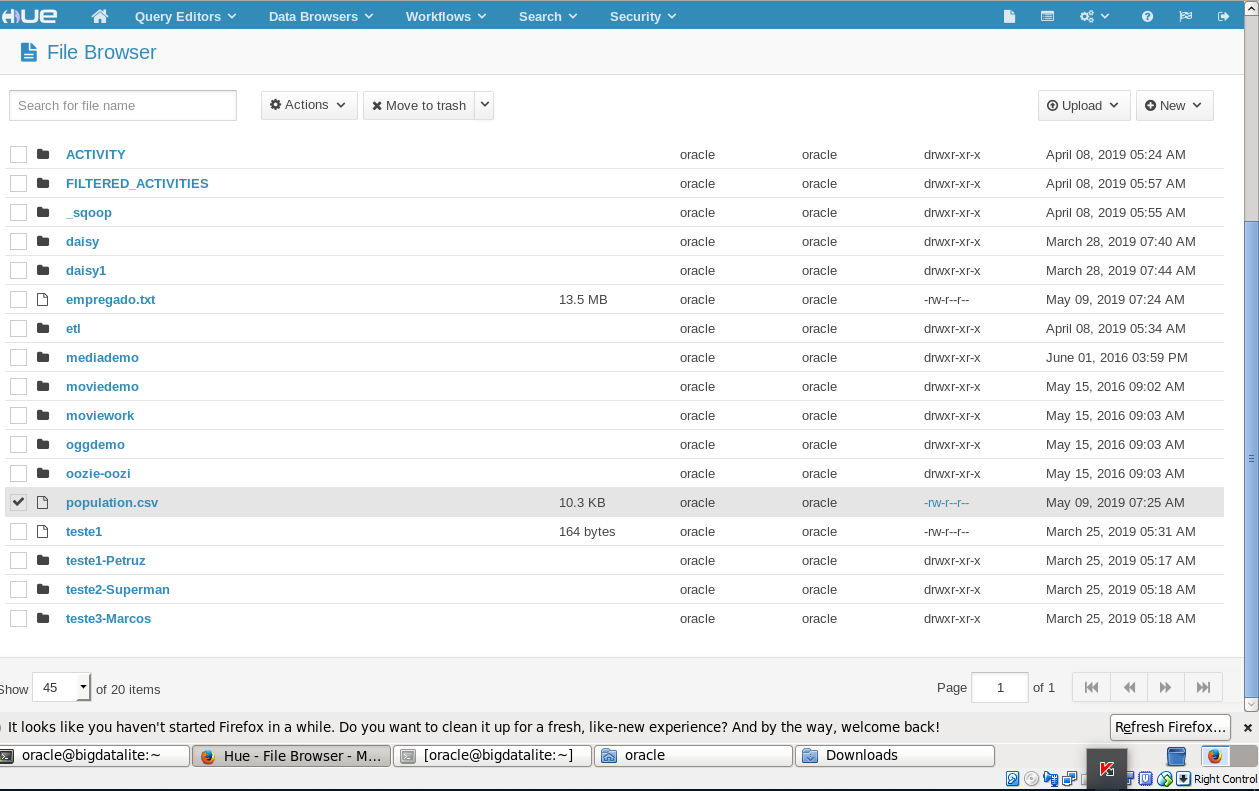
- 3. LOAD dos dados para a tabela Hive
- *"LOCAL: " lê de um diretório local no servidor. *OVERWRITE: Se quisermos ler de um diretório HDFS precisaremos remover a palavra-chave “LOCAL”. "OVERWRITE" informa que queremos substituir os dados existentes. Se não a informamos, os novos dados serão anexados aos dados existentes.
- LOAD DATA LOCAL INPATH '/home/oracle/Downloads/mllatest/nomedoarquivo.csv' OVERWRITE INTO TABLE nomedoarquivo_tmp;
- 4. Converta os dados das tabelas temporárias para as tabelas definitivas
- Já importamos os dados para as tabelas HIVE, agora iremos criar as tabelas reais em formato ORC. O hive aceita vários formatos
- CREATE TABLE ratings STORED AS ORC AS SELECT userid, CAST(movieid AS BIGINT) movieid, CAST(rating AS DECIMAL) rating, CAST(rating_timestamp AS BIGINT) rating_timestamp FROM ratings_tmp;
- 5. Consulte os primeiros 10 elementos de cada tabela.
- 5. Consulte os primeiros 10 elementos de cada tabela.
- create table nome ( col1 STRING, col2 STRING, col3 STRING ) ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.OpenCSVSerde' TBLPROPERTIES("skip.header.line.count"="1");
- 2. use database;
- 1. create database nome;
- 2. Como importar dados para o hive
- 1. LOAD
- 2. Opcionais: Pig, External tables
- 3. OPENCSVSERDE -> ler arquivos CSV. para ler e escrever dados em qualquer formato customizado
- OPENCSVSERDE trata todas as colunas como STRING, então iremos criar tabelas temporárias e carregar dados nessas tabelas utilizando o OPENCSVSERDE para então converter as colunas das tabelas para os tipos de dados adequados
- 1. LOAD
Atenção ele Xnão faz consulta -> ele gera relatórios
Imagens e arquivos do mapa
Informações
- Descrição
- Mapa Mental sobre Hive, criado por Millena Dias em 09-05-2019.
- Criado por
- Millena Dias
- Visualizações
- 0
- Avaliação