
Fluxograma
Sem título
Conteúdo do fluxograma
CAPITULO 7: Muestreo y distribuciones muestrales
En este capítulo se estudiará el muestreo aleatorio simple y el proceso de selección de muestras. Se verá también cómo se usan estadísticos como la media muestral y la proporción muestral para estimar la media de la población y la proporción de la población
Una población es el conjunto de todos los elementos que interesan en un estudio
Una muestra es un subconjunto de la población.
A las características numéricas de una población, como la media y la desviación estándar, se les llama parámetros.
El principal propósito de la inferencia estadística es hacer estimaciones y pruebas de hipótesis acerca de los parámetros poblacionales usando la información que proporciona una muestra.
7.1 El problema de muestreo de Electronics Associates
Una media muestral suministra una estimación de la media poblacional y una proporción muestral suministra una estimación de la proporción poblaciona
Con las estimaciones puede esperarse un cierto error de estimación.
EJEMPLO
Al director de personal de Electronics Associates, Inc. (EAI), se le ha encargado la tarea de elaborar un perfil de los 2500 administradores de la empresa. Las características a determinar son el sueldo medio anual de los administradores y la proporción de administradores que ha terminado el programa de capacitación de la empresa.
Media poblacional: Desviacion estándar poblacional: μ = $51 800 σ =$4000
Si p denota la proporción de la población que ha terminado el programa de capacitación, se tiene que p = 1500/2500 = 0.60
La media poblacional de los sueldos anuales (μ = $51 800), la desviación estándar poblacional de los sueldos anuales (σ = $4000) y la proporción poblacional de quienes han terminado el programa de capacitación (p = 0.60)
Para explorar la posibilidad de usar una muestra para el estudio de EAI, primero se considerará cómo determinar una muestra de 30 administradores.
7.2 Muestreo aleatorio simple
La definición de muestreo aleatorio simple y del proceso de seleccionar una muestra aleatoria simple dependen de si la población es finita o infinita.
Como el problema de muestreo de EAI tiene una población finita de 2500 administradores, primero se considera el muestreo de una población finita.
Muestreo de una población finita
Una muestra aleatoria simple de tamaño n de una población finita de tamaño N es una muestra seleccionada de manera que cada posible muestra de tamaño n tenga la misma probabilidad de ser seleccionada
Un procedimiento para seleccionar una muestra aleatoria simple de una población finita es elegir los elementos para la muestra de uno en uno, de manera que, en cada paso, cada uno de los elementos que quedan en la población tenga la misma probabilidad de ser seleccionad
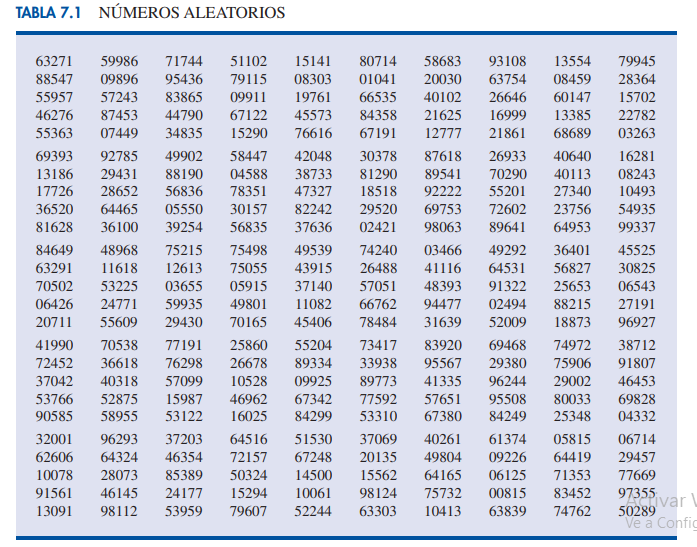
la lista de la población de administradores de EAI, 2500, tiene cuatro dígitos, se seleccionarán números aleatorios de la tabla en conjuntos o grupos de cuatro dígitos
Los primeros 7 números aleatorios de cuatro dígitos son Los números aleatorios en la tabla aparecen en grupos de cinco para facilitar su lectura. 6327 1599 8671 7445 1102 1514 1807
El segundo número, 1599, está entre 1 y 2500. Por tanto, el primer administrador seleccionado para la muestra aleatoria es el administrador que tiene el número 1599 en la lista de los administradores de EAI
Como no se quiere seleccionar a un administrador más de una vez, cualquier número aleatorio que ya ha sido usado se ignora, porque el administrador correspondiente ya se ha incluido en la muestra. A este tipo de selección se le conoce como muestreo sin reemplazo.
Cuando se selecciona una muestra en la que se acepten números aleatorios ya usados y los administradores correspondientes sean incluidos dos o más veces, se está muestreando con reemplazo
Muestreo de una población infinita
Una muestra aleatoria simple de una población infinita es una muestra seleccionada de manera que se satisfagan las condiciones siguientes.
1. Cada uno de los elementos seleccionados proviene de la población. 2. Cada elemento se selecciona independientemente.
En algunas situaciones la población o bien es infinita o tan grande que, para fines prácticos, se considera infinita. Por ejemplo, suponga que un restaurante de comida rápida desea obtener el perfil de su clientela. El proceso continuo de clientes que visitan el restaurante puede verse como que los clientes provienen de una población infinita
Las poblaciones infinitas suelen asociarse con un proceso que opera continuamente a lo largo del tiempo. Por ejemplo, partes fabricadas en una línea de producción, transacciones en un banco, llamadas que llegan a un centro de asesoría técnica y clientes que entran en las tiendas son considerados como provenientes de una población infinita.
En tales casos un procedimiento de muestreo creativo garantiza que no haya sesgos de selección y que los elementos de la muestra sean seleccionados en forma independiente

7.3 Estimación puntual
Para estimar el valor de un parámetro poblacional, la característica correspondiente se calcula con los datos de la muestra, a lo que se le conoce como estadístico muestral
Por ejemplo, para estimar la media poblacional μ y la desviación estándar poblacional σ de los salarios anuales de los administradores de EAI
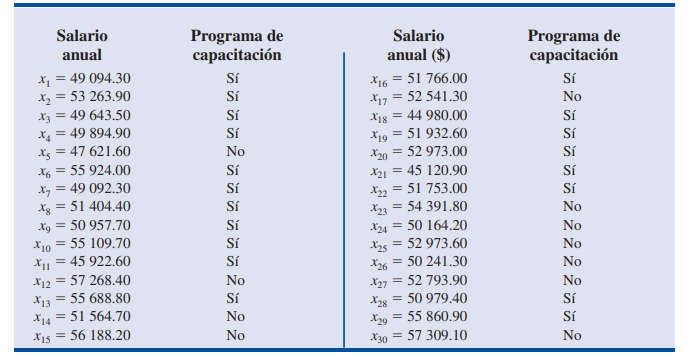
SALARIOS ANUALES Y SITUACIÓN RESPECTO AL PROGRAMA DE CAPACITACIÓN DE LOS ADMINISTRADORES PERTENECIENTES A UNA MUESTRA ALEATORIA SIMPLE DE 30 ADMINISTRADORES DE EAI
PASOS
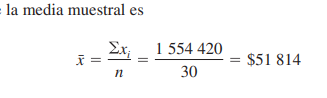
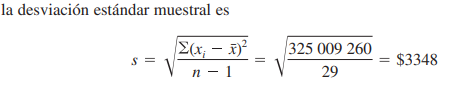
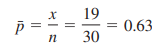
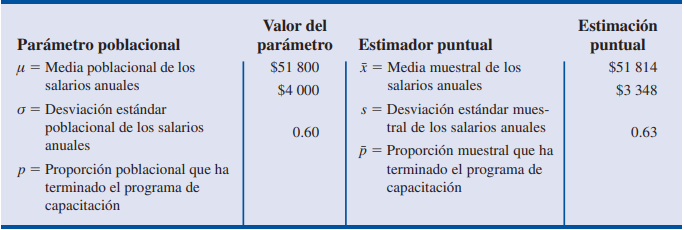
se lleva a cabo el proceso estadístico conocido como estimación puntual. A la media muestral se le conoce como el estimador puntual de la media poblacional μ, a la desviación estándar muestral s como el estimador puntual de la desviación estándar poblacional σ y a la proporción muestral como el estimador puntual de la proporción poblacional p.
Al valor numérico obtenido de , s, o se les conoce como estimaciones puntuales. Así, en la muestra aleatoria simple de 30 administradores de EAI que se presenta en la tabla 7.2, $51 814 es la estimación puntual de μ, $3 348 es la estimación puntual de σ y 0.63 es la estimación puntual de p.
, las estimaciones puntuales difieren un poco de los correspondientes parámetros poblacionales. Estas diferencias son de esperarse ya que para elaborar las estimaciones muestrales se usa una muestra, y no un censo de toda la población
7.4 Introducción a las distribuciones muestrales
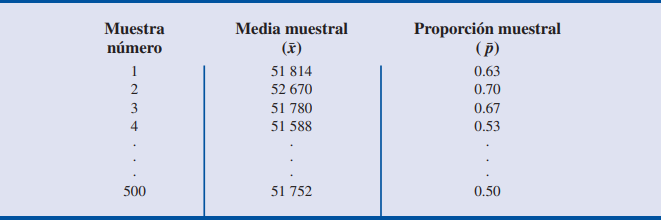
En la muestra aleatoria simple de los 30 administradores de EAI que se presenta en la tabla 7.2, la estimación puntual de μ es = $51 814 y la estimación puntual de p es =0.63. Suponga que se selecciona otra muestra aleatoria simple de 30 administradores de EAI y se obtienen las estimaciones puntuales siguientes:
Media muestral: Proporción muestral: x¯ = $52 670 p¯ = 0.70
se muestra una parte de los resultados obtenidos en 500 muestras aleatorias simples y en la tabla 7.5 las distribuciones de frecuencias y distribuciones de frecuencias relativas de los valores de las 500 .
se muestra el histograma de las frecuencias de los valores de la media muestral
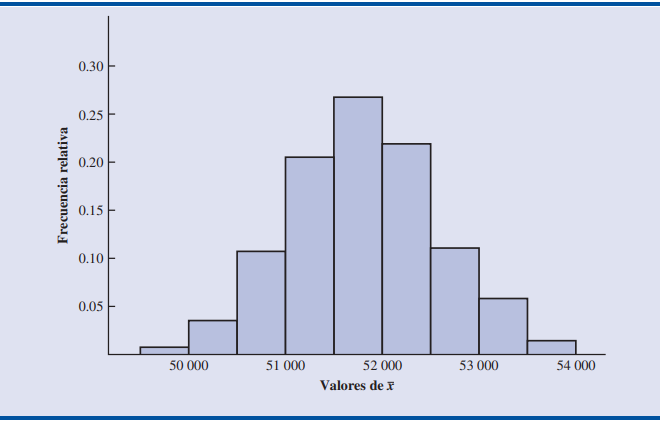
la media muestral es una variable aleatoria. Entonces, como ocurre con otras variables aleatorias, tiene una media o valor esperado, una desviación estándar y una distribución de probabilidad. Como los distintos valores que toma son resultado de distintas muestras aleatorias simples, a la distribución de probabilidad de se le conoce como distribución muestral de la media muestral
7.5 Distribución muestral de la media muestral
La distribución muestral de es la distribución de probabilidad de todos los valores de la media muestral .
En esta sección se describen las propiedades de la distribución muestral de . Como ocurre con otras distribuciones de probabilidad estudiadas, la distribución muestral de tiene un valor esperado, una desviación estándar y una forma característica. Para empezar se considerará la media de todos los valores de , a la que se conoce como valor esperado de la media muestral
Valor esperado de x
El valor esperado de x¯ es igual a la media de la población de la que se tomó la muestra
Desviación estándar de x
Ahora se definirá la desviación estándar de la distribución muestral de . Se empleará la notación siguiente. Es posible demostrar que usando el muestreo aleatorio simple, la desviación estándar de depende de si la población es finita o infinita. Las dos fórmulas para la desviación estándar son las siguientes. x¯ σx¯ = σ = n = N = desviación estándar de x¯ desviación estándar de la población tamaño de la muestra tamaño de la población
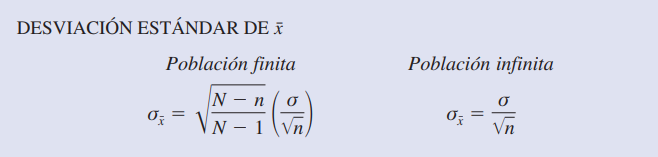
En muchas de las situaciones prácticas de muestreo, se encuentra que aunque la población sea finita, es “grande”, mientras que el tamaño de la muestra es “pequeño”. En estos casos el factor de corrección para una población finita es casi igual a 1. Por tanto, la diferencia entre el valor de la desviación estándar de en el caso de poblaciones finita o infinitas se vuelve despreciable.
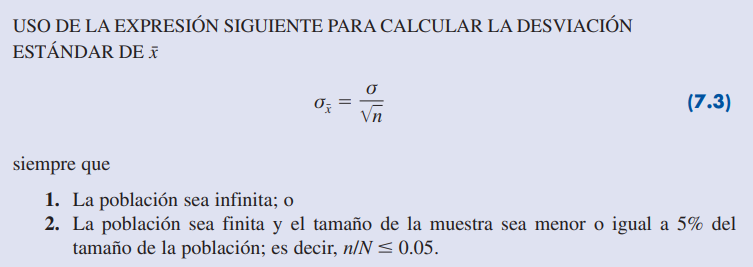
el término error estándar se refiere a la desviación estándar de un estimador puntual. Más adelante se verá que el valor del error estándar de la media ayuda a determinar qué tan lejos puede estar la media muestral de la media poblacional
Forma de la distribución muestral de x
El paso final en la identificación de las características de la distribución muestral de es determinar la forma de la distribución muestral. Se considerarán dos casos: 1. La población tiene distribución normal, y 2. La población no tiene distribución normal.
La población tiene distribución normal. En muchas situaciones es razonable suponer que la población de la que se seleccionó la muestra aleatoria simple tenga distribución normal o casi normal. Cuando la población tiene distribución normal, la distribución muestral de está distribuida normalmente sea cual sea el tamaño de la muestra
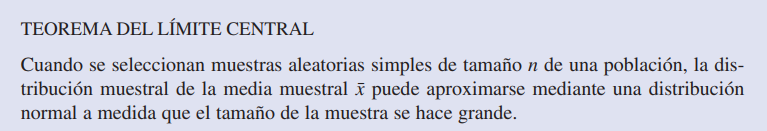
La población no tiene distribución normal. Cuando la población de la que se tomó la muestra aleatoria simple no tiene distribución normal, el teorema del límite central ayuda a determinar la forma de la distribución muestral de . El enunciado del teorema del límite central aplicado a la distribución muestral de dice lo siguiente.
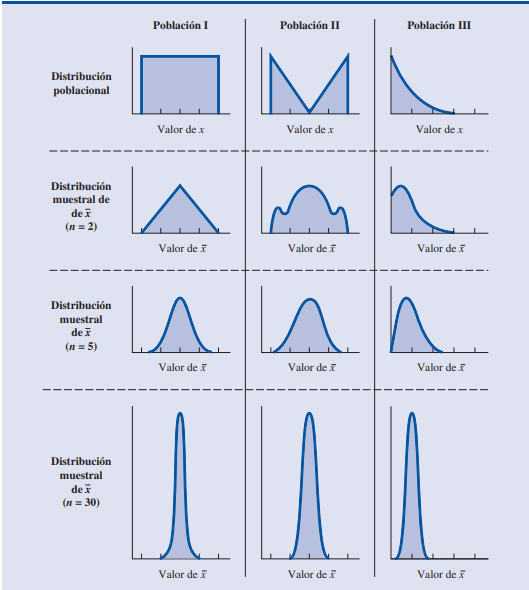
se muestra cómo funciona el teorema del límite central en tres poblaciones diferentes; cada columna se refiere a una de las poblaciones. En el primer renglón de la figura se muestra que ninguna de las tres poblaciones está distribuida normalmente. La población I tiene una distribución uniforme. A la población II se le conoce como distribución en forma de orejas de conejo. Esta distribución es simétrica, pero los valores más probables se encuentran en las colas de la distribución. La forma de la población III se parece a una distribución exponencial; es sesgada a la derecha.
7.6 Distribución muestral de p _
la proporción muestral es una variable aleatoria y su distribución de probabilidad se conoce como distribución muestral de ¯.p.La proporción muestral es el estimador puntual de la proporción poblacional p. La fórmula para calcular la proporción muestral es
Valor esperado de p
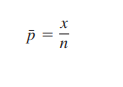
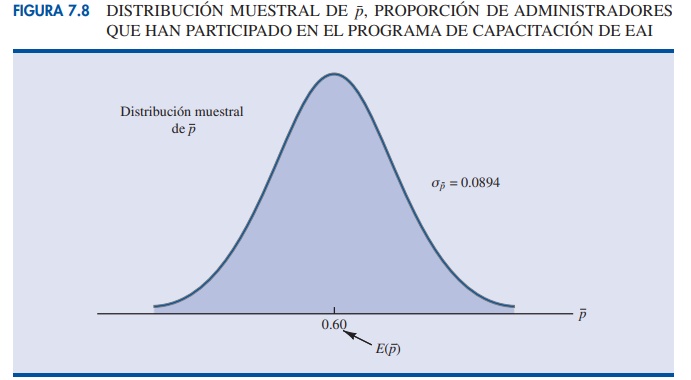
Como E( ) p, es un estimador insesgado de p. Recuerde que en la sección 7.1 se encontró que en la población de EAI p 0.60, siendo p la proporción de la población de administradores que han participado en el programa de capacitación de la empresa. Por tanto, el valor esperado de en el problema de muestreo de EAI es 0.60.
Forma de la distribución muestral de p _ Ahora que se conoce la media y la desviación estándar de la distribución muestral de , el último paso es determinar la forma de la distribución muestral. La proporción muestral es x/n. En una muestra aleatoria simple de una población grande, el valor de x es una variable aleatoria binomial que indica el número de los elementos de la muestra que tienen la característica de interés.
Valor práctico de la distribución muestral de p _ El valor práctico de la distribución muestral de es que permite obtener información probabilística acerca de la diferencia entre la proporción muestral y la proporción poblacional.
7.7 Propiedades de los estimadores puntuales
Sin embargo, antes de usar un estadístico muestral como estimador puntual, se verifica si el estimador puntual tiene ciertas propiedades que corresponden a un buen estimador puntual. En esta sección se estudian las propiedades que deben tener los buenos estimadores puntuales: insesgadez, eficiencia y consistencia. Como hay distintos estadísticos muestrales que se usan como estimadores puntuales de sus correspondientes parámetros poblacionales, en esta sección se usará la notación general siguiente.
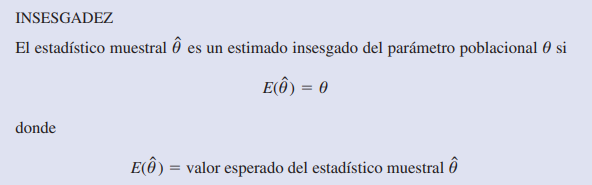
Insesgadez Si el valor esperado del estadístico muestral es igual al parámetro poblacional que se estudia, se dice que el estadístico muestral es un estimador insesgado del parámetro poblacional.
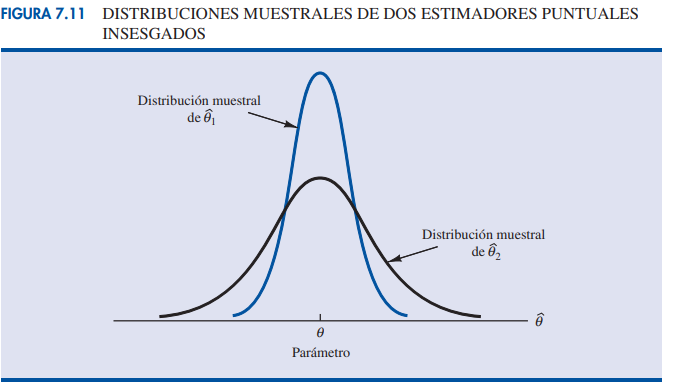
Eficiencia Suponga que se usa una muestra aleatoria simple de n elementos para obtener dos estimadores puntuales insesgados de un mismo parámetro poblacional. En estas circunstancias preferirá usar el estimador puntual que tenga el menor error estándar, ya que dicho estimador tenderá a dar estimaciones más cercanas al parámetro poblacional. Se dice que el estimador puntual con menor error estándar tiene mayor eficiencia relativa que los otros.
Consistencia La tercera propiedad relacionada con un buen estimador puntual es la consistencia. Dicho de manera sencilla, un estimador puntual es consistente si el valor del estimador puntual tiende a estar más cerca del parámetro poblacional a medida que el tamaño de la muestra aumenta. En otras palabras, una muestra grande tiende a proporcionar mejor estimación puntual que una pequeña.
7.8 Otros métodos de muestreo
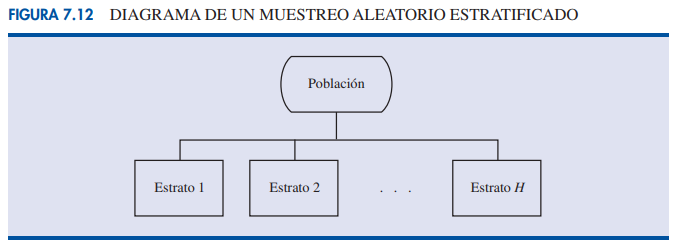
Muestreo aleatorio estratificado En el muestreo aleatorio estratificado los elementos de la población primero se dividen en grupos, a los que se les llama estratos, de manera que cada elemento pertenezca a uno y sólo un estrato. La base para la formación de los estratos, que puede ser departamento, edad, tipo de industria, etc., está a discreción de la persona que diseña la muestra. Sin embargo, se obtienen mejores resultados cuando los elementos que forman un estrato son lo más parecido posible. La figura 7.12 es un diagrama de una población dividida en H estratos.
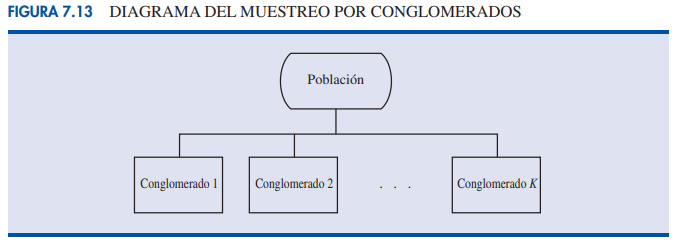
Muestreo por conglomerados En el muestreo por conglomerados los elementos de la muestra primero se dividen en grupos separados, llamados conglomerados. Cada elemento de la población pertenece a uno y sólo un conglomerado (véase figura 7.13). Se toma una muestra aleatoria simple de los conglomerados. La muestra está formada por todos los elementos dentro de cada uno de los conglomerados que forman la muestra. El muestreo por conglomerados tiende a proporcionar mejores resultados cuando los elementos dentro de los conglomerados no son semejantes. Lo ideal es que cada conglomerado sea una representación, a pequeña escala, de la población. Si todos los conglomerados son semejantes en este aspecto, tomando en la muestra un número p
Muestreo sistemático Para ciertos muestreos, en especial en aquellos con poblaciones grandes, se necesita mucho tiempo para tomar una muestra aleatoria simple (hallando primero los números aleatorios y después contando y recorriendo toda una lista de la población hasta encontrar los elementos correspondientes). Una alternativa al muestreo aleatorio simple es el muestreo sistemático.
El muestreo de conveniencia es una técnica de muestreo no probabilística. Como el nombre lo indica, la muestra se determina por conveniencia. Los elementos se incluyen en la muestra sin que haya una probabilidad previamente especificada o conocida de que sean incluidos en la muestra.
El muestreo de conveniencia es una técnica de muestreo no probabilística. Como el nombre lo indica, la muestra se determina por conveniencia. Los elementos se incluyen en la muestra sin que haya una probabilidad previamente especificada o conocida de que sean incluidos en la muestra.
Informações
- Descrição
- Fluxograma sobre Sem título, criado por Shary Delgado em 24-11-2022.
- Criado por
- Shary Delgado
- Visualizações
- 1
- Avaliação