
Mapa mental
SQOOP
Conteúdo do mapa
SQOOP
- Pode salvar comandos para serem utilizados no futuro
- https://sqoop.apache.org/docs/1.4.6/SqoopUserGuide.html
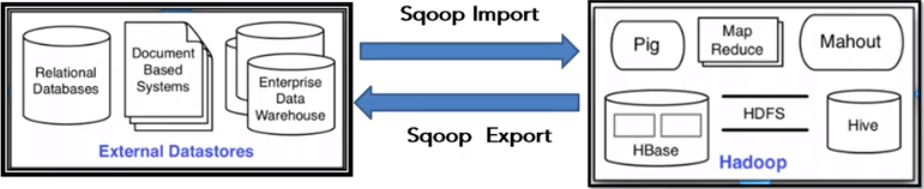
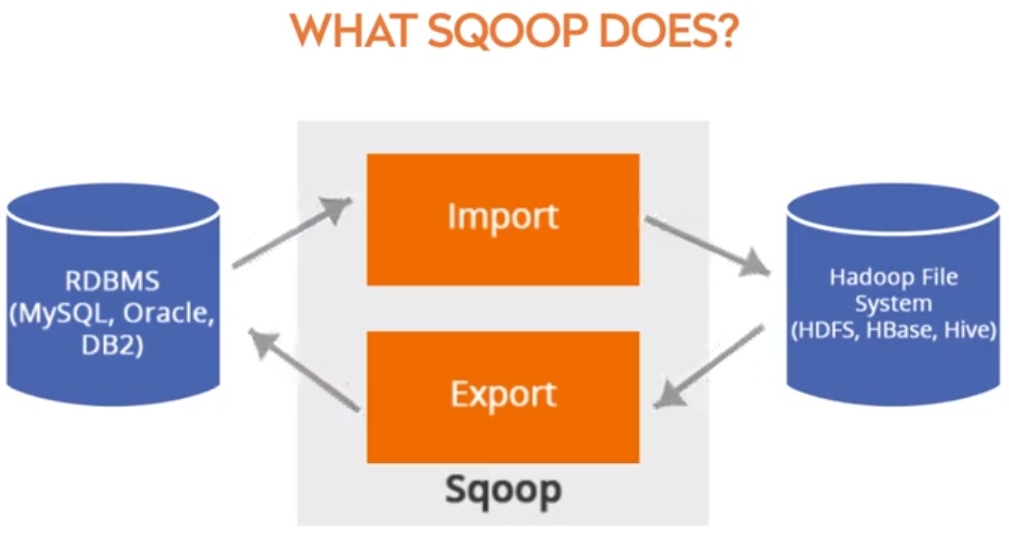
O que é? é uma ferramenta de importação e extração
- Você pode usar o Sqoop para I -> Importar dados de um SGBD Relacional (RDBMS), MySQL, Oracle ou um mainframe para o -> HDFS (Hadoop Distributed File System), <- Exportar do Hadoop de volta para um RDBMS
- Caracteristicas: O Sqoop utiliza o MapReduce para importar e exportar os dados, o que fornece operação em paralelo, bem como tolerância a falhas
- Caracteristicas: transferência bidirecional entre o Hadoop e o armazenamento externo de dados estruturados.
- MAP REDUCE
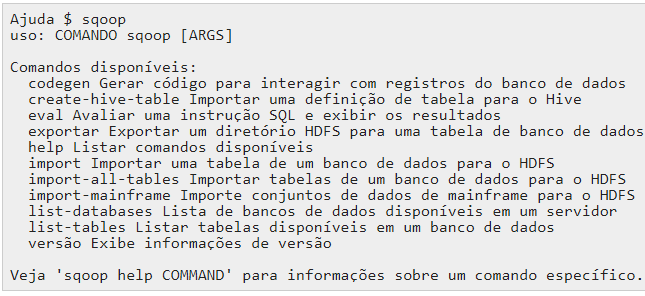
Comandos
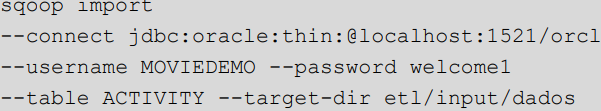
- -- connect jdbc: o banco de dados utilizado ( ex: Oracle, My SQL ) @localhost ->n° da porta/SID ->
- -- username: NOME DO SCHEMA
- -- password ( A NOSSA SENHA, OU ALGUMA RESTRIÇÃO )
- Senhas: (3)
- --passwordfile
- Definir caminho para um arquivo contendo a senha de autenticação
- Permissões de acesso concedendo restrições de leitura apenas para o proprietário do arquivo
- A cada execução do SQOOP solicitará a senha mediante o console
- -P
- chmod 400
- Definir caminho para um arquivo contendo a senha de autenticação
- --passwordfile
- -- table NOME DA TABELA
- Especificação
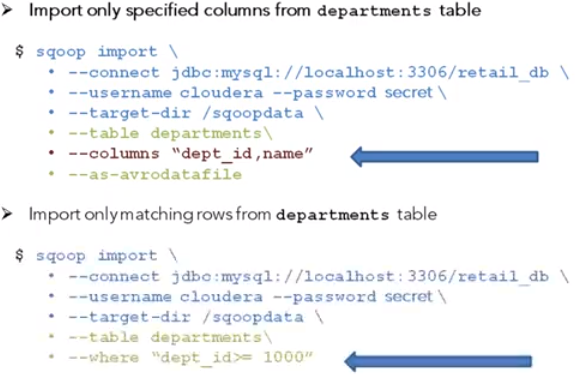
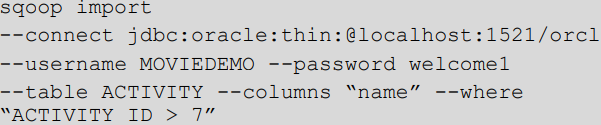
- --columns “id, cidade, pais”.
- Indicar o nome das colunas, que deverão ser importadas-> escrever o nome da coluna
- separando o nome das colunas por vírgulas
- --where
- ex: --where idade>=30
- Restringe as linhas que serão importadas
- ex: --where idade>=30
- Em Colunas binárias
- --inline-lob-limit
- Um campo é inserido na mesma linha: Quando a coluna tem um tam. de 16MB ou definida pelo comando -> --inline-lob-limit <número de bytes>
- Caso esse tamanho ultrapasse o campo será -> armazenado em um novo arquivo – de até 263 bytes cada – em um subdiretório _lobs no diretório de destino.
- --columns “id, cidade, pais”.
- --target-dir CAMINHO DO DIRETÓRIO
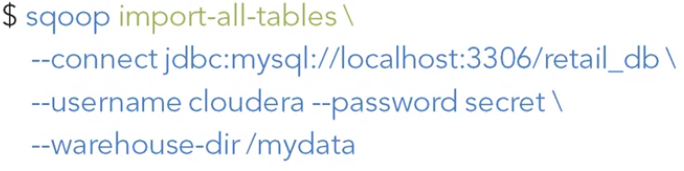
- --warehouse-dir
- Para um diretório de destino, especifico:
- Dentro do diretório especificado serão criados outros diretórios
- Para um diretório de destino, especifico:
- --warehouse-dir
- Especificação
- Senhas: (3)
- -- password ( A NOSSA SENHA, OU ALGUMA RESTRIÇÃO )
- 1 PASSO: Realizar a conexão com o banco de dados -> sqoop import / fornecer o (4) --connect, --username, --password, --table, --target-dir diretório especifico
- sqoop import /
- o Sqoop importará os dados para o HDFS em um diretório de mesmo nome da tabela de origem.
- -- username: NOME DO SCHEMA
- -- connect jdbc: o banco de dados utilizado ( ex: Oracle, My SQL ) @localhost ->n° da porta/SID ->
Como funciona
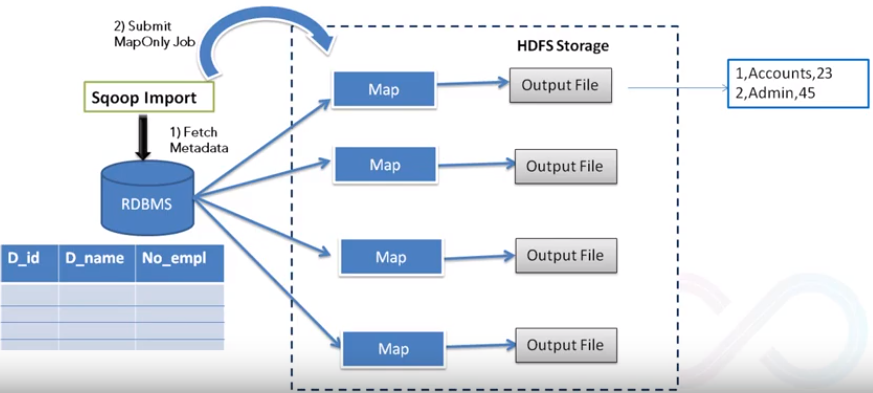
- 3 passo: Cada map cria uma conexao com o banco de dados usando o JDBC
- JDBC: permite o desenvolvedor de Java trabalhar com Java em # bancos de dados
- 1 passo: reunir os metadados
- 2 passo: O scoop divide o conjunto de dados de entrada e distribui em tarefas que são distribuidas entre os maps igualmente, para obter alto desempenho ( nessa fase estamos buscando e carregando os dados )
- Passos (4)
- 4 passo e realizar o scoop que escreve os dados no HDFS na forma de arquivos de saida
- read committed
- O Sqoop só lê dados confirmados
- ou seja, que uma transação TA leia dados modificados mas ainda não confirmados por uma transação TB.
- O Sqoop só lê dados confirmados
- 3 passo: Cada map cria uma conexao com o banco de dados usando o JDBC
1.Para o que serve (3):
- 1. Processamento de bases relacionais
- 2. Integração de bases relacionais e mainframes com dados já presentes no Hadoop
- 3. Arquivamento dos dados no Hadoop
2. Compatibilidade
- o Sqoop utiliza como padrão o JDBC (Java Database Connectivity) para se conectar aos bancos. Porém ele não garante compatibilidade com todos os tipos de bancos que utilizam JDBC devido às formas de implementação das API e diferenças do SQL de cada banco
- 3. Formato de importação(4):
- –as-textfile --sequencefile; -–as-avrodatafile; –as-parquetfile
- 4. Processo de importação
- Resumo: Extração dos metadados -> convertidos em JAVA -> criação de classes ( contém os registros de uma tabela e metodos para serialização e desseralização ) -> compilação -> e salvo na pasta/tmp.
- O nome da classe e o seu diretórios podem ser alterados e a classe compilada podem ser alterados através dos argumentos: -- class-name, --outdir e --bindir,respectivamente
- 5. Na Leitura dos registros
- Os dados podem ser modificados e confirmados por outras transações
- 6. Paralelização
- O sqoop fornece paralelização, através da distribuição de consulta SQL por meio de nós do seu cluster
- Para isso informar o nome da coluna a ser importada utilizada para dividir os dados de origem e o numeros de mappers
- Quando não informada: o sqoop escolhe a chave primária
- --split-by nome da coluna
- Para isso informar o nome da coluna a ser importada utilizada para dividir os dados de origem e o numeros de mappers
- 7. Distruibuição de tarefas (map)
- --m ou --num-mappers ( Por padrão divide em 4 maps )
- É o maior valor de uma coluna - menos o menor valor / divido por 4 maps
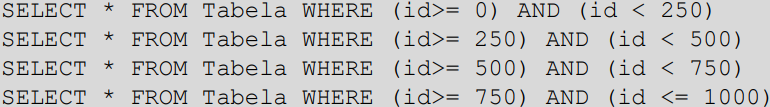
- Exemplo: Em uma coluna id em que o menor valor é 0, o maior valor é 1000 e a importação dos dados será paralelizada em quatro tarefas, o Sqoop dividirá em partes iguais ((1000 – 0 ÷ 4) = 250) dando para cada tarefa de mapeamento uma consulta SQL com um intervalo diferente
- É necessário escolher uma coluna que seja divisivel por 4 para os maps não ficarem sobrecarregados
- É o maior valor de uma coluna - menos o menor valor / divido por 4 maps
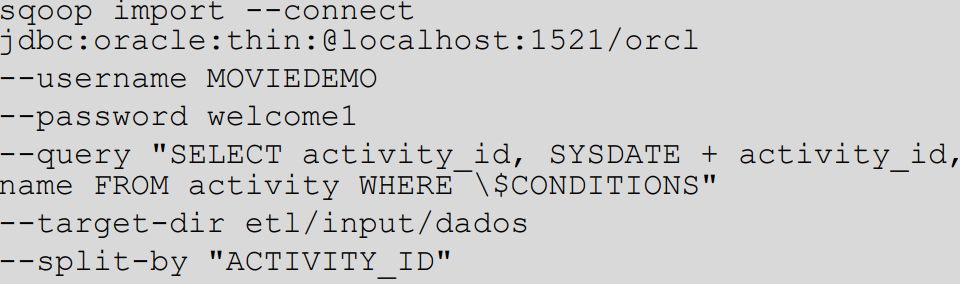
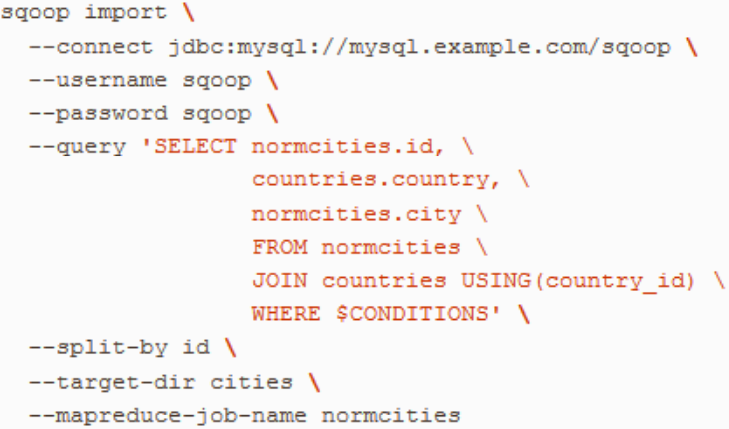
- 8. Os argumentos --table, --columns e --where pode ser substituido pelo argumento --query desde que informado
- --query -> extrai dados de diversas colunas
- --m ou --num-mappers ( Por padrão divide em 4 maps )
- O sqoop fornece paralelização, através da distribuição de consulta SQL por meio de nós do seu cluster
- Resumo: Extração dos metadados -> convertidos em JAVA -> criação de classes ( contém os registros de uma tabela e metodos para serialização e desseralização ) -> compilação -> e salvo na pasta/tmp.
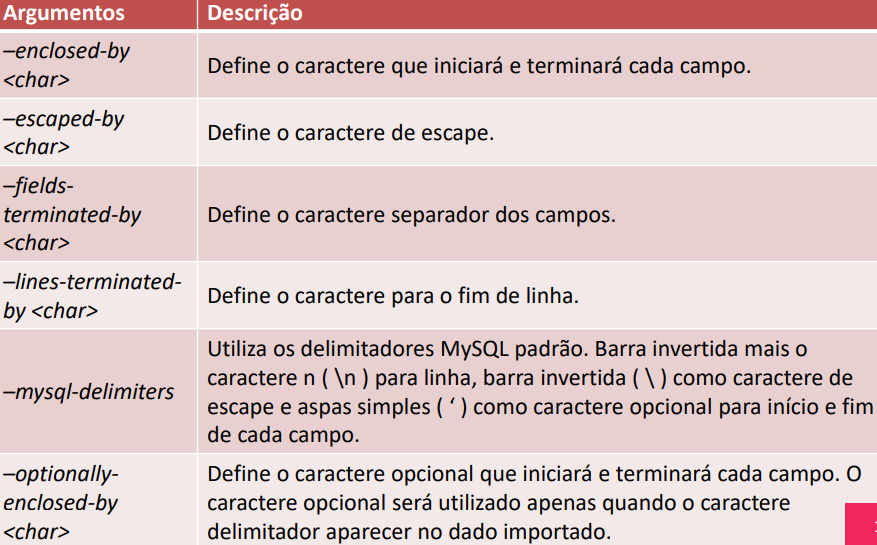
- Cada registro vira -> uma linha e as colunas -> são separadas por virgulas. Para outras formas de separação -> –fields-terminated-by
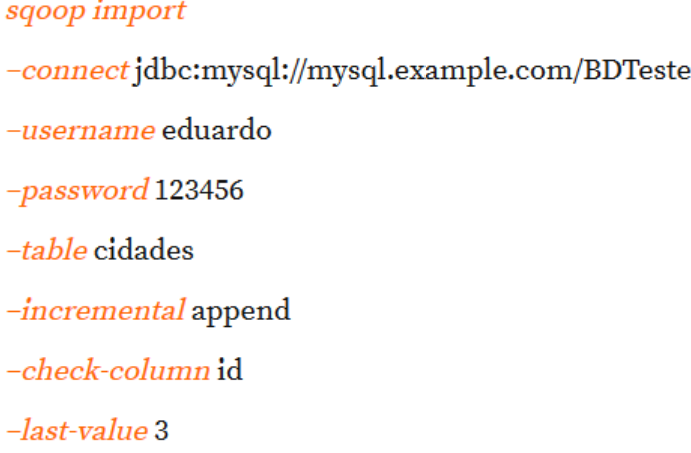
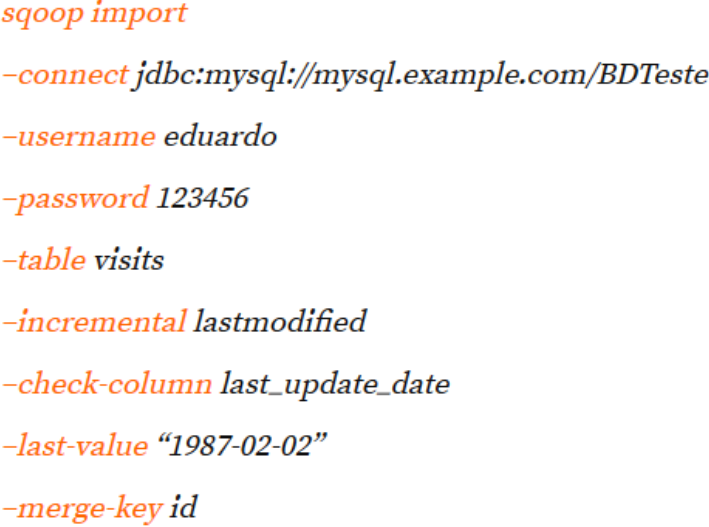
9. Importação incremental
- --incremental
- Importa apenas os dados novos da tabela.
- Tipos:
- –incremental append,
- Para dados que não sofreram UPDATE
- Informar a qual coluna será utilizada no filtro ( check column ) e último valor já importado ( last value )
- –check-column
- –last-value
- –check-column
- Informar a qual coluna será utilizada no filtro ( check column ) e último valor já importado ( last value )
- Para dados que não sofreram UPDATE
- lastmodified
- Dados que sofreram atualização
- A tabela deve – possuir uma coluna do tipo data (DATE, TIME, DATETIME ou TIMESTAMP), que é atualizada sempre que um novo registro é adicionado ou um dado existente é modificado; – possuir uma coluna composta por valores únicos, como a chave primária.
- Dados que sofreram atualização
- –incremental append,
- Tipos:
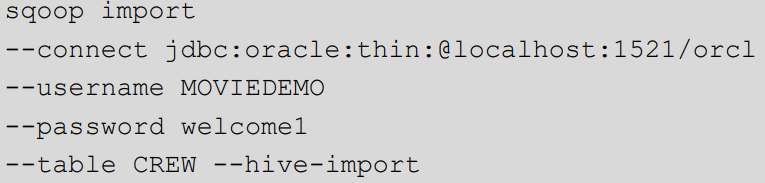
- --hive-import
- Importando diretamente do hive
Exercicio 9:
--fields-terminated-by ' ' -> Parar alterar o delimitador
- ex:
Exportação
- 1. hadoop fs -copyToLocal /user/sqoop/mysql/mappers/part-m-00000 /home/cloudera/Downloads/mimi/moeda.txt
- hadoop fs -copyToLocal o caminho que estamos utilizando e enviar p/ o S.O para isso caminho do diretório
- 2. create database -> colocar o nome do banco use -> nome do banco create table jogos select * from moeda.nome; select *from -> nome do novo banco;
- hadoop fs -copyFromLocal /home/cloudera/Downloads/mimi/moeda.txt /user/sqoop/mysql/moeda.txt
- 1. hadoop fs -copyToLocal /user/sqoop/mysql/mappers/part-m-00000 /home/cloudera/Downloads/mimi/moeda.txt
Imagens e arquivos do mapa
Informações
- Descrição
- Mapa Mental sobre SQOOP, criado por Millena Dias em 15-04-2019.
- Criado por
- Millena Dias
- Visualizações
- 0
- Avaliação