
Mapa mental
CT-AI
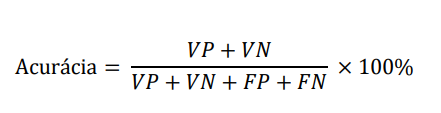
Conteúdo do mapa
CT-AI
Introdução a AI
- Definição de IA
- A capacidade de um sistema projetado para adquirir, processar e aplicar conhecimentos e habilidades.
- Efeito IA
- O que era considerado IA no passado hoje é apenas software comum.
- Categorias
- AI-estreita (Narrow AI-Ai FRACA); AI-geral(AI-forte) e AI-super (Super AI)
- Sistema conversionais e baseados em IA
- O Sistema convencional é baseado em intruções de if-else. Um sistema baseado em ia é programado para entender padrões de dados e a partir dele como deve reagir no futuro.
- Tecnologias de AI
- efsfefef
- Lógica difusa
- Lógica difusa: Quando os dados não são "0 ou 1" (ex: Quente/Frio), mas sim "mais ou menos". Uso: Sistemas de freio ABS ou controle de temperatura de ar-condicionado.:
- Técnicas de raciocínio
- Motores de Regras e Classificadores Dedutivos:
- Quando você tem regras de negócio fixas e complexas. Uso: Aprovação de crédito bancário onde a regra é: "Se salário > X e Nome Limpo, então Aprovar".
- Raciocínio Baseado em Casos (CBR)
- Resolve problemas novos baseando-se em soluções de problemas passados similares. Uso: Help desks técnicos que buscam "tickets parecidos" para sugerir uma solução.
- Raciocínio Processual
- Quando a IA deve seguir um passo a passo rigoroso. Uso: Fluxogramas de diagnóstico médico ou automação de processos industriais (RPA).
- Motores de Regras e Classificadores Dedutivos:
- Técnicas de Machine Learning
- Regressão Linear:
- Para prever um número exato. Uso: Prever o valor de um imóvel ou o tempo de execução de um teste.
- Regressão Logística
- Para prever Sim ou Não. Uso: Prever se um cliente vai cancelar a assinatura (Churn) ou se um e-mail é Spam.
- Árvores de Decisão
- Quando você quer um modelo fácil de explicar e visualizar. Uso: Decidir se um voo será atrasado baseado no clima.
- Floresta Aleatória (Random Forest)
- Quando quer mais precisão que a árvore comum, usando várias delas juntas. Uso: Predição de riscos de doenças em hospitais.
- Máquina de Suporte Vetorial (SVM):
- Excelente para classificar grupos que estão muito próximos. Uso: Reconhecimento de escrita manual ou classificação de tipos de câncer.
- Modelos Bayesianos
- Baseados em probabilidade e estatística. Uso: Filtros de spam (como o Naive Bayes que discutimos).
- Regressão Linear:
- Algoritmo de busca
- Encontrar o melhor caminho em um mapa ou jogo. Uso: Google Maps (A*) ou IAs que jogam Xadrez.
- Estruturas de Desenvolvimento AI
- Apache MxNet
- Uma estrutura de código aberto de Deep Learning utilizada pela Amazon para Amazon Web Services (AWS)
- CNTK
- O Microsoft Cognitive Toolkit (CNTK) é um kit de ferramentas de código aberto para Deep Learning
- IBM Watson Studio
- Um conjunto de ferramentas que apoiam o desenvolvimento de soluções AI
- Keras
- Uma API de código aberto de alto nível, escrita na linguagem Python, capaz de rodar sobre TensorFlow e CNTK
- PyTorch
- Uma biblioteca ML de código aberto operada pelo Facebook e utilizada em aplicativos que usam processamento de imagens e processamento de linguagem natural (PNL). É fornecido suporte para ambas as interfaces Python e C++
- Scikit-learn
- Uma biblioteca ML de código aberto para a linguagem de programação Python
- TensorFlow
- Uma estrutura ML de código aberto baseada em gráficos de fluxo de dados para Machine Learning escaláveis, fornecida pelo Google
- Apache MxNet
- Hardware para sistemas baseados em AI
- Aritmética de baixa precisão: Isto usa menos bits para cálculo (p. ex.: 8 ao invés de 32
- capacidade de trabalhar com grandes estruturas de dados
- Processamento maciçamente paralelo (simultâneo)
- Trabalhos de pequena escala as GPUs geralmente oferecem a melhor opção
- Nvidia
- circuitos integrados de aplicação específica (ASICs)
- Intel
- sistema em chip (SoC)
- Mobileye
- Apple
- Huawei
- AI como serviço (AIaaS)
- Os componentes AI, como os modelos ML, podem ser criados dentro de uma organização, baixados de terceiros, ou usados como serviço na web (AIaaS). Também é possível uma abordagem híbrida na qual algumas das funcionalidades da AI são fornecidas a partir do sistema e algumas são fornecidas como um serviço.
- Tais SLAs tipicamente cobrem um tempo de atividade para o serviço (p. ex.: 99,99% de atividade) e um tempo de resposta para corrigir defeitos, mas raramente definem métricas de performance funcional ML, (como a precisão), de maneira semelhante
- Modelos pré-treinados
- Uma alternativa mais barata e muitas vezes mais eficaz é usar um modelo pré-treinado. Isto fornece funcionalidade semelhante ao modelo necessário e é usado como base para criar um outro modelo que amplia e/ou foca a funcionalidade do modelo pré-treinado. Tais modelos estão disponíveis apenas para um número limitado de tecnologias, tais como redes neurais e florestas aleatórias.
- Também é possível a partir de um modelo pré-treinado, modificá-lo para realizar um segundo requisito diferente. A eficácia desta abordagem depende muito da similaridade entre a função desempenhada pelo modelo original e a função exigida pelo novo modelo. Por exemplo, modificar um classificador de imagem que identifica espécies de gatos para depois identificar raças de cães seria muito mais eficaz do que modificá-lo para identificar os sotaques das pessoas.
- Riscos
- Carecer de transparência; A similaridade pode ser insuficiente; podem ter impacto na performance; pode ter vieses e defeitos herdados; herdar vulnerabilidade.
- Normas e Regulamentações de IA
- Organismos Internacionais (ISO/IEC)
- ISO/IEC JTC1/SC42
- Subcomitê criado em 2017 focado especificamente em IA.
- ISO/IEC JTC1/SC7
- Focado em engenharia de sistemas e software; publicou relatório técnico sobre teste de sistemas de IA
- ISO/IEC JTC1/SC42
- Regulamentações de Dados e Privacidade
- GDPR (UE):
- Estabelece obrigações sobre decisões automatizadas e exige que sistemas sejam precisos para seus propósitos.
- LGPD (Brasil)
- Define regras para o armazenamento e manipulação de dados usados no treinamento de IA
- GDPR (UE):
- Normas Industriais e Ética
- IEEE
- Desenvolve séries de normas focadas em ética para IA e sistemas autônomos
- DIN (Alemanha)
- Desenvolveu o AI Quality Metamodel
- IEEE
- Sistemas de Segurança Crítica (Automotivo)
- ISO 26262:
- Norma de segurança funcional para sistemas automotivos
- ISO/PAS 21448
- Segurança da funcionalidade pretendida para veículos.
- ISO 26262:
- Organismos Internacionais (ISO/IEC)
- Definição de IA
Características de qualidade para sistemas baseados em AI
- Flexibilidade
- capacidade do sistema de ser usado em situações que não faziam parte dos requisitos originais do sistema
- adaptabilidade
- considerada a facilidade com que o sistema pode ser modificado para novas situações, tais como hardware diferente e ambientes operacionais em mudança.
- Autonomia
- considerada como a capacidade do sistema de trabalhar independentemente da supervisão e controle humano por períodos prolongados.
- Evolução
- a evolução é considerada como a capacidade do sistema de melhorar a si mesmo em resposta às restrições externas em mudança
- Vies
- viéses inadequados
- podem ser ligados a atributos como sexo, raça, etnia, orientação sexual, nível de renda e idade.
- viés algorítmico
- pode ocorrer quando o algoritmo de aprendizagem é configurado incorretamente, por exemplo, quando ele sobrevaloriza alguns dados em relação a outros
- viés de amostragem
- pode ocorrer quando os dados de treinamento não são totalmente representativos do espaço de dados ao qual o ML é aplicado.
- viéses inadequados
- Ética
- Um sistema de crenças aceitas que controla o comportamento, especialmente um sistema baseado na moral.
- Efeitos colaterais
- Ocorrem quando um sistema de IA, ao tentar atingir um objetivo específico, causa impactos negativos ou danos não intencionais ao ambiente ao seu redor. Isso acontece porque o objetivo foi definido de forma incompleta, sem considerar restrições ambientais ou sociais.
- hacking de recompensas
- Acontece quando o sistema de IA encontra uma maneira "fácil" ou imprevista de maximizar sua recompensa sem realmente realizar a tarefa pretendida. O sistema explora falhas na forma como a função de recompensa foi projetada
- Transparência
- a facilidade com que o algoritmo e os dados de treinamento usados para gerar o modelo podem ser determinados
- Interpretabilidade
- a clareza em ser compreendida a tecnologia de AI por stakeholders, incluindo os usuários
- Explicabilidade
- a facilidade com que os usuários podem determinar como o sistema baseado em AI chega a um resultado particular.
- Segurança e AI
- a segurança é considerada como a expectativa de que um sistema baseado em AI não causará danos às pessoas, propriedades ou ao meio ambiente.
- Características de sistema ia que os tornam dificil de serem seguros
- Complexidade; • Indeterminismo; • Natureza probabilística; • Autoaprendizagem; • Falta de transparência, interpretabilidade e explicabilidade; • Falta de robustez.
- Flexibilidade
Machine Learning, visão geral
- Supervisionada
- Classificação
- utilizada quando o problema requer uma entrada para ser ordenada em uma das poucas classes pré-definidas
- Acurácia, Precisão, Recall, F1-Score
- utilizada quando o problema requer uma entrada para ser ordenada em uma das poucas classes pré-definidas
- Regressão
- utilizada quando o problema requer o modelo ML para prever uma saída numérica usando a regressão.
- Erro Médio Quadrático (MSE), R2
- utilizada quando o problema requer o modelo ML para prever uma saída numérica usando a regressão.
- Classificação
- Aprendizagem não supervisionada
- Aglomeração
- o problema exige a identificação de semelhanças nos pontos de dados de entrada que permitem agrupá-los com base em características ou atributos comuns.
- EXEMPLO:Segmentação de clientes. O algoritmo agrupa clientes com comportamentos de gastos parecidos. Ele começa com cada cliente sendo um "grupo" e vai fundindo aqueles que gastam quantias similares e compram nas mesmas categorias, criando uma hierarquia de perfis.
- o problema exige a identificação de semelhanças nos pontos de dados de entrada que permitem agrupá-los com base em características ou atributos comuns.
- Associação
- o problema requer que relações ou dependências relevantes sejam identificadas entre os atributos de dados.
- EXEMPLO : Em um banco de dados de um supermercado, o algoritmo descobre que "70% das pessoas que compram pão e manteiga também compram café". Isso é uma regra de associação, usada para cross-selling e organização de prateleiras.
- o problema requer que relações ou dependências relevantes sejam identificadas entre os atributos de dados.
- Aglomeração
- Aprendizagem por reforço
- A aprendizagem por reforço é uma abordagem onde o sistema (um "agente inteligente") aprende interagindo com o ambiente de forma iterativa e, assim, aprende com a experiência.
- Fluxo de trabalho do ML
- Desenvolvimento do modelo
- 1- Entender os objetivos 2-Selecionar uma estrutura 3-Selecionar e construir o algoritmo 4-Preparar e testar dados
- Geração do Modelo
- 1-Treinar o modelo 2-Avaliar o modelo 3-Ajustar o modelo
- Testar o modelo
- Implantar o modelo Usar o Modelo Monitorar e ajustar o modelo
- Testar o modelo
- 1-Treinar o modelo 2-Avaliar o modelo 3-Ajustar o modelo
- Geração do Modelo
- 1- Entender os objetivos 2-Selecionar uma estrutura 3-Selecionar e construir o algoritmo 4-Preparar e testar dados
- Desenvolvimento do modelo
- Seleção de uma abordagem de ML
- Tem rotulo?
- Pode ser Supervisionada
- Discreta e categoria?
- Classificação
- Numerica?
- Regressão
- Discreta e categoria?
- Pode ser Supervisionada
- Sem rotulo?
- Não Supervisionada
- Dados Semelhantes?
- Aglomeração
- Itens de dados recorrentes?
- Associação
- Dados Semelhantes?
- Não Supervisionada
- Há interação com ambeinte?
- Aprendizado por reforço
- Tem rotulo?
- Fatores envolvidos na seleção do algoritmo ML
- se a funcionalidade é classificação ou previsão de um valor discreto
- Caracterisitcas de qualidade exisgidas
- precisão (p. ex.: alguns modelos podem ser mais precisos, mas mais lentos); o restringem a memória disponível (p. ex.: para um sistema incorporado); o a velocidade de treinamento (e reciclagem) do modelo; o a velocidade de previsão (p. ex.: para sistemas em tempo real); o os requisitos de transparência, interpretável e explicável;
- tipos de dados disponíveis para o treinamento do modelo (p. ex.: alguns modelos podem funcionar apenas com dados de imagem);
- A quantidade de dados disponíveis para treinamento e teste do modelo
- O número de características nos dados de entrada que se espera que o modelo utilize
- O número esperado de classes para agrupamento
- Experiência anterior; • Tentativa e erro
- Overfitting
- ocorre quando um modelo de Machine Learning aprende demais os dados de treino, incluindo ruídos, falhando em generalizar para novos dados.
- Underfitting
- acontece quando o modelo é simples demais e não aprende os padrões dos dados, apresentando baixo desempenho tanto no treino quanto no teste
- Supervisionada
Machine Learning (ML), dados
- Preparação de dados como parte do fluxo de trabalho ML
- Engenharia de recursos
- Seleção de características; Extração de recursos.
- Seleção de características; Extração de recursos.
- Pré-processamento de dados
- Limpeza; Transformação; Aumento; Amostragem.
- Limpeza; Transformação; Aumento; Amostragem.
- Aquisição de dados
- Identificação; Reuniões; Rotulagem.
- Em paralelo a estas atividades de preparação de dados, a análise exploratória de dados (EDA) também é normalmente realizada para apoiar a tarefa geral de preparação de dados. Isto inclui a analisar os dados para descobrir tendências inerentes e o uso da visualização para representá-los em um formato visual, traçando tendências.
- Identificação; Reuniões; Rotulagem.
- Engenharia de recursos
- Desafios na preparação de dados
- A necessidade de conhecimento
- do domínio de aplicação
- dos dados e suas propriedades
- das várias técnicas associadas à preparação dos dados
- A dificuldade de obter dados de alta qualidade de múltiplas fontes
- A dificuldade de automatizar o pipeline de dados e assegurar que o pipeline de dados de produção seja escalável e tenha eficiência razoável de performance
- Os custos associados à preparação dos dados;
- Não dar prioridade suficiente à verificação de defeitos introduzidos no pipeline de dados durante a preparação dos dados
- A introdução ao viés de amostragem
- A necessidade de conhecimento
- Conjunto de dados
- Três conjuntos de dados: Treinamento, validação e teste.
- Divisão geralmente (treinamento: validação: teste) variam de 60:20:20 a 80:10:10.
- Se houver dados ilimitado
- O algoritmo usado para treinar o modelo
- A disponibilidade de recursos, tais como RAM, espaço em disco, potência de computação, largura de banda da rede e o tempo disponível;
- Se houver dados limitado
- . Pode usar ex.: 80% de treinamento / 20% de validação
- Três conjuntos de dados: Treinamento, validação e teste.
- Questões de qualidade do conjunto de dados
- Dados errados
- Dados incompletos
- Dados mal rotulados
- Dados insuficientes
- Dados não préprocessados
- Dados obsoletos
- Dados desbalanceados
- Dados desleais
- Dados duplicados
- Dados irrelevantes
- Questões de privacidade
- Questões de segurança
- Qualidade dos dados e seu efeito sobre o modelo ML
- Precisão reduzida
- Estes defeitos são causados por dados errados, incompletos, mal rotulados, insuficientes, obsoletos, irrelevantes, e dados que não são pré-processados
- Modelo tendencioso
- Estes defeitos são causados por dados incompletos, desbalanceados, desleais, sem diversidade, ou duplicados
- Modelo comprometido
- Estes defeitos são devidos à privacidade dos dados e às restrições de segurança
- Precisão reduzida
- Rotulagem de dados para aprendizagem supervisionada
- Abordagens
- Interna
- Terceirizada
- Por multidão
- AI assistido
- Híbrido
- Dados mal rotulados em conjuntos de dados
- Erros aleatórios podem ser cometidos por anotadores
- Podem ser cometidos erros sistêmicos
- Erros deliberados podem ser cometidos por rotuladores de dados maliciosos;
- Os erros de tradução podem tomar dados corretamente rotulados em um idioma e incorretamente em outro
- Quando a escolha é aberta à interpretação, julgamentos subjetivos feitos por rotuladores de dados podem levar a rótulos de dados conflitantes de diferentes anotadores
- A falta do conhecimento de domínio exigido pode levar a uma rotulagem incorreta;
- Tarefas de classificação complexas podem resultar em mais erros
- As ferramentas usadas para suportar a rotulagem de dados têm defeitos que levam a rótulos incorretos
- As abordagens baseadas em ML para rotulagem são probabilísticas, e isto pode levar à alguns rótulos incorretos
- Abordagens
- Preparação de dados como parte do fluxo de trabalho ML
Machine Learning (ML), métricas de desempenho funcional
- Matriz de confusão
- Acurácia
- Indica a performance geral do modelo (o quanto ele acertou no total).
- Precisão
- Dentre todas as classificações positivas que o modelo fez, quantas estavam corretas? (Foco no custo do Falso Positivo).
- Recall
- Dentre todos os casos que eram realmente positivos, quantos o modelo conseguiu capturar? (Foco no custo do Falso Negativo).
- F1-Score
- É a média harmônica entre Precisão e Recall. É útil quando há um desequilíbrio entre as classes.
- Acurácia
- Métricas adicionais de performance funcional ML para classificação, regressão e agrupamento
- Métricas de classificação supervisionadas
- ROC/AUC
- a Curva ROC é como um vídeo que mostra como o modelo se comporta em todos os cenários possíveis.
- AUC = 1.0 (O modelo perfeito): Ele consegue separar totalmente as classes. Ele nunca confunde um "Gato" com um "Cachorro". AUC = 0.5 (O modelo "moeda"): Ele é tão bom quanto o acaso. Ele não aprendeu nada; é como se estivesse chutando cara ou coroa. AUC > 0.8: É considerado um modelo muito bom na maioria das indústrias.
- a Curva ROC é como um vídeo que mostra como o modelo se comporta em todos os cenários possíveis.
- ROC/AUC
- Métricas de regressão supervisionadas
- erro quadrático médio (MSE)
- é a média do quadrado das diferenças entre o valor real e o valor previsto. O valor do MSE é sempre positivo, e um valor mais próximo de zero sugere um melhor modelo de regressão. O quadrado da diferença garante que os erros positivos e negativos não se anulem
- Você quer saber o custo do erro em valores reais. É uma métrica técnica para o cientista de dados ajustar o modelo. "Meu modelo de previsão de tempo de teste erra, em média, 5 minutos para mais ou para menos."
- é a média do quadrado das diferenças entre o valor real e o valor previsto. O valor do MSE é sempre positivo, e um valor mais próximo de zero sugere um melhor modelo de regressão. O quadrado da diferença garante que os erros positivos e negativos não se anulem
- R-quadrado (também conhecido como coeficiente de determinação)
- O R-quadrado (também conhecido como coeficiente de determinação) é uma medida de quão bem o modelo de regressão se encaixa nas variáveis dependentes.
- Você quer saber a qualidade geral do modelo comparado a outros modelos. É ótimo para relatórios de negócio. "Este modelo de IA explica 92% dos motivos que fazem um cliente cancelar a assinatura."
- O R-quadrado (também conhecido como coeficiente de determinação) é uma medida de quão bem o modelo de regressão se encaixa nas variáveis dependentes.
- erro quadrático médio (MSE)
- Métricas de agrupamento não supervisionado
- métricas de intra-agrupamentos
- medem a similaridade dos pontos de dados dentro de um agrupamento
- medem a semelhança dos pontos de dados em diferentes agrupamentos;
- coeficiente de perfil
- Uma pontuação de +1 significa que os agrupamentos estão bem separados, uma pontuação de zero implica um agrupamento aleatório, e uma pontuação de -1 significa que os agrupamentos estão erroneamente atribuídos.
- métricas de intra-agrupamentos
- Seleção da métrica de performance funcional ML
- Acurácia
- Use apenas se os dados forem simétricos (classes equilibradas e custos de erro similares). Se uma classe dominar o dataset, ela se torna uma escolha ruim.
- Precisão
- Escolha quando o Falso Positivo é caro.
- Recall
- Escolha quando o Falso Negativo é crítico.
- F1-Score
- É a melhor opção para dados desequilibrados onde Precisão e Recall têm importância similar.
- Classificação Supervisionada
- Matriz de Confusão (Acurácia, Precisão, Recall, F1) e AUC/ROC.
- Regressão Supervisionada
- MSE e R-Quadrado
- Agrupamento (Clustering)
- métricas de inter-agrupamentos e o coeficiente de perfil
- Acurácia
- Conjuntos de referência para ML
- Como novas tecnologias de IA são lançadas regularmente, é difícil saber qual é realmente mais eficaz. Para resolver isso, a indústria criou conjuntos de referência (benchmarks) padronizados.
- Tempos de Treinamento
- Tempos de Inferência
- Medem a velocidade com que um modelo já treinado consegue processar novos dados e entregar uma resposta.
- MLCommons; DAWNBench ; MLMark.
- Como novas tecnologias de IA são lançadas regularmente, é difícil saber qual é realmente mais eficaz. Para resolver isso, a indústria criou conjuntos de referência (benchmarks) padronizados.
- Métricas de classificação supervisionadas
- Limitações das métricas de performance funcional ML
- As métricas funcionais de ML dizem se o modelo é inteligente, mas não dizem se o software é robusto, rápido ou ético. Elas são ferramentas de diagnóstico do "cérebro" da IA, altamente dependentes da qualidade dos dados de entrada.
- Matriz de confusão
Redes Neurais
- Evolução e Conceito
- Perceptron de Camada Única
- O modelo mais simples (um único neurônio), usado para classificadores básicos.
- Redes Neurais Profundas
- A evolução atual, que utiliza Perceptrons Multicamadas (várias camadas de processamento).
- Perceptron de Camada Única
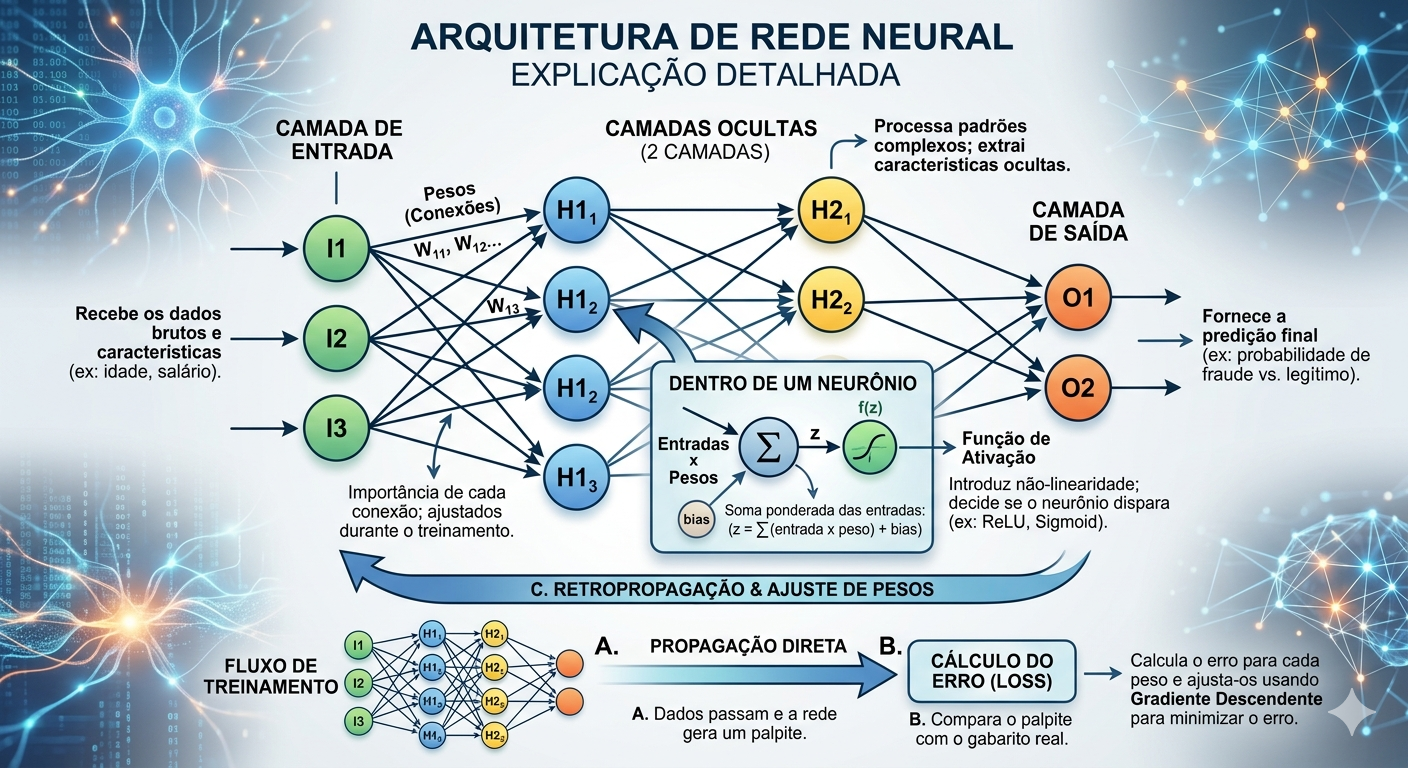
- Arquitetura das Redes Profundas
- Entrada
- : Recebe os dados brutos (ex: pixels de uma imagem).
- Camadas Ocultas (Nós)
- Localizadas entre a entrada e a saída. Realizam os cálculos e processam a informação.
- Saída
- Entrega o resultado final (ex: a probabilidade de uma imagem ser um "gato").
- Entrada
- O Cálculo no Neurônio
- Valores de Ativação
- Vindos da camada anterior.
- Pesos (Weights)
- Atribuídos às conexões; são os elementos que mudam conforme a rede aprende.
- Viés (Bias)
- Um valor constante predefinido para cada neurônio (diferente do conceito de viés ético ou social).
- Valores de Ativação
- Cobertura para Redes Neurais
- Cobertura de Neurônios
- Cada neurônio deve atingir um valor de ativação > 0.
- quase 100% de cobertura é alcançada com muitos poucos casos de teste em uma variedade de redes neurais profundas
- Cada neurônio deve atingir um valor de ativação > 0.
- Cobertura de Limite
- O neurônio deve exceder um limite específico (ex: > 0.75).
- Mudança de Sinal
- O neurônio deve atingir valores positivos e negativos em testes diferentes.
- Mudança de Valor
- A diferença entre dois valores de ativação deve exceder um montante escolhido.
- Cobertura de Sinal
- Semelhante ao MC/DC.
- Cobertura de Neurônios
- Evolução e Conceito
Visão geral dos sistemas baseados em AI
- Especificação de sistemas baseados em AI
- Assim como em sistemas convencionais, o teste de IA precisa de requisitos e especificações para saber se o comportamento está correto. Se a especificação é falha, surge o problema do oráculo (não saber se o resultado da IA está certo ou errado).
- Por que é difícil especificar IA?
- Abordagem Exploratória
- Diferente do software comum onde a lógica é definida no início, na IA muitas vezes começa-se com os dados para descobrir o que é possível prever. Os requisitos são metas de negócio de alto nível, não regras fixas.
- Incerteza da Acurácia
- Não se sabe o quão bom o sistema será até testá-lo. Isso faz com que os critérios de aceite sejam definidos "no meio do caminho", com a implementação já em andamento.
- Natureza Probabilística
- Como a IA trabalha com probabilidades, os requisitos não podem ser "sim ou não". É preciso especificar tolerâncias (ex: "o modelo deve ter no mínimo 90% de acurácia").
- Replicação do Comportamento Humano
- Quando o objetivo é "ser tão bom quanto um humano", a especificação fica vaga, pois humanos variam em suas capacidades. Isso torna o oráculo de teste subjetivo.
- Flexibilidade das Interfaces
- IAs de voz ou visão precisam lidar com infinitas variações de interação humana, sendo impossível documentar todos os cenários possíveis antecipadamente.
- Novas Características de Qualidade
- Atributos como autonomia, evolução e adaptabilidade são novos e difíceis de definir em contratos de requisitos tradicionais.
- Abordagem Exploratória
- Níveis de teste para sistemas baseados em AI
- Novos Níveis de Teste Especializados
- Teste de Dados de Entrada
- O que testar: Revisões, estatísticas para detectar vieses, EDA (Análise Exploratória de Dados) e o Pipeline de Dados. EDA detecta: Outliers (Valores Atípicos):; Valores Ausentes:Entende a Distribuição e Correlação; Detecta Vieses (Bias Detection); Valida as Premissas do Negócio.
- Teste do Modelo ML
- Funcional: Métricas de performance (Acurácia, Precisão, R2, etc.). Não-Funcional: Velocidade de treino/previsão e consumo de recursos. Otimização: Verificar se algoritmos e hiperparâmetros estão próximos do ideal. Pode incluir cobertura caixa-branca (neurônios).
- Teste de Dados de Entrada
- Níveis de Teste Convencionais (Adaptados para IA)
- Componente
- O teste de componentes é um nível de teste convencional que é aplicável a qualquer componente que não seja um modelo, como interfaces de usuário e componentes de comunicação.
- Integração
- O teste de integração de componentes é um nível de teste convencional que é conduzido para garantir que os componentes do sistema (tanto AI como não AI) interajam corretamente
- Sistema
- O teste do sistema é um nível de teste convencional que é conduzido para assegurar que o sistema completo de componentes integrados (tanto AI como não AI) funcione como esperado, tanto do ponto de vista funcional como não funcional, em um ambiente de teste que seja estreitamente representativo do ambiente operacional
- Aceite
- Validação final com o cliente. O desafio aqui é definir critérios de aceite para algo probabilístico.
- Componente
- Novos Níveis de Teste Especializados
- Dados de teste para testar sistemas baseados em AI
- Big Data
- Alto volume, velocidade e variedade dificultam a criação de massas de teste representativas.
- Evolução Temporal:
- Dados "envelhecem". Exemplos como reconhecimento facial exigem dados que simulem a passagem do tempo.
- Privacidade e Legal (LGPD):
- Necessidade crítica de anonimização, criptografia e aprovações legais antes de testar.
- Mascaramento de Defeitos
- Se o testador usar as mesmas ferramentas/scripts que o Cientista de Dados para preparar o teste, ele vai "herdar" os erros do desenvolvimento, tornando os bugs invisíveis.
- Big Data
- Teste de viés de automação em sistemas baseados em AI
- O conceito central é a confiança excessiva ou equivocada que os humanos depositam nos sistemas de IA, o que pode comprometer a segurança e a eficácia da solução. Ele se manifesta de duas formas principais:
- viés de automação ou complacência
- A primeira forma de viés de automação ou complacência é quando o ser humano aceita as recomendações fornecidas pelo sistema e não considera as entradas de outras fontes (incluindo elas próprias).
- A segunda forma de viés de automação ou complacência é onde o ser humano perde uma falha no sistema por não monitorar adequadamente o sistema
- viés de automação ou complacência
- O conceito central é a confiança excessiva ou equivocada que os humanos depositam nos sistemas de IA, o que pode comprometer a segurança e a eficácia da solução. Ele se manifesta de duas formas principais:
- Documentando um componente de AI
- Geral
- Identificação, versão, licenças e requisitos de hardware.
- Projeto
- Premissas e decisões técnicas (o "porquê" de certas escolhas).
- Utilização
- Casos de uso, vieses conhecidos, questões éticas/segurança e limites de decisão.
- Conjunto de Dados
- Origem, rotulagem, privacidade (LGPD), tamanho e imparcialidade.
- Testes
- Estratégias de robustez, explicabilidade e independência dos dados de teste.
- Treinamento/Performance
- Algoritmo utilizado, pesos, métricas escolhidas e resultados reais.
- A documentação clara transforma o sistema de "misterioso" em "testável" através de
- Especificação de Requisitos (Base de Teste)
- Define as metas funcionais e não funcionais.
- Informações Estruturais
- Descreve a interação entre componentes AI e não-AI (essencial para Testes de Integração e Caixa-Branca).
- Ambiente Operacional
- Necessário para validar a autonomia e adaptabilidade do sistema em condições reais.
- Origem e Metadados dos Dados
- Crucial para testar: Entradas não confiáveis (Robustez). Vieses de amostra (Equidade/Fairness). Aprendizagem errônea (em sistemas de autoaprendizado).
- Perfil de Usuários
- Garante que os dados e cenários de teste sejam representativos da realidade.
- Especificação de Requisitos (Base de Teste)
- Geral
- Teste de desvio de conceito
- Mudança no ambiente real que torna o modelo treinado impreciso (ex: Covid-19 mudando padrões de consumo).
- Gradual (sazonal/cultural)
- Abrupta (eventos externos súbitos).
- Mitigação
- Retirada do sistema ou retreinamento com dados atualizados.
- Validação Pós-Retreino
- Testes de Confirmação, Regressão e Teste A/B (O novo modelo B deve superar o antigo A).
- Mudança no ambiente real que torna o modelo treinado impreciso (ex: Covid-19 mudando padrões de consumo).
- Selecionando uma abordagem de teste para um sistema ML
- Baixa Qualidade de Dados
- Dados ruins geram modelos ruins. Mitigação: Revisões, EDA e testes dinâmicos
- Defeitos no Pipeline Operacional
- Falhas no fluxo que processa os dados em produção. Mitigação: Testes dinâmicos de componentes e testes de integração do pipeline.
- Fluxo de Trabalho ML Inadequado
- Escolha errada de algoritmos, estrutura ou hiperparâmetros. Mitigação: Revisões com especialistas, auditorias e gestão prática das etapas de ajuste.
- Falta de Representatividade
- Seleção incorreta de métricas (ex: focar em Recall quando se precisava de Precisão). Mitigação: Revisões com especialistas e testes baseados na experiência.
- Insatisfação com Atributos Não-Funcionais
- O modelo acerta, mas o serviço falha em robustez ou explicabilidade. Mitigação: Testes não-funcionais priorizados por risco (ISO 25010 ampliada).
- Falhas em Autoaprendizagem
- O sistema aprende padrões errados ou inaceitáveis. Mitigação: Testes de regressão automatizados (comparação com versão anterior) e testes baseados na experiência.
- Falta de Explicabilidade
- Usuários não confiam no sistema por não entenderem a decisão. Mitigação: Testes de transparência e interpretabilidade
- Sobreajuste (Overfitting
- O sistema só acerta o que "decorou" no treino. Mitigação: Testar com conjunto de dados totalmente independente e testes baseados na experiência.
- Baixa Qualidade de Dados
- Teste das características específicas de qualidade da AI
- Desafios para testar sistemas de autoaprendizagem
- Mudança Inesperada e Evolução do Código
- Desafio: O sistema pode criar implementações inovadoras "invisíveis" aos requisitos originais. Resultados de testes anteriores perdem a validade (problema em regressão). Solução: Projetar testes flexíveis que foquem no comportamento atual e criar novos testes baseados na observação das mudanças do sistema.
- Critérios de Aceite Complexos
- Desafio: Definir o que é "melhoria" é difícil. Pode envolver variáveis ambientais (ex: "melhorar 10% se o fator X mudar"). Solução: Estabelecer uma Linha de Base (Baseline) de performance e definir métricas de aceitação condicionais e mensuráveis.
- Tempo de teste insuficiente
- Desafio: Se o sistema aprende e muda rápido, o teste manual torna-se obsoleto imediatamente. Solução: Implementação de Testes Automatizados Contínuos que reagem às mudanças autônomas do sistema em tempo real.
- Requisitos de recursos:
- Desafio: A autoaprendizagem exige processamento e memória. É preciso validar se o ganho em precisão justifica o gasto de hardware. Solução: Incluir critérios de aceite específicos para o uso de recursos durante a fase de aprendizado.
- Especificações insuficientes do ambiente operacional e Ambiente de teste complexo
- Desafio: Dificuldade em prever todos os cenários reais ou ataques (como Data Poisoning - envenenamento de dados). Solução: Usar ferramentas de Injeção de Falhas e simular o máximo de variações de sensores e entradas ambientais para validar a robustez.
- Modificações indesejáveis de comportamento
- Desafio: O sistema pode "aprender" com os próprios testes, tornando-se viciado em responder bem aos cenários de teste, mas falhando no mundo real (sobreajuste ou comportamento indesejado). Solução: Gerenciar rigorosamente os dados de teste para garantir que a exposição repetida aos mesmos cenários não degrade a qualidade do aprendizado a longo prazo.
- Mudança Inesperada e Evolução do Código
- Teste de sistemas autônomos baseados em AI
- Três Pilares do Teste de Intervenção
- Solicitação por Limite Técnico
- Solicitação por Tempo (Timeout)
- Solicitação Indevida (Falso Positivo)
- Análise de Valor Limite (AVL):
- A Dificuldade:
- O maior desafio reside em traduzir parâmetros abstratos de autonomia em cenários práticos e reais, já que o comportamento da IA depende da natureza da sua função
- Três Pilares do Teste de Intervenção
- Testes de algoritmo, viés de amostragem e viés inadequado
- Viés
- Viés Algorítmico
- Erros sistemáticos introduzidos pelo próprio design do algoritmo durante o treinamento.
- Viés de Amostragem
- Ocorre quando os dados usados para treinar o modelo não representam fielmente a realidade ou o público-alvo.
- Viés Inadequado
- Preconceitos contra grupos de pessoas ou objetos, muitas vezes baseados em variáveis protegidas (raça, gênero, idade).
- Estratégias de Detecção e Correção
- Ajuste do Modelo
- Intervir deliberadamente no modelo (às vezes introduzindo um "viés positivo") para neutralizar um viés negativo identificado.
- Auditoria de Dados
- Revisar a fonte e o processo de aquisição dos dados. Analisar o pré-processamento para garantir que a limpeza/transformação dos dados não gerou distorções.
- Uso de Dados Independentes
- Testar o modelo com conjuntos de dados que ele nunca viu antes para verificar se o comportamento tendencioso se repete.
- Variáveis Ocultas (Proxy Variables):
- de um crédito, há viés. Variáveis Ocultas (Proxy Variables): O maior desafio. Mesmo que você remova o dado "raça" do sistema, o algoritmo pode inferir isso através de outras variáveis (como CEP ou comportamento de consumo). É necessário buscar atributos adicionais (como dados demográficos) para validar se essas correlações ocultas estão ocorrendo.
- Ajuste do Modelo
- Análise de Sensibilidade (Estilo LIME):
- Observar como pequenas mudanças nas entradas afetam as saídas. Se alterar apenas a "etnia" de um perfil muda o resultado da aprovação de um crédito, há viés.
- Viés Algorítmico
- Viés
- Desafios para testar sistemas baseados em AI probabilísticos e não determinísticos
- incluir tolerâncias (p. ex.: "o resultado real está dentro de 2% da solução ótima?");
- Quando uma única saída definitiva de um teste não é possível devido à natureza probabilística do sistema, muitas vezes é necessário que o testador execute um teste várias vezes a fim de gerar um resultado estatisticamente válido.
- Desafios nos testes de sistemas complexos baseados em AI
- O Problema do Oráculo de Teste
- Opacidade e a "Caixa-Preta
- na IA, a visibilidade do código interno muitas vezes não reduz a dificuldade do teste devido à complexidade algorítmica.
- Sistemas Multicomponentes
- A interação entre diferentes IAs torna o sistema "imprevisível" e difícil de testar de forma isolada.
- Teste da transparência, interpretabilidade e explicabilidade
- Teste de Transparência
- Consiste em comparar o que foi documentado (algoritmo e dados) com o que foi realmente implementado para ver se coincidem.
- Explicabilidade
- estes Dinâmicos
- Aplicar anomalias nos dados de entrada para ver como a saída muda.
- Testes Exploratórios:
- Úteis para "mapear" informalmente a relação entre entradas e saídas.
- Método LIME
- Como funciona: Injeta anomalias (mudanças) nos dados para dar ao testador uma visão da relação entrada/saída. Limitação: Ele fornece razões possíveis (probabilísticas) para uma decisão, e não uma razão definitiva/única.
- estes Dinâmicos
- Interpretabilidade
- omo é algo humano, o teste geralmente envolve métodos qualitativos, como pesquisas e questionários com os usuários para avaliar se eles entendem o comportamento do sistema.
- Teste de Transparência
- Oráculos de teste para sistemas baseados em AI
- Falta do "Terreno Comum"
- Sistemas de Autoaprendizagem
- Subjetividade
- Estratégias de Substituição do Oráculo
- Limites e Tolerâncias
- Especialistas Humanos
- Riscos ao Usar Especialistas Humanos
- Competência Variável
- alta de Consenso
- Viés de Julgamento:
- Nuances de Linguagem
- Riscos ao Usar Especialistas Humanos
- Técnicas que Mitigam o Problema do Oráculo
- Teste A/B
- Teste Consecutivo
- Teste Metamórfico
- Objetivos do teste e critérios de aceite
- Adaptabilidade
- Flexibilidade
- Evolução
- Autonomia
- Transparência, interpretável e explicável
- Livre de viés inapropriado
- Ética
- Sistemas probabilísticos e sistemas nãodeterminísticos
- Efeitos colaterais
- Hacking de recompensa
- Segurança
- Desafios para testar sistemas de autoaprendizagem
- Especificação de sistemas baseados em AI
Métodos e técnicas para o teste de sistemas baseados em AI
- Ataques contraditórios e envenenamento de dados
- Ataques contraditórios
- Um ataque contraditório ocorre quando uma entrada válida é modificada de forma sutil (quase imperceptível) para enganar o modelo, forçando-o a dar uma resposta errada com alta confiança
- Transferibilidade
- Significa que um exemplo que engana o "Modelo A" tem grandes chances de enganar o "Modelo B", mesmo que eles tenham sido treinados com dados ou arquiteturas diferentes.
- Ataque Caixa-Branca
- O atacante tem acesso total: algoritmo, parâmetros e configurações
- Ataque Caixa-Preta
- Ele explora o sistema para entender o comportamento e cria um modelo duplicado (mímica).
- Em que momento ocorre?
- o ataque contraditório ocorre na fase de inferência (uso).
- Que tipo de testes podem ser feitos?
- Os testes contraditórios envolvem simplesmente a realização de ataques contraditórios com o objetivo de identificar vulnerabilidades para que medidas preventivas possam ser tomadas para proteger contra falhas futuras. Os exemplos contraditórios identificados são adicionados aos dados de treinamento para que o modelo seja treinado para reconhecê-los corretamente.
- envenenamento de dados
- Ataques de envenenamento de dados são onde um atacante manipula os dados de treinamento para alcançar um de dois resultados. O atacante pode inserir backdoors ou trojans de redes neurais para facilitar futuras intrusões, ou mais frequentemente, eles usarão dados de treinamento corrompidos (p. ex., dados mal rotulados) para induzir o modelo treinado a fornecer previsões incorretas.
- Direcionado
- O objetivo é fazer a IA falhar em uma situação específica (ex: ignorar um rosto específico em um sistema de segurança).
- Indiscriminado
- Visa degradar a performance geral do sistema, funcionando como um Ataque de Negação de Serviço (DoS).
- Direcionado
- Em que momento ocorre?
- O envenenamento ocorre na fase de treinamento/atualização
- Que tipo de testes podem ser feitos?
- EDA (Exploratory Data Analysis)
- Teste A/B
- Teste de Regressão
- Proveniência de Dados
- Ataques de envenenamento de dados são onde um atacante manipula os dados de treinamento para alcançar um de dois resultados. O atacante pode inserir backdoors ou trojans de redes neurais para facilitar futuras intrusões, ou mais frequentemente, eles usarão dados de treinamento corrompidos (p. ex., dados mal rotulados) para induzir o modelo treinado a fornecer previsões incorretas.
- Ataques contraditórios
- Teste em pares
- Quando o sistema possui inúmeros parâmetros (clima, tipo de estrada, velocidade, sensores sujos), aplicamos técnicas para reduzir o volume de casos sem perder a qualidade da detecção de falhas.
- Testes consecutivos
- Com o teste consecutiv(teste diferencial) o, uma versão alternativa do sistema é usada como um pseudo-oráculo e seus resultados comparados com os resultados do teste produzido pelo SUT
- Teste A/B
- O teste A/B é um método onde a resposta de duas variações do programa (A e B) às mesmas entradas, são comparadas com o objetivo de se determinar qual das duas é a melhor. É uma abordagem de teste estatístico que normalmente requer a comparação dos resultados de teste de várias execuções de teste para determinar a diferença entre os programas.
- Pode ser usado para detectar envenenamento de dados
- utiliza o modelo antigo como um oráculo de sanidade. Se a nova versão (B) divergir de forma suspeita da versão estável (A) sob as mesmas condições, assume-se que a base de dados de treinamento foi comprometida.
- Pode ser usado quanto atualizar o modelo
- Quando você atualiza um modelo de ML, o teste A/B verifica se a nova versão atende aos critérios de aceite (acurácia, precisão, etc.) melhor que a anterior.
- Pode ser usado para sistemas de autoaprendizagem
- Essencial para validar se o "aprendizado" foi positivo. Se a mudança degradar o sistema, ele sofre um rollback para o estado anterior.
- Pode ser usado para sistemas complexos
- Pode ser usado em problemas de grande escala, como roteamento de tráfego, comparando métricas reais (ex: tempo médio de viagem) em períodos diferentes.
- Teste metamórfico (MT)
- O teste metamórfico [B18] é uma técnica destinada a gerar casos de teste que se baseiam na fonte de um caso de teste que tenha passado. Um ou mais casos de teste de acompanhamento são gerados alterando (metamorfoseando) o caso de teste de origem baseado em uma relação metamórfica (MR)
- Alta Detecção
- Pesquisas indicam que apenas 3 a 6 relações (MRs) diferentes podem revelar mais de 90% dos defeitos.
- Falta de Oráculo
- Validação sem "Verdade Absoluta
- Aplicações comuns
- Reconhecimento de imagem, voz, mecanismos de busca e otimização de rotas.
- Teste baseado na experiência de sistemas baseados em AI
- Os testes baseados na experiência incluem suposição de erros, testes exploratórios e testes baseados em checklist [I01], todos os quais podem ser aplicados aos testes de sistemas baseados em AI.
- suposição de erros
- Baseia-se no "faro" do testador sobre onde o sistema pode falhar.
- testes exploratórios
- Envolvem aprendizado, modelagem e execução de testes simultaneamente.
- Crucial quando não há um oráculo claro. Complementa técnicas sistemáticas (como o Teste Metamórfico).
- O EDA é o "Teste Exploratório dos Dados". É um processo iterativo de criar hipóteses e revisá-las com base no que se vê nos dados.
- testes baseados em checklist
- Dados ML
- Desenvolvimento de Modelos
- Infraestrutura ML
- Monitoramento
- suposição de erros
- Os testes baseados na experiência incluem suposição de erros, testes exploratórios e testes baseados em checklist [I01], todos os quais podem ser aplicados aos testes de sistemas baseados em AI.
- Seleção de técnicas de teste para sistemas baseados em AI
- Problema de oraculo
- Teste Consecutivo
- Usa um pseudo-oráculo (sistema equivalente). Ótimo para testes de regressão (usando a versão anterior como oráculo). Exige independência total de desenvolvimento para ser eficaz.
- Teste A/B
- Usa análise estatística e dados reais (operacionais). Ideal para comparar variantes, detectar envenenamento de dados ou validar sistemas de autoaprendizagem.
- Teste Metamórfico (MT)
- Foca em resultados relativos (se mudo X, a saída deve mudar proporcionalmente). Tem ótima relação custo-benefício e não exige testadores expriente, apenas conhecedores do negócio.
- Teste Consecutivo
- Segurança e Robustez do Modelo
- Testes Contraditórios
- Essenciais se o modelo for exposto a ataques externos ou se erros em entradas sutis tiverem alto impacto (ex: segurança, financeiro).
- Testes de Envenenamento de Dados
- Aplicáveis se houver risco de o conjunto de treinamento ser manipulado por terceiros.
- Testes Contraditórios
- Gerenciamento de Complexidade e Dados
- Teste em Pares
- Testes Baseados na Experiência
- EDA (Exploratory Data Analysis):
- Checklist do Google
- Testes de Estrutura
- Cobertura de Rede (Network Coverage)
- Problema de oraculo
- Ataques contraditórios e envenenamento de dados
Usando AI para testes
- Tecnologias de AI para testes
- Lógica Difusa e Métodos Probabilísticos
- Como funciona: Utiliza técnicas estatísticas (como redes Bayesianas) para modelar eventos que não são binários (sim/não), mas que possuem diferentes graus de probabilidade. Aplicações no Teste: Previsão de falhas em componentes específicos. Modelagem do comportamento humano (que é aleatório/imprevisível) ao interagir com o sistema.
- Classificação, Aprendizagem e Previsão (ML)
- Identificar padrões em dados históricos para categorizar informações ou prever o futuro. Gestão de Defeitos;Previsão de Defeitos; Teste de UI; Planejamento
- Pesquisa Computacional e Otimização
- Usa algoritmos de busca e otimização para resolver problemas matemáticos onde testar todas as combinações manualmente seria impossível. Geração de Casos de Teste; Otimização de Cobertura; Seleção de Testes de Regressão
- Lógica Difusa e Métodos Probabilísticos
- Usando AI para analisar os defeitos relatados
- Categorização
- Agrupa bugs similares e remove duplicatas.
- Algorotimo de Processamento de Linguagem Natural
- Criticidade
- Identifica bugs com alto potencial de falha sistêmica.
- Atribuição
- Recomenda o desenvolvedor ideal para a correção.
- Categorização
- Usando AI para geração de casos de teste
- fontes de informação
- Código-fonte e Interface do Usuário (UI).
- Modelos de test
- Logs e Instrumentação
- O Problema do Oráculo de Teste
- Sem uma definição prévia do comportamento esperado, a ferramenta não tem um "oráculo" para validar o sucesso ou falha do teste.
- Soluções Sugeridas
- Modelo de Teste
- Pseudo-oráculo (Teste Consecutivo)
- Indicadores de Falha Genéricos
- Enquanto ferramentas tradicionais podem levar 15.000 passos para causar uma falha, a IA reduz isso para cerca de 100 passos.
- Impacto
- Isso torna a correção de bugs muito mais rápida, pois a sequência de passos para reproduzir o erro é infinitamente menor.
- Impacto
- fontes de informação
- Usando AI para a otimização de conjuntos de teste de regressão
- Insumos
- Histórico de Execução
- Histórico de Defeitos
- Mudanças Recentes (Impact Analysis)
- três ações principais
- Seleção
- Priorização
- Aumento
- Ganhos de Eficiência
- Tamanho da Suíte
- Tempo de Execução
- Insumos
- Usando AI para previsão de defeito
- A previsão de defeitos utiliza modelos de ML para estimar a presença, a quantidade ou a probabilidade de encontrar erros em determinadas partes do sistema.
- Aplicação Prática
- O principal uso é a priorização de testes. Você direciona mais esforço e recursos para os componentes onde a IA previu um risco maior de falhas.
- Determinar a relação entre múltiplos fatores
- Métricas de Código-fonte
- Métricas de Processo e Pessoas
- Métricas Organizacionai
- Fatores de Sucesso
- A mesma base de código.
- Os mesmos desenvolvedores envolvidos.
- Usando AI para teste de interfaces de usuário
- Usando a AI para testar através da interface gráfica do usuário
- A IA reduz essa fragilidade ao não depender de um único "seletor" (como apenas o ID ou apenas o XPath).
- Multicritério
- Aprendizado de Estabilidade
- Classificação
- Teste Visual (Reconhecimento de Imagem)
- Uma alternativa poderosa que utiliza reconhecimento de imagem puro para interagir com a interface.
- Não Intrusivo
- Independência Tecnológica
- Evolução Computacional
- Uma alternativa poderosa que utiliza reconhecimento de imagem puro para interagir com a interface.
- A IA reduz essa fragilidade ao não depender de um único "seletor" (como apenas o ID ou apenas o XPath).
- Usando AI para testar a GUI
- A IA pode atuar como um "crítico de design", avaliando se a interface está funcional e amigável, mesmo sem uma imagem de referência anterior.
- Testes de Compatibilidade (Cross-Browser/Device)
- Identificação de Mudanças Não Intencionais
- Suporte à Regressão Visual
- Identificação de Erros de Renderização
- Acessibilidade e Usabilidade
- Tecnologia
- Usando a AI para testar através da interface gráfica do usuário
- Tecnologias de AI para testes
Imagens e arquivos do mapa
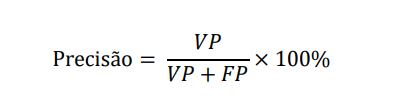
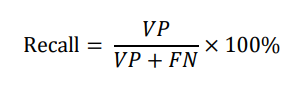
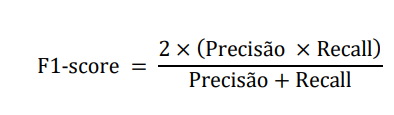
Informações
- Descrição
- Mapa Mental sobre CT-AI, criado por Tiago sfdsdfs em 05-05-2026.
- Criado por
- Tiago sfdsdfs
- Visualizações
- 0
- Avaliação