
Mapa mental
Python - Programação Procedural
Conteúdo do mapa
Python - Programação Procedural
Funções
- Retorno
- Outra função
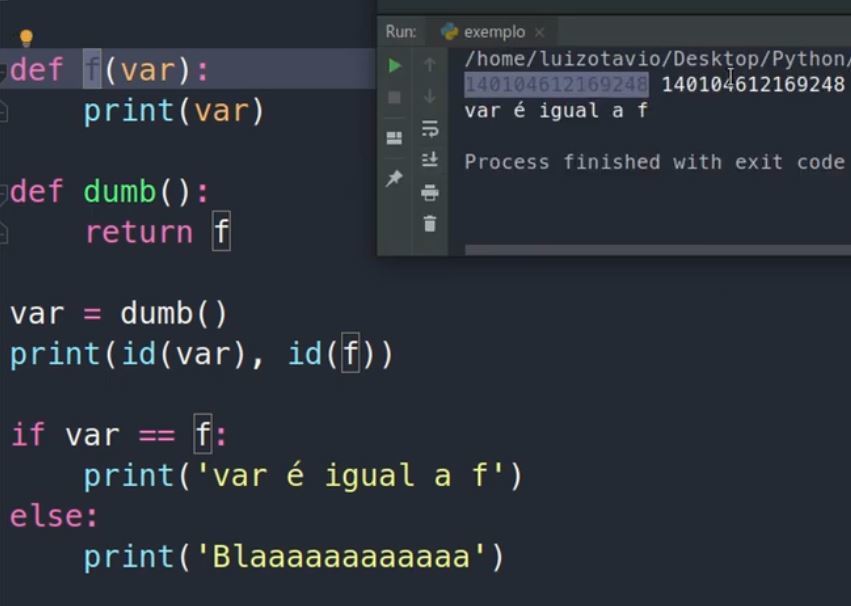
- return funcao2
- return funcao2()
- None
- não há return
- Tuplas
- É uma lista que não pode ser alterada, nem ter seus elementos removidos ou adicionados
- return ('Isaque', 'Paulo')
- return 'Isaque', 'Paulo'
- Outra função
- Argumentos
- Declaração
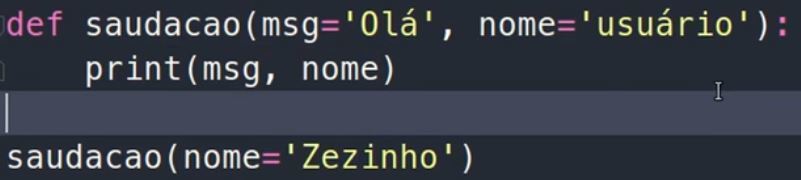
- def nome_funcao(parametro='valor padrão'):
- *args
- Argumentos não nomeados
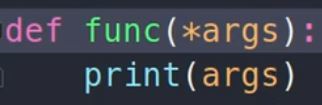
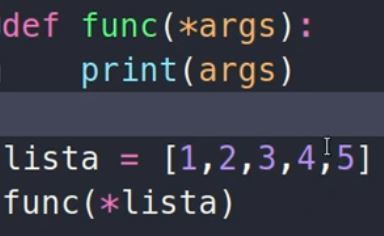
- def func(*args):
- Não sei quantos argumentos irão vir nessa função
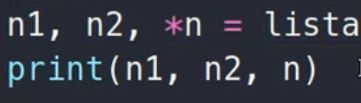
- No fundo estamos desempacotando a lista de argumentos
- No fundo estamos gerando uma tupla dos argumentos de entrada
- É como se fosse uma lista que não é possível alterar seus valores
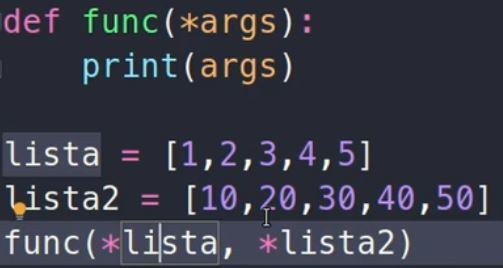
- Podemos mesclar duas listas em uma tupla na entrada
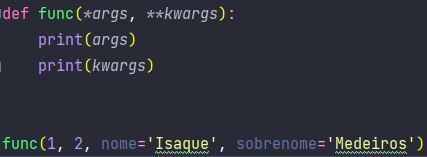
- **kwargs
- Argumentos nomeados
- Invocação
- nome_funcao('valor')
- nome_funcao(parametro_a='valor a')
- func(1, 2, 3, nome = 'Isaque', nome_var_obrigatorio = 4)
- A partir do momento que uso argumento nomeável todos os posteriores deverão o ser também
- def func(a1, a2, a3 = None, a4 = 'Alguma coisa obrigatoriamente'):
- A partir do momento que eu defino um padrão para um argumento, todos os outros depois dele deverão conter um padrão definido
- Declaração
- Escopos
- Invocar variavel global na função
- variavel = 'valor' def func(): print(variavel)
- global variavel
- def func(): global variavel
- global
- Fora da função
- local
- Dentro da função
- Invocar variavel global na função
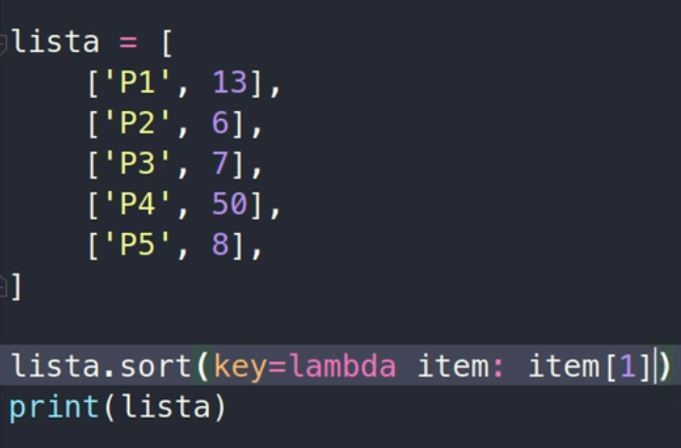
- Funções lambda
- São funções ou expressões anônimas
- multiplica = lambda x, y: x * y
- multiplica(2,2)
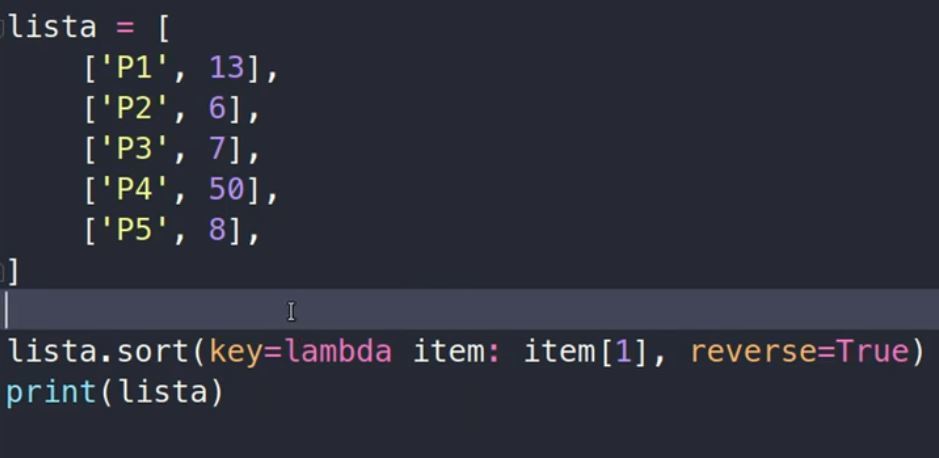
- Ordenar lista
- Obs não preciso da palavrinha return, pois ela já é implícita
- Retorno
Comprehensions
- List Comprehension
- l1 = list(range(1,10)) l2 = ['Luiz', 'Mauro'] tupla = (('chave', 'valor'), ('chave2', 'valor2')) l3 = list(range(100)) string = '01234567890123456789012345678901234567890123456789012345678901234567890123456789'
- ex1 = [variavel*2 for variavel in l1]
- ex2 = [(v, v2) for v in l1 for v2 in range(3)]
- ex3 = [v.replace('a', '@').upper() for v in l2]
- ex4 = dict([(x, y) for x, y in tupla])
- ex5 = [v for v in l3 if v % 2 == 0 if v % 8 == 0]
- ex6 = [v if v % 3 == 0 and v % 8 == 0 else 'Não é divisível por 24' for v in l3]
- ex7 = [string[i: i + 10] for i in range (0, len(string), 10)]
- retorno = '.'.join(ex7)
- total = sum(y for x, y in carrinho)
- carrinho = [('Produto 1', 20), ('Produto 2', 30), ('Produto 3', 50)]
- Dict Comprehension
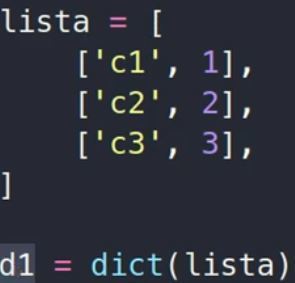
- lista = ( ('chave', 'valor'), ('chave2', 'valor2') )
- d1 = {x: y for x, y in lista}
- d1 = dict(lista)
- d1 = {x: y.upper() * 2 for x, y in lista}
- d1 = {x: y for x, y in enumerate(range(5))}
- d1 = {f'chave_{x}': x**2 for x in range(5)}
- List Comprehension
Dados
- Dicionários
- Contém uma chave e um valor
- Declaração
- d1 = {'chave1':'valor da chave'}
- Adição
- d1['nova_chave'] = 'Valor da nova chave'
- Acesso
- print(d1['chave1'])
- d1.get('chave1')
- Verificação
- Chave
- if 'chave1' in d1:
- 'chave1' in d1.keys()
- if 'chave1' not in d1:
- if d1.get('chave1') is not None:
- if 'chave1' in d1:
- Valor
- 'valor' in d1.values()
- Tamanho
- len(d1)
- Chave
- Alteração
- d1['nova_chave'] = 'novo_valor'
- d1.update({'nova_chave': 'novo_valor'})
- Remoção
- del d1['chave1']
- Iteração
- for v in d1.values():
- for k in d1:
- for k in d1.items():
- print(k)
- print(k[0], k[1])
- for k,v in d1.items():
- print(k, v)
- Associação
- d1 = {'chave':'valor'}
- d2 = d1
- ambas variáveis apontam para a mesma região de memória do computador
- d2['chave']='outro valor'
- d1['chave'] também receberá 'outro valor'
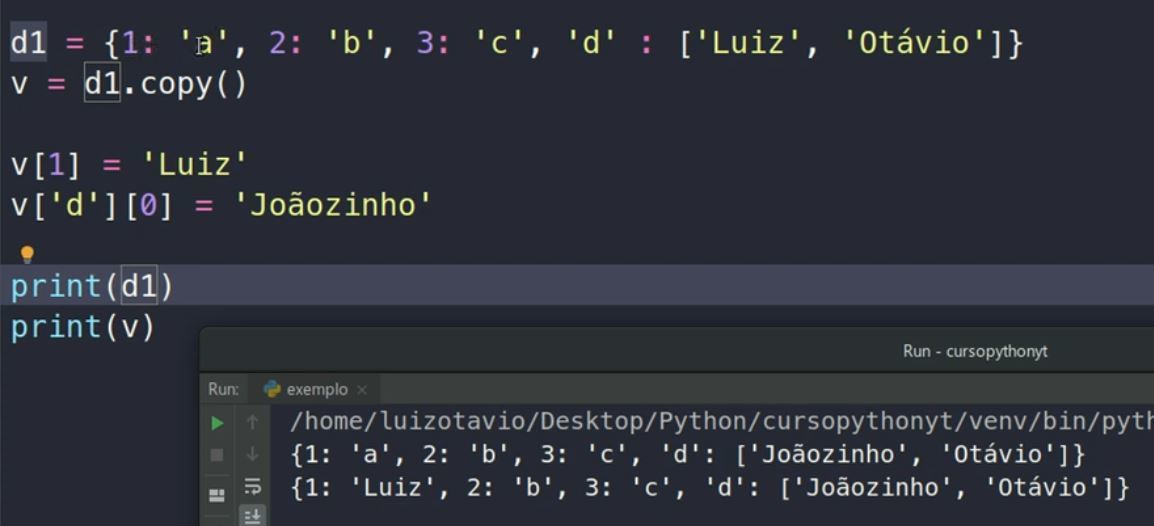
- d2 = d1.copy()
- d2['chave']='outro valor'
- d1['chave'] não receberá 'outro valor'
- Obs, se o valor for uma lista
- Para realmente fazer uma cópia precisaremos importar o módulo copy
- import copy
- v = copy.deepcopy(d1)
- Para realmente fazer uma cópia precisaremos importar o módulo copy
- Obs, se o valor for uma lista
- d1['chave'] não receberá 'outro valor'
- d2['chave']='outro valor'
- d2 = d1
- d1 = {'chave':'valor'}
- Casting
- Serve com listas ou tuplas
- Funções
- Remover
- d1.pop('chave')
- d1.popitem()
- Mesclar dois dicionários
- d1.update(d2)
- Remover
- sets / conjuntos
- Obs eles não respeitam ordem dos elementos, eles podem aparecer de maneira aleatória
- Declaração
- Se fizermos s1 = {} estaremos declarando uma lista
- s1 = set()
- s1 = {1,2,3,4}
- Adição
- s1.add(2)
- s1.update('xablau', {1,2,3})
- vai iterar sobre cada elemento da string
- Remoção
- s1.discard(2)
- Casting
- Podemos utilizá-los para remover os itens repetidos de uma lista por exemplo
- l1 = [1, 2, 1, 3]
- l1 = set(l1)
- l1 = list(l1)
- l1 = set(l1)
- Obs a lista poderá ficar fora de ordem
- l1 = [1, 2, 1, 3]
- Podemos utilizá-los para remover os itens repetidos de uma lista por exemplo
- União
- s3 = s1 | s2
- s3 = s1.union(s2)
- Interseção
- s3 = s1 & s2
- Diferença
- s1 - s2
- Dicionários
Objetos
- lista = ['a', 'b', 'c'] for v in lista: print(v) O que ocorre aqui é que o comando for transforma a lista em um iterador, visto que listas não são iteradoras
- Iteráveis
- Um iterável é um objeto que você pode iterar sobre ele, mas ele, não necessariamente, é um iterador e o iterador sempre vai te dar um valor de cada vez sempre que você precisar desse valor
- Verificar se é iterável
- print(hasattr('123', '__iter__'))
- print(hasattr(123, '__iter__'))
- print(hasattr([1,2,3], '__iter__'))
- print(hasattr({1,2,3}, '__iter__'))
- print(hasattr((1,2,3), '__iter__'))
- Unir Iteráveis
- Suponha que eu tenho essas duas listas: cidades = ['São Paulo', 'Belo Horizonte', 'Salvador', 'Belo Monte']estados = ['SP', 'MG', 'BA'] E eu quero uni-las
- Zip
- cidades_estados = zip(cidades, estados)
- print(next(cidades_estados))
- for valor in cidades_estados:
- print(list(cidades_estados))
- print(dict(cidades_estados))
- cidades_estados = zip(cidades, estados)
- zip_longest
- from itertools import zip_longest
- cidades_estados = zip_longest(cidades, estados, fillvalue="Estado")
- from itertools import zip_longest
- Iterador
- iterador se refere tanto ao objeto que permite ao programador percorrer um container, particularmente listas, quanto ao padrão de projetos Iterator, no qual um iterador é usado para percorrer um container e acessar seus elementos.
- Verificar se é iterador
- print(hasattr(['a', 'b', 'c'], '__next__'))
- Transformar em iterador
- iter(lista)
- Iterar
- lista = [0,1,2,3,4]
- lista = iter(lista)
- print(next(lista))
- 0
- print(next(lista))
- print(next(lista))
- 2
- 1
- print(next(lista))
- print(next(lista))
- lista = iter(lista)
- lista = [0,1,2,3,4]
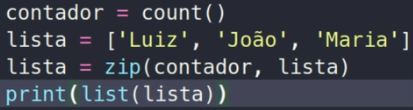
- count()
- Ela vai gerar um contador que é um iterador from itertools import count
- É um iterador sem fim
- contador = count()
- print(next(contador))
- contador = count(start=5, step=-1)
- Gerador
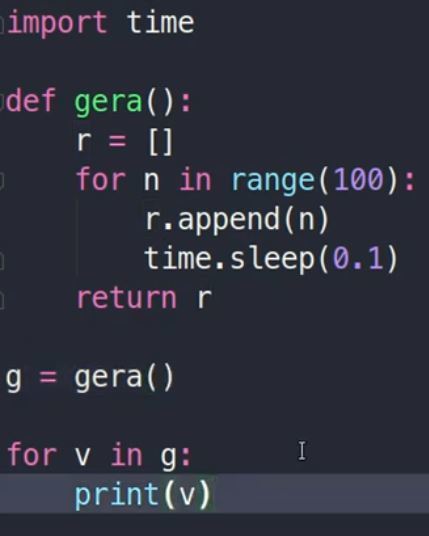
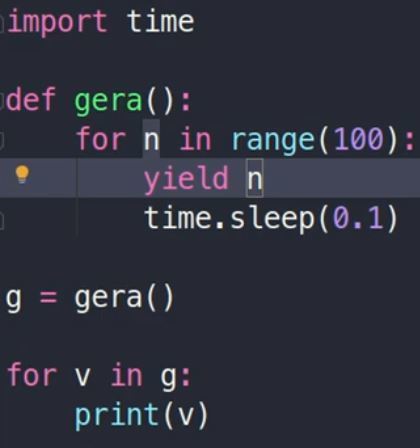
- São utilizados quando a gente precisa utilizar valores que vão utilizar muita memória
- Sem gerador
- O PC vai jogar 100000000000 números na memória RAM
- O script só vai rodar depois que todos os números forem gerados na RAM
- Se o programa crashar vai ser só perda de tempo e energia
- Com gerador
- Vai sendo gerado um número por vez
- O próximo número só será gerado quando o primeiro tiver sido utilizado
- Ocupa menos espaço na memória pois só terá 1 número de cada vez lá
- Obs
- print(hasattr(g, '__iter__'))
- True -> posso usar o for com ele
- print(hasattr(g, '__next__'))
- True -> posso utilizar a função next
- Quando acabarem os valores e vc chamar a função next novamente aparecerá o erro: StopIteration
- print(hasattr(g, '__iter__'))
- Vai sendo gerado um número por vez
- gerador = (x for x in range(1000))
- Verificar se é
- print(isinstance(variavel, GeneratorType))
- from types import GeneratorType
- print(isinstance(variavel, GeneratorType))
- Transformar em gerador
- variavel = zip('Olá', 'Olá')
- variavel = ((x, y) for x,y in zip('Olá', 'Olá'))
itertools
- Análise e Combinatória
- Combinação
- Ordem não importa
- from itertools import combinations
- for grupo in combinations(pessoas, 2):
- print(grupo)
- for grupo in combinations(pessoas, 2):
- pessoas = ['João', 'Pedro', 'Thiago']
- Permutação
- Ordem importa
- from itertools import permutations
- for grupo in permutations(pessoas, 2):
- Produto Cartesiano
- A x B possui p ⋅ q elementos
- from itertools import product
- Mesmo Conjunto
- for grupo in product(pessoas, repeat=2):
- Conjuntos Disjuntos
- for grupo in product(numeros, pessoas):
- Mesmo Conjunto
- Combinação
- Agrupamentos
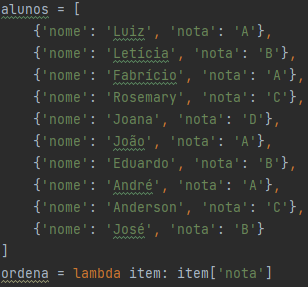
- alunos.sort(key=ordena)
- Obrigatoriamente temos que ordenar
- for agrupamento_nota, agrupamento_value in alunos_agrupados:
- print(agrupamento_nota)
- for aluno in agrupamento_value:
- print(aluno)
- quantidade = len(list(agrupamento_nota))
- print(f'{quantidade} alunos tiraram a nota {agrupamento}')
- Obs.: agrupamento_nota é um iterador, então se utilizarmos a função list() iremos esgotá-lo e não poderemos utilizar a função da esquerda pois o mesmo já terá esgotado todos os seus valores
- for aluno in agrupamento_value:
- print(agrupamento_nota)
- alunos.sort(key=ordena)
- Análise e Combinatória
Mapear, Filtrar, reduzir
- dados.py
- produtos = [ {'nome': 'p1', 'preco': 13}, {'nome': 'p2', 'preco': 55.55}, {'nome': 'p3', 'preco': 5.59}, {'nome': 'p4', 'preco': 22}, {'nome': 'p5', 'preco': 81.23}, {'nome': 'p6', 'preco': 5.7}, {'nome': 'p7', 'preco': 10.90}, {'nome': 'p8', 'preco': 89.82}, {'nome': 'p9', 'preco': 12}, {'nome': 'p10', 'preco': 2.90} ] pessoas = [ {'nome': 'Luiz', 'idade': 12}, {'nome': 'Eduarda', 'idade': 43}, {'nome': 'Joana', 'idade': 65}, {'nome': 'Lucas', 'idade': 14}, {'nome': 'Felipe', 'idade': 17}, {'nome': 'Maria', 'idade': 19}, {'nome': 'Júlia', 'idade': 25}, {'nome': 'Diniz', 'idade': 32}, {'nome': 'Max', 'idade': 23}, {'nome': 'Eduardo', 'idade': 59}, ] lista = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
- from dados import produtos, pessoas, lista
- map()
- Quero pegar os números de lista e multiplicá-los por 2
- nova_lista = map(lambda x: x * 2, lista)
- A função map retornará um iterador
- print(next(nova_lista))
- print(list(nova_lista))
- A função map retornará um iterador
- Podemos utilizar list comprehension que é mais lenta
- nova_lista = [x * 2 for x in lista]
- nova_lista = map(lambda x: x * 2, lista)
- Esta função recebe outra função como primeiro argumento, por isso utilizaremos a expressão lambda. E o segundo elemento será a lista
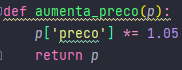
- Adicionar 5% no preço de produtos
- novos_produtos = map(aumenta_preco, produtos)
- print(list(novos_produtos))
- novos_produtos = map(aumenta_preco, produtos)
- Obter uma lista com as idades de pessoas incrementada de 20%
- idades = list(map(lambda p: round(p['idade']*1.20), pessoas))
- Quero pegar os números de lista e multiplicá-los por 2
- filter()
- É muito simular à função map, a difereça é que a função filter irá retornar ou verdadeiro ou falso para a expressão que vc falar
- Obter todos os números maiores que 5 de lista
- nova_lista = filter(lambda x: x > 5, lista)
- Pegar os produtos cujo preço seja maior que 10 reais
- novo_preco = filter(lambda x: x['preco'] > 10, produtos)
- novo_preco = filter(filtra, produtos)
- def filtra(produto): if produto['preco'] > 10: return True
- Filtrar quem é maior de idade em pessoas
- nova_lista = filter(lambda p: p['idade'] >= 18, pessoas)
- reduce()
- from functools import reduce
- Somar todos os números da lista
- somatorio_lista = reduce(lambda acumulador, item: item + acumulador, lista, 0)
- Somar preços de produtos
- somatorio_precos = reduce(lambda ac, p: p['preco'] + ac, produtos, 0)
- Somar todos os números da lista
- Ela faz acumulação de valores
- from functools import reduce
- map()
- dados.py
Tratando exceções
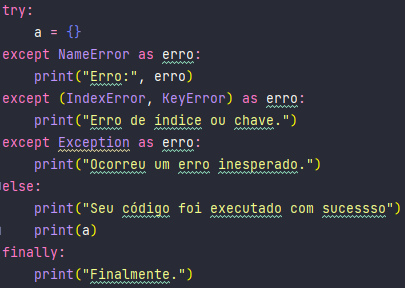
- try/except
- exemplo
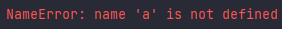
- print(a)
- print(a)
- except
- Trata a exceção, pode receber uma exceção ou uma tupla com múltiplas exceções
- else
- Parte que será executada se não ocorrer exceções
- finally
- Será sempre executada
- Pode ser útil para, por exemplo, fechar um arquivo que foi aberto pelo try
- Será sempre executada
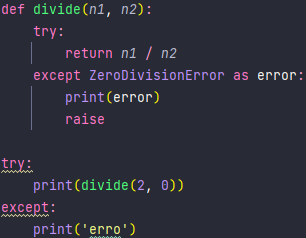
- raise
- Serve para não modificar o tratamento de uma exceção já tratada
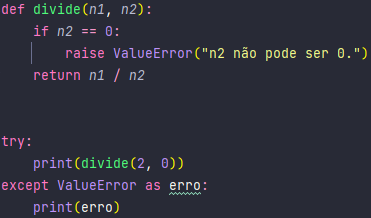
- Criar própria mensagem de exceção dentro da função
- Todas as possíveis exceções são encontradas em https://docs.python.org/3/library/exceptions.html
- É possível criar erro para n2 ser sempre diferente de 1, por exemplo
- exemplo
- Serve para o código do programa não ser interrompido devido a algum erro
- try/except
Pactoes/Módulos
- Módulos
- Importação
- import sys
- print(sys.platform)
- from sys import platform
- print(platform)
- Cuidado para não sobrescrever a função
- from sys import platform as so
- print(so)
- from sys import *
- print(platform)
- Assim fica mais difícil de saber de onde está vindo platform, quando debugar
- Todo os módulos padrões do python podem ser encontrados em https://docs.python.org/3/py-modindex.html
- import sys
- Instalação
- Criação
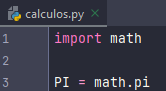
- calculos.py
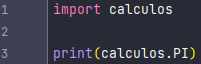
- aplicativo.py
- print(__name__)
- em calculos.py
- executando aplicativo.py
- exibirá: calculos
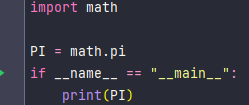
- executando calculos.py
- exibirá: main
- Portanto se eu quiser que uma parte do código só seja executada dentro do arquivo calculos.py, e não quando ele for importad
- Portanto se eu quiser que uma parte do código só seja executada dentro do arquivo calculos.py, e não quando ele for importad
- exibirá: main
- calculos.py
- São separados por arquivos
- Importação
- Servem para reaproveitar códigos em outras partes do programa
- Pacotes
- São separados por pastas
- Criação
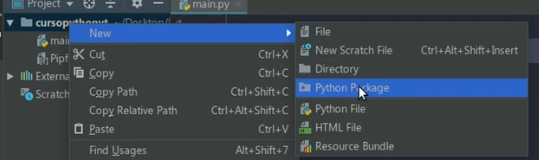
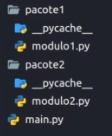
- O arquivo __init__.py é obrigatório dentro dos pacote
- Dentro de um módulo posso ter vários pacotes
- Importação
- import pacote.modulo
- variavel = pacote.modulo.funcao(valor)
- from pacote import modulo
- variavel = modulo.funcao(valor)
- from pacote.modulo import funcao
- variavel = funcao(valor)
- import pacote.modulo
- Ponto de vista
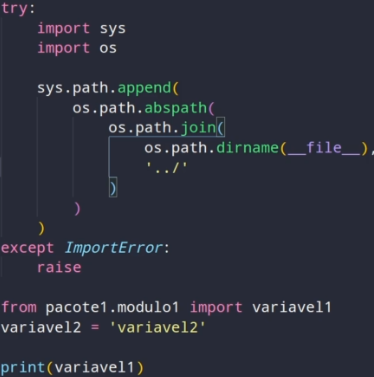
- As importações devem considerar que a invocação dos módulos e pacotes são feitos na raiz do projeto, como se fosse o main.py
- As importações devem considerar que a invocação dos módulos e pacotes são feitos na raiz do projeto, como se fosse o main.py
- Módulos
Arquivos
- Abrir
- file = open('arquivo.txt', 'w+')
- r = ler
- w = abrir para escrever, truncando-o primeiro (criando um arquivo sem conteúdo primeiro)
- x = apenas criar, não será executado se o arquivo já existir
- a = escrever colocando o cursor no final do arquivo
- b = modo binário
- t = modo texto, padrão
- + = atualizar, ler e escrever
- file = open('arquivo.txt', 'w+')
- Escrever
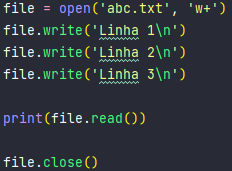
- file.write('Linha 1\n')
- Fechar
- file.close()
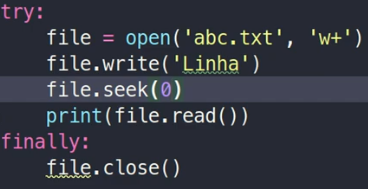
- Modo Universal: try/finally
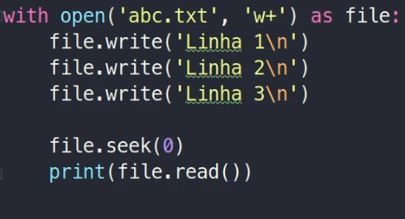
- Modo Pythonico: Gerenciador de contexto
- Modo Universal: try/finally
- file.close()
- Ler
- Arquivo
- print(file.read())
- Linha
- print(file.readline())
- Evitar dupla quebra de linha = Final da linha contém \n + quebra de linha da função print
- print(file.readline(), end='')
- Evitar dupla quebra de linha = Final da linha contém \n + quebra de linha da função print
- lista = file.readlines()
- for linha in file.readlines():
- print(linha, end='')
- for linha in file.readlines():
- for linha in file:
- print(file.readline())
- Arquivo
- "Reposicionar cursor"
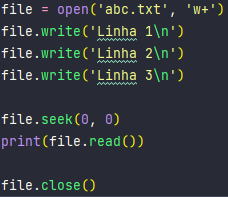
- Se executarmos este código a função file.read() retornará vazio, pois o cursor foi movido para o final do arquivo através das funções file.write()
- file.seek(0, 0)
- offset
- Número de posições para avançar
- from_what
- 0 = início do arquivo
- 1 = posição atual
- 2 = final do arquivo
- Também pode ser utilizado para mover o cursor pro início para escrever algo lá
- offset
- json
- Codificar
- lista_json = json.dumps(lista)
- lista_json = json.dumps(lista, indent=True)
- Melhor formatado para linguagem humana
- Decodificar
- lista = json.loads(lista_json)
- Codificar
- Abrir
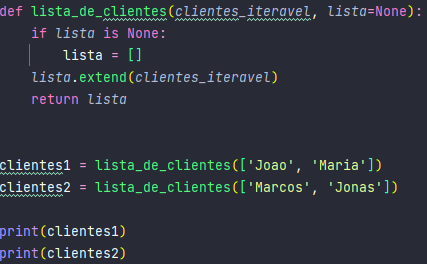
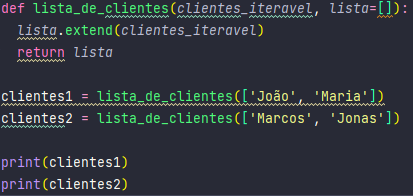
Porblema dos valores mutáveis
- Maneira errada
- Não devemos definir valores mutáveis como argumentos padrões de função
- Maneira correta
- Maneira errada
Imagens e arquivos do mapa
Informações
- Descrição
- Linguagem de programção Python Mapa Mental sobre Python - Programação Procedural, criado por Isaque Paulo em 10-12-2021.
- Criado por
- Isaque Paulo
- Visualizações
- 15
- Tags
- Avaliação