
Mapa mental
Pentium 4
Conteúdo do mapa
Pentium 4
Embora o conceito de projeto superescalar seja geralmente associado à arquitetura RISC, os mesmos princípios superescalares podem ser aplicados a uma máquina CISC. Talvez o exemplo mais notável disso seja o Pentium. A evolução de conceitos superescalares na linha Intel é interessante para ser observada. O 386 é uma máquina CISC tradicional sem pipeline. O 486 introduz o primeiro processador x86 com pipeline, reduzindo a latência média de operações de inteiros de dois a quatro ciclos para um ciclo, mas é ainda limitada a executar uma única instrução a cada ciclo, sem elementos superescalares. O Pentium original tinha um componente superescalar modesto, consistindo de uso de duas unidades de execução de inteiros. O Pentium Pro introduziu um design superescalar completo. Modelos Pentium subsequentes refinaram e melhoraram o projeto superescalar. A operação de Pentium 4 pode ser resumida do seguinte modo:
- 1
- 2
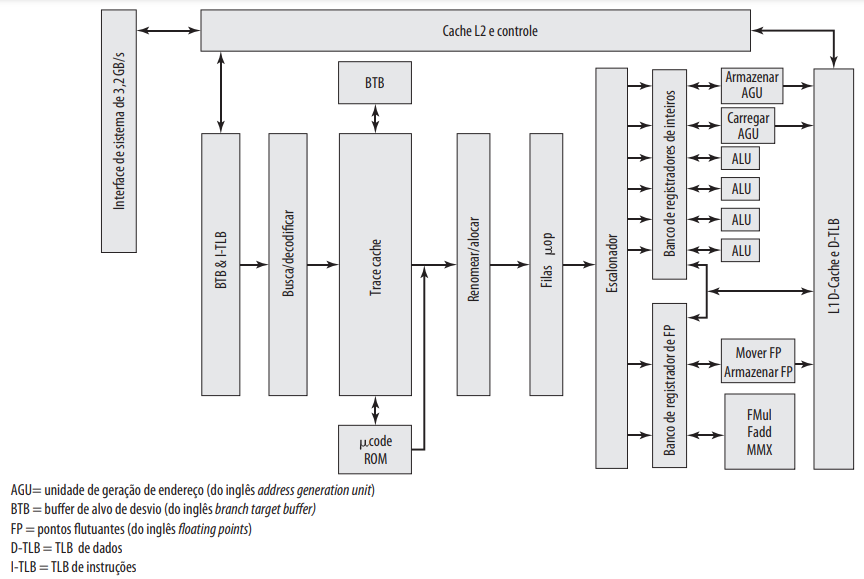
- A organização de Pentium 4 inclui um front end in -order. Este front end alimenta uma cache de instruções L1, chamado de trace cache, que é onde o pipeline começa de fato. Quando ocorre uma falha na trace cache, o front end in -order coloca novas instruções na tracecache.
- 3
- Com a ajuda do buffer de alvo do desvio e do buffer de análise antecipada (BTB e I -TLB), a unidade de busca/decodificação obtém as instruções de máquina de Pentium 4 a partir da cache L2, 64 bytes por vez. Por padrão, as instruções são obtidas sequencialmente para que cada linha obtida da cache L2 inclua a próxima instrução a ser lida. A previsão de desvio através da unidade BTB e I -TLB pode alterar essa operação sequencial de leitura. O I-TLB traduz o endereço do ponteiro linear da instrução dado para o endereço físico requerido para acessar a cache L2. A previsão de desvio estática no front end BTB é usada para determinar quais instruções obter a seguir.
- 4
- O BTB do Pentium 4 é organizado como uma cache associativa por conjunto de 4 linhas cada conjunto(4 -way), com 512 linhas no total. Cada entrada usa o endereço do desvio. A entrada também inclui o endereço do destino do desvio para última vez em que o desvio foi tomado e um campo de histórico de 4 bits. Esse uso de quatro bits de histórico contraria com 2 bits usados no Pentium original e usados na maioria de processadores superescalares. Porém, Com 4 bits, o mecanismo do Pentium 4 pode levar em conta um histórico maior ao prever desvios.
- 6
- A trace cache recebe as micro -ops já decodificadas do decodificador de instruções e as monta em sequências ordenadas de micro -ops (chamadas de traces) como no programa. As micro -ops são obtidas sequencialmente a partir da trace cache, sujeito a lógica de previsão de desvios. Poucas instruções requerem mais do que quatro micro -ops. Essas instruções são transferidas para ROM de microcódigo que contém uma série de micro -ops (cinco ou mais) associadas a uma instrução de máquina complexa.
- 7
- Uma vez obtidas as instruções, a unidade de busca/decodificação procura pelos bytes para determinar os limites da instrução; isso é uma operação necessária por causa do tamanho variável das instruções x86. O decodificador traduz cada instrução de máquina para um até quatro micro -ops, cada uma sendo uma instrução RISC de 118 bits. Observe, para efeitos de comparação, que as máquinas RISC mais puras possuem um tamanho da instrução 32 bits. O tamanho maior de micro -op é necessário para acomodar as operações complexas de Pentium. Mesmo assim, as micro -ops são mais fáceis de gerenciar do que as instruções originais das quais derivam.
- 5
- O ROB é um buff er circular que pode guardar até 126 micro -ops e também contém 128 registradores físicos. Cada entrada do buffer consiste dos campos a seguir: O "estado": indica se a micro -op está escalonada para execução, se foi despachada para execução ou se completou a execução e está pronta para ser retirada. O "endereço de memória": o endereço da instrução Pentium que gerou a micro -op. A "micro -op": a operação atual. O "Registrador apelido (alias register)": se a micro -op referencia um dos 16 registradores arquiteturais, esta entrada redireciona essa referência para um dos 128 registradores de hardware.
- 8
- Os bancos de registradores de inteiros e de ponto flutuante são a origem das operações pendentes para unidades de execução (Figura 14.9i). Estas obtêm valores a partir dos bancos de registradores assim como a partir da cache de dados L1 (Figura 14.9j). Um estágio separado do pipeline é usado para calcular os fl ags (por exemplo, zero, negativo); essas são normalmente a entrada para uma instrução de desvio.
- 9
Glossário
- Arquitetura RISC - Reduced Instruction Set Computer ou Computador com um Conjunto Reduzido de Instruções (RISC), é uma linha de arquitetura de processadores que favorece um conjunto simples e pequeno de instruções que levam aproximadamente a mesma quantidade de tempo para serem executadas.
- Arquitetura CISC - (Complex Instruction Set Computer) é uma linha de arquitetura de processadores capaz de executar centenas de instruções complexas diferentes sendo, assim, extremamente versátil.
- Um pipeline consiste em uma cadeia de elementos de processamento - processos, threads, funções - dispostos de modo que a saída de cada elemento seja a entrada do próximo.
- Máquinas superescalares paralelizam a execução de instruções independentes, em cada estágio do pipeline. Caso as instruções possuam dependências, um menor número de instruções será executado por ciclo.
- Um pipeline consiste em uma cadeia de elementos de processamento - processos, threads, funções - dispostos de modo que a saída de cada elemento seja a entrada do próximo.
- Arquitetura CISC - (Complex Instruction Set Computer) é uma linha de arquitetura de processadores capaz de executar centenas de instruções complexas diferentes sendo, assim, extremamente versátil.
- 10
- Arquitetura RISC - Reduced Instruction Set Computer ou Computador com um Conjunto Reduzido de Instruções (RISC), é uma linha de arquitetura de processadores que favorece um conjunto simples e pequeno de instruções que levam aproximadamente a mesma quantidade de tempo para serem executadas.
1
Imagens e arquivos do mapa
Informações
- Descrição
- ciência da computação Mapa Mental sobre Pentium 4, criado por Abel Isack em 27-05-2022.
- Criado por
- Abel Isack
- Visualizações
- 3
- Avaliação