
Notas
Sem título
Conteúdo das notas (2)
Página 1
Fluxos continuos de dados
Adaptar seus modelos pela incorporação de novos dados
devem ser incrementais
atualizar constante o modelo que trata os dados
Cluster - conjunto de servidores interconectados, que atuam como se fossem um unico sistema e trabalham juntos para realizar tarefas de forma mais eficiente e escalonavel.
arquitetura
A definição de uma arquitetura que consegue tratar essa quantidade de dados é cobrado do profissional:
Coletar dados 'frame works para coletar", "tipos de dados", "de onde viram, api, excel, etc"
Processar os dados
Armazenar os dados
Definicação de pipe lines
Visualização de dados
-----------------------------------------------------------------------------------------
FERRAMENTE DE COLETAS DE DADOS:
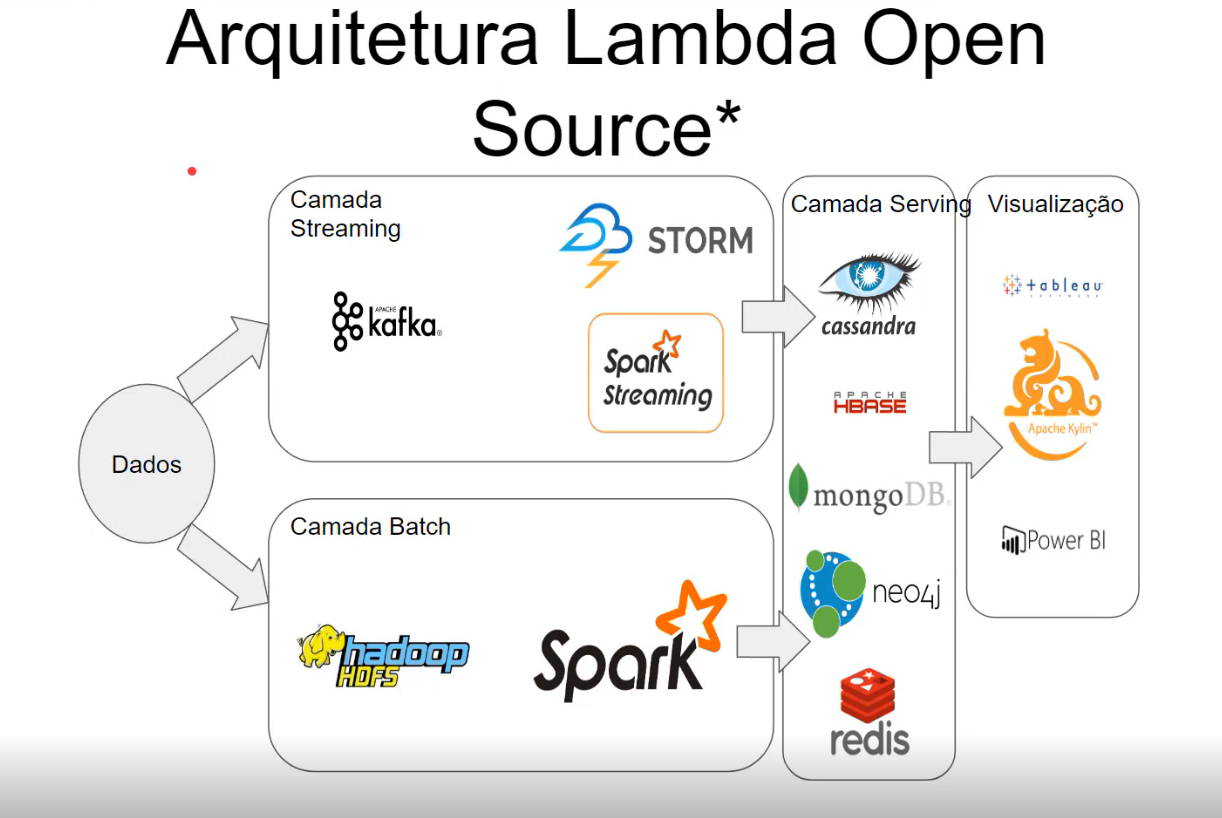
Apache Flume (sistema distribuido):
Web server --> Souce --> Channel --> Sink --> HDFS.
-----------------------------------------------------------------------------------------
Kafka (ferramente de mensageria):
plataforma distribuida de mensagens e straming.
producer kafka Consumer
mensagem ----> mensagem ----> mensagem
-----------------------------------------------------------------------------------------
Kubernets: gerenciamento de containers do docker
cluster.
-----------------------------------------------------------------------------------------
Spark:
Roda aplicações em cluster hadoop
Dstream: podemos trabalhar com dois formatos:
tempos quebrados
ou
janela de tempos
-----------------------------------------------------------------------------------------
Apache Storm (Processamento de dados - semi estruturados):
Esteira de produção em varias camadas.
-----------------------------------------------------------------------------------------
ARMAZENAMENTO DE DADOS
Principais ferramentas: NOSQL E HDFS
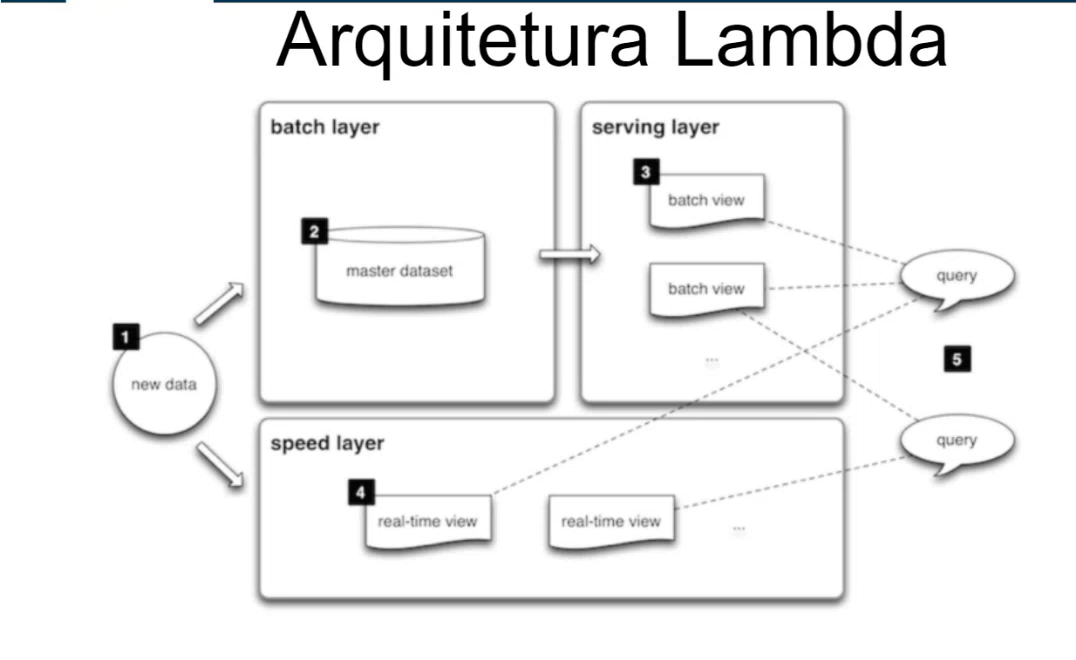
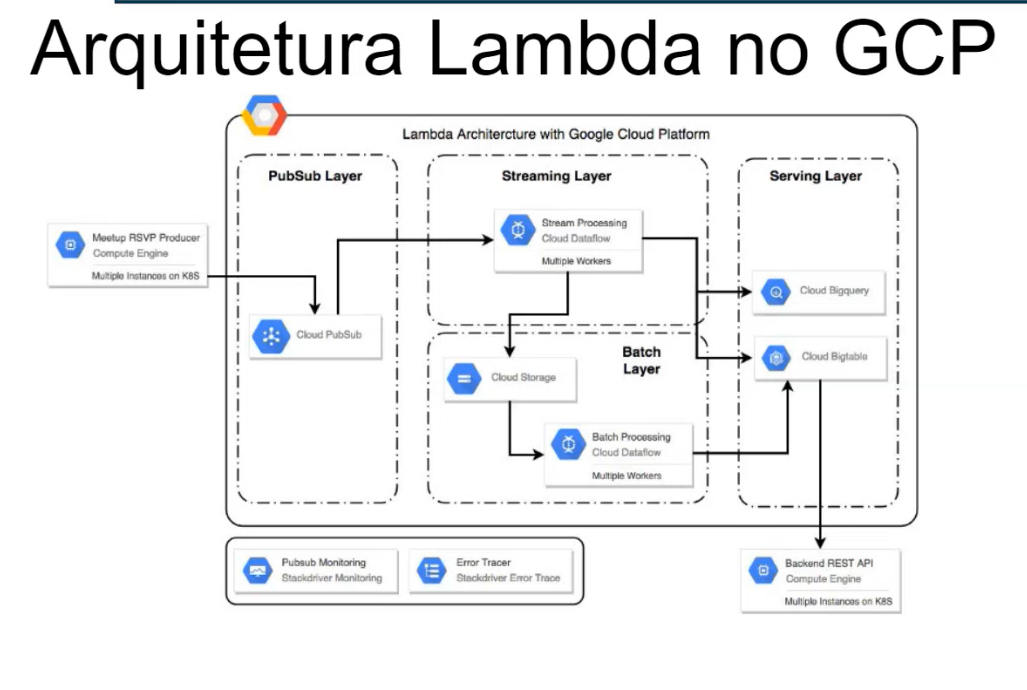
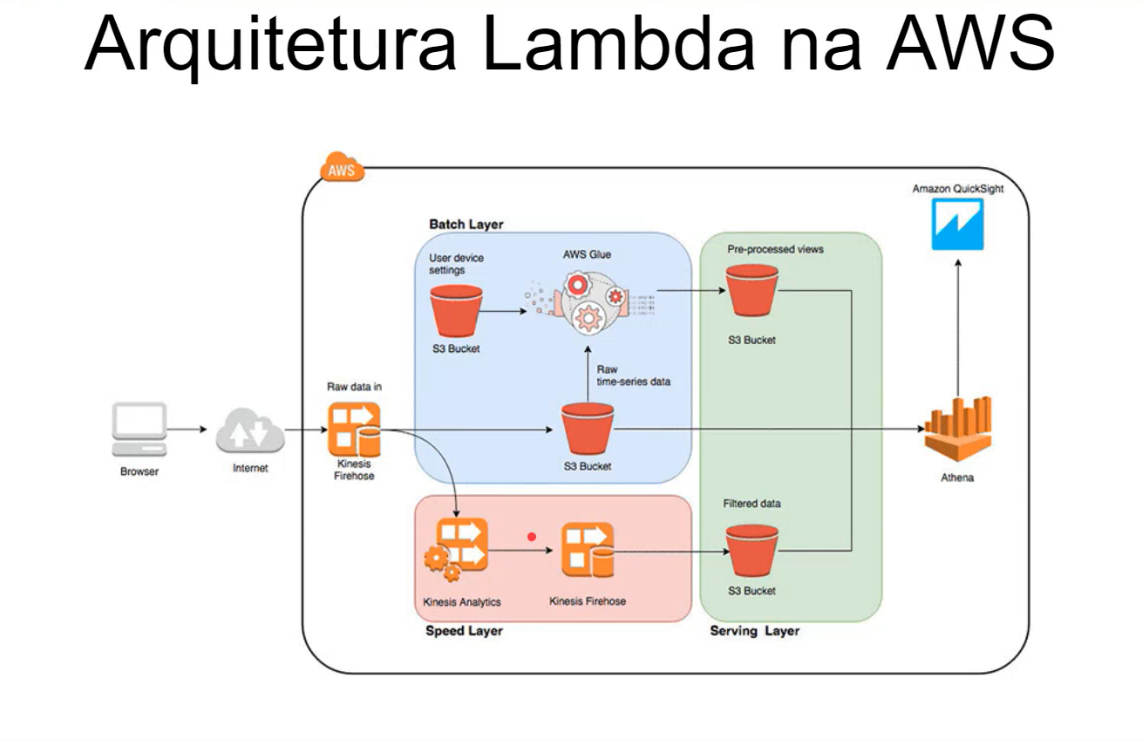
ARQUITETURA Lambda
New Data.
Batch Layer (Master Dataset) - processamentos agendados.
Camada na qual serão armazenados os dados raw(Dados brutos ou dados primários).
Esses dados podem ser gerados posteriormente para gerar novas infos
processamento com alta latencia pelo volume de dados.
Serving Layer (batch view) - aplicações em streamig (apache).
Responsavel por indexar os dados processados na parte batch e online
permite que queries ad-hoc.
bancos em tempo real - redis, mongodb, dinamodb,bigtable google.
Speed Layer (real-time view) - servir as aplicações de visualização.
Dados recebidos são processados real time.
idealmente apenas novas infos ou pequenos blocos de nvs infos
Query.
Página 2
Informações
- Descrição
- Notas sobre Sem título, criado por Gustavo Coura em 12-06-2024.
- Criado por
- Gustavo Coura · jun 2024
- Atualizado
- 17 jun 2024
- Visualizações
- 2
- Avaliação