
Karteikarten
FOST 4 - Inferenzstatistik 2 und qualitative Methoden
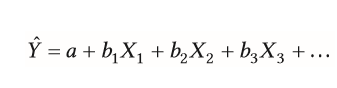
Karten in diesem Stapel (129)
- 1Regressionskoeffizienten b= Regressionsgewichte
= wie groß ist der relative Einfluss eines Prädiktor bei der Vorhersage der abhängigen Variable
(der Einfluss der anderen Prädiktoren wurde bereinigt) - 2Beta Gewicht βstandardisierter Regressionskoeffzient
- 3Aufklären von Variablen in der multiplen Regression= Summe von Variablen wollen konkreten Wert einer Person vorhersagen
X = genaue Ausprägung der Variablen - 4multiple Regression= schätzt den Wert einer Person mithilfe der Ausprägungen mehrere Prädiktorvariablen auf einer Kriteriumsvariable
- 5Güte der Vorhersage bei multipler Regression= wie gut ist das gesamte Modell für die Vorhersage des Kriteriums geeignet
- Standardschätzfehler
- multiplen Determinationskoeffizient R² - 6multiplen Determinationskoeffizient R²gibt den Anteil der Varianz des Kriteriums an, der durch alle Prädiktoren gemeinsam erklärt wird
max. Wert = 1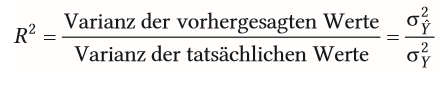
- 7Standardschätzfehler bei der multiplen Regressionwie stark weichen die vorhergesagten Werte vom tatsächlichen Wert des Kriteriums ab
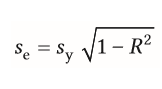
- 8Prüfung des einzelnen Regressionsgewicht auf Signifikanzt-Wert mit n -2 Freiheitsgraden auf Signifikanz prüfen
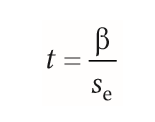
- 9Signifikanztests bei multipler Regressionwird meist drauf verzichtet, da R² gute Info darstellt
Signifikanztest für das komplette Modell: F-Test - 10t-Test= prüft, ob sich Mittelwerte signifikant unterscheiden
- Prinzip aller Signifikanztests: systematische Varianz (Mittelwertsunterschied) geteilt durch Fehlervarianz (SD) - 11t-Test bei zwei unabhängigen Stichproben= prüft die Signifikanz eines Unterschiedes
- Mittelwertsunterschied der Stichprobe wird verglichen mit Mittelwertsunterschied von H0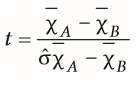
- 12kritischer t-Wert bei unabhängigen Stichprobenergibt sich aus der t-Verteilung eines bestimmten Signifikanzniveau (5 oder 1 Prozent)
- wird mit empirischen t-Wert verglichen (empirischer Wert muss extremer/absolut größer sein, um signifikant zu sein --> Effekt kann verallgemeinert werden) - 13Freiheitsgrade bei unabhängigen Stichproben
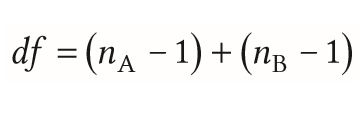
- 14Berechnung des t-Werts bei abhängigen Messungen
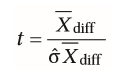
- 15t-Test bei einer Stichprobe / Einstichprobenfall= Mittelwert einer Gruppe wird gegen zweite theoretische Gruppe verglichen
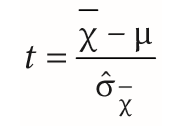
- 16Effektgrößen bei unabhängigen Stichproben- Abstandsmaß d
- Abstandsmaß g
- Korrelation r
- Korrelationskoeffizienten - 17Abstandsmaße beim t-Test (unabhängige Stichprobe)
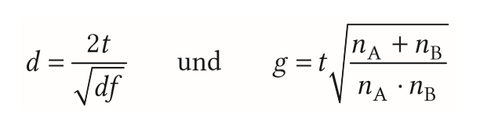
- 18Korrelation bei t-Tests (unabhängige Stichprobe)ist identisch mit Korrelationskoeffizienten
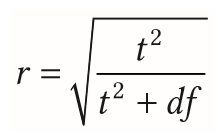
- 19Effektgrößen bei abhängigen Stichproben- Abstandsmaße d und g
identisch bei Einstichprobenfall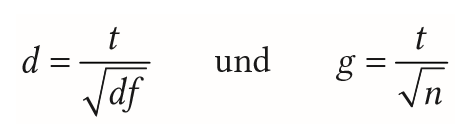
- 20Voraussetzungen beim t-Test- AV ist intervallskaliert
- Normalverteilung
- ca. gleich große Varianzen
- bei unabhängigen Stichproben: Personen beeinflussen sich nicht systematisch gegenseitig - 21Varianzanalyse (ANOVA)= Verfahren zum Vergleich von Varianzen
= Sonderform der multiplen Regression
= Vergleich mehrer Mittelwerte möglich
- UV darf nominalskaliert sein - 22einfaktorielle ANOVA= nur eine unabhängige Variable (Faktor) wird untersucht
= einfachster Fall - 23relevante Varianzen bei der einfaktoriellen ANOVA- Gesamtvarianz
- erklärte Varianz
- nicht erklärte Varianz - 24Gesamtvarianz bei einfaktorieller ANOVA= Varianz der AV
= Summe auf erklärte und nicht erklärte Varianz - 25erklärte Varianz= Varianz zwischen den Gruppen / Between Varianz / systematische Varianz
- mehrere Mittelwertsdifferenzen (Varianz der Mittelwerte), da zwischen jeder Gruppe die Differenz berechnet wird - 26unerklärte Varianz= unsystematische Varianz / Varianz innerhalb der Gruppe / Within Varianz / Fehlervarianz
- Menschen unterscheiden sich und liefern entsprechend unterschiedliche Werte
- stellt Fehler dar, der die Aussagekraft unserer Mittelwerte einschränkt - 27Maß der Streuung bei der Varianzanalyse= Quadratsummen (QS) - sind noch nicht an der Stichprobengröße relativiert
- 28Berechnung der Gesamtvarianz bei einfaktorieller ANOVA=X ist der gemeinsame Mittelwert aller Daten
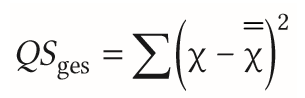
- 29Berechnung der systematischen Varianz (einfaktorielle ANOVA)= Streuung der Stichprobe
- Streuung sollte möglichst groß sein, da wir ja wollen, dass sich unsere Mittelwerte unterscheiden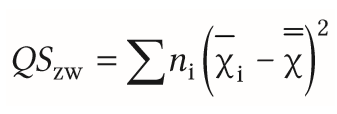
- 30Fehlervarianz bei einfaktoriellen ANOVAMittelwert der jeweiligen Gruppe wird verwendet, da wir wissen wollen wie stark die Werte innerhalb der Gruppe variieren
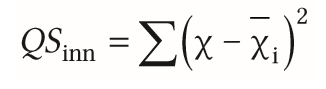
- 31Freiheitsgrade bei einfaktorieller ANOVAk = Anzahl von Gruppen
N = Gesamtstichprobe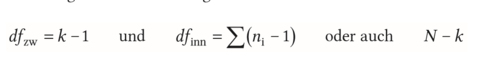
- 32F-Test und t-Testbei zwei Gruppen kommen sie zum gleichen Ergebnis (F = t²)
- F kann nicht negativ sein --> kann Richtung des Unterschieds nicht definieren
- bei mehr als 2 Gruppen kann nicht mehrmals ein t-Test durchgeführt werden, denn dadurch verdoppelt sich die Wahrscheinlichkeit des Alpha-Fehlers - 33Einzelvergleiche (Post-hoc-Tests)= Prüfen der einzelnen Mittelwerts-unterschiede auf Signifikanz im Nachhinein
- funktionieren wie t-Tests, allerdings wird Kumulation der Alpha-Fehler berücksichtigt (Alpha-Korrektur)
- so viele Einzelvergleiche wie mögliche Vergleiche - 34Ablauf der mehrfaktoriellen VarianzanalyseF-Wert Berechnen (für jede UV, dabei wird die jeweilige andere UV außer acht gelassen)
- 35Haupteffekt= Effekt der UV
= haben die einzelnen UV einen signifikanten Effekt auf die AV
- pro UV gibt es einen Haupteffekt - 36Interaktion= erkennbar ob eine gegenseitige Beeinflussung der beiden UV's vorliegt
= bedingter Mittelwertsunterschied
- nicht durch die Wirkung einzelner Haupteffekte erklärbar sondern durch deren Kombination
- nicht parallele Linien im Diagramm weisen darauf hin - 37Berechnung der InteraktionVarianz AxB = Gesamtvarianz minus alle bekannten Varianzen
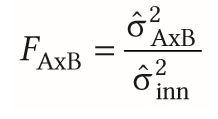
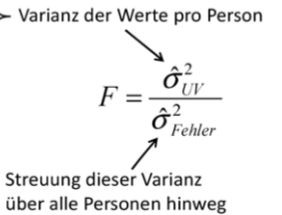
- 38Varianzanalyse mit Messwiederholungen= Abhängige Messungen
- 39Freiheitsgrade bei abhängigen Messungen (F-Verteilung)
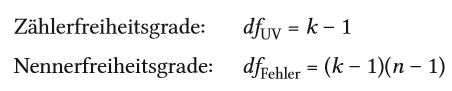
- 40Mixed Models= mehrfaktorielle Varianzanalysen, bei denen abhängige und unabhängige Messungen gemischt sind
- 41Effektgrößen bei der Varianzanalyse= Eta-Quadrat
= wie groß ist der Anteil der UV-aufgeklärten Varianz an der Gesamtvarianz - 42Eta-Quadrat bei einfaktorieller ANOVA
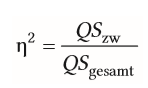
- 43Eta-Quadrat für alle Arten von Effekte- für F-Werte von Haupteffekte, Interaktionen oder Messwiederholungen
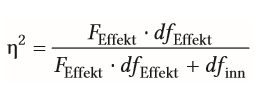
- 44partielles Eta-Quadrat ῃ²= bezieht sich nur auf einen Part bei der mehrfaktoriellen Varianzanalyse
- 45Interpretation von Eta-Quadrat ῃ²
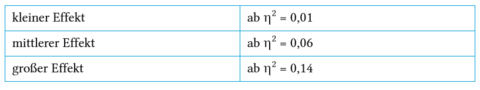
- 46Voraussetzung für Varianzanalyse- AV muss intervallskaliert
- Normalverteilung
- Varianz aller Messwerte in allen Gruppen gleich groß - 47F-Test als Signifikanztest bei Regressionsrechnung= kann das Ergebnis der Regressions-rechnung auf Population übertragen werden
- signifikantes Ergebnis = >0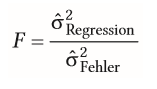
- 48erklärte Varianz zur Berechnung des F-Wertes bei der Regressionsrechnung
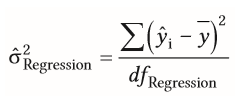
- 49Fehlervarianz zur Berechnung des F-Wertes bei der Regressionsrechnung
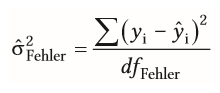
- 50Alternative zur Berechnung des F-Wertes bei Regressionsrechnung
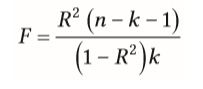
- 51Kolmogorov-Smirnov-Test= Test zur Prüfung, ob eine Normalverteilung vorliegt
- sollte nicht signifikantes Ergebnis liefern, da sich die Verteilung nicht signifikant von einer Normalverteilung unterscheidet - 52Parametrische Testverfahren= setzen Normalverteilung von Populationsparameter voraus
- daraus resultieren Berechnungen zum Mittelwert, Mittelwertsunterschied, F-Wert, t-Wert... - 53Nonparametrische / verteilungsfreihe Verfahren= machen keine Annahme über die Verteilung
- bei nominal- oder ordinalskalierten Daten & nicht normalverteilten Daten - 54Vor- und Nachteile von nonparametrische Verfahren+ Verteilungsfreiheit
+ Untersuchung sehr kleiner Stichproben
+ alle Fragestellungen können untersucht werden
- Signifikanz ist schwerer festzustellen - 55Nonparametrische Testverfahren bei Ordinalskalen- Durchführung für Zusammenhangs- und Unterschiedsfragestellungen (haben parametrische Entsprechung)
- Messwerte werden als Ränge behandelt - 56Übersicht parametrische und nonparametrischer Verfahren bei Ordinalskalen
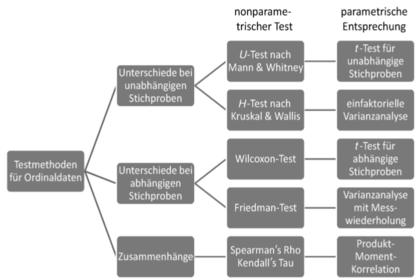
- 57Test für Unterschiede bei zwei unabhängigen Stichproben (nonparametrisches Verfahren)- U-Test nach Mann und Whitney
Maß = zentrale Tendenz = Median - 58U-Test nach Mann und Whitney (nonparametrisches Verfahren)Erstellung einer gruppenunabhängigen Rangreihenfolge --> Erstellung der Rangsumme (T) je Gruppe --> Erstellung des durchschnittliches Ranges (T/n) (=deskriptives Ergebnis)
U = Berechnung der Signifikanz des Unterschieds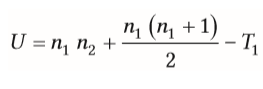
- 59empirischer Wert des U-Tests (nonparametrisches Verfahren)= kleinere Wert der beiden Gruppen
--> muss gleich oder kleiner sein als der kritische Wert (aus Tabelle) um Signifikant zu sein - 60U-Test bei großen Stichproben (nonparametrisches Verfahren)
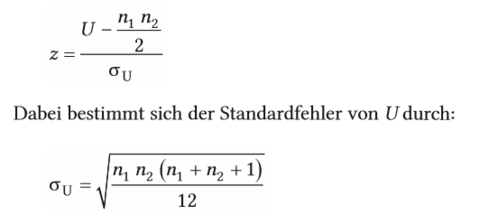
- 61Tests für Unterschiede bei mehr als wie unabhängigen Stichproben (nonparametrisches Verfahren)Vorgehen identisch wie bei 2 Stichproben --> Test ist H-Test nach Kruskal und Wallis
- bei großen Stichproben besteht eine Chi-Quadrat-Verteilung - 62Tests für Unterschiede bei zwei abhängigen Stichproben (nonparametrisches Verfahren)= Wilcoxon-Test / Vorzeichenrangtest
- Differenz zwischen Messung1 und Messung2 --> Rangreihenfolge nach steigender Differenz festlegen (Vorzeichenunabhängig, aber Kennzeichnung des Vorzeichen notwendig) --> Addition der jeweiligen Werte zu T+ und T- - 63Interpretation des Wilcoxon-Testskleinere Wert von T+ und T- wird für Signifikanzprüfung verwendet --> kleiner/gleich als kritischer T-Wert laut Tabelle
- 64Tests für Unterschiede bei mehr als zwei abhängigen Stichproben (nonparametrisches Verfahren)= Friedman-Test bzw. Rangvarianzanalyse
Ablauf: Messwertdifferenzen werden nach Rang sortiert und Rangsummen verglichen
- Prüfgröße: Chi-Quadrat - 65Tests für Zusammenhänge (nonparametrisches Verfahren)= Rangkorrelation --> korreliert die Ränge der jeweiligen Rohwerte
Bedingung: monotone Variablen - 66Ablauf der Rangkorrelation (nonparametrisches Verfahren)- Messwerte in Rangreihenfolge darstellen - Messwerte beider Variablen einzeln in Rangreihenfolge bringen! --> korreliert werden die Rangreihen beider Messgruppen
- 67Möglichkeiten der Berechnung der Rangkorrelation (nonparametrisches Verfahren)- Spearman's Rho (p)
- Kendalls Tau (τ) - 68Anwendung von Spearman's Rho (p)- intervallskalierten Daten, aber verletzte Voraussetzungen
- Anwendung als wären Abstände zwischen Ränge gleich groß --> Voraussetzung: intervallskalierte Daten
- Signifikanzprüfung mittels t-Test
- Größenordnung wird nicht beachtet - 69Berechnung von Spearman's Rho (p)d(i) = RZ(xi) - RZ (yi)
RZ= Rangzahl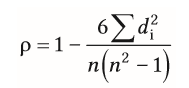
- 70Kendalls Tau (τ)setzt keine gleichen Rangintervalle voraus
- Werte zwischen -1 und 1
- Signifikanzprüfung mittels z-Test - 71Effektgrößen bei Ordinaldaten- sind nicht bestimmbar
- Unterschiedsfragestellungen: auf Signifikanztest berufen
- Zusammenhangsfragestellungen: Rangkorrelation, Interpretation wie Pearson-Korrelation - aber i.d.R. kleinere Werte - 72Anpassungstest (nominalskalierte Variable)= Chi-Quadrat-Test (X²-Test)
- prüft ob empirische Häufigkeitsverteilung mit theoretisch zu erwartenden Häufigkeitsverteilung übereinstimmt - 73Berechnung des Anpassungstestsf(b) = beobachteten Häufigkeiten
f(e) = erwarteten Häufigkeiten
wird für jede beobachtbare Häufigkeit berechnet und dann alle entsprechend addiert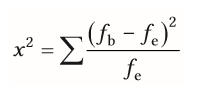
- 74Interpretation des Anpassungstests (nominalskalierte Variable)erwartete Häufigkeit = Nullhypothese
empirischer X²-Wert muss extremer als kritischer X²-Wert zu sein um signifikant zu sein
df = k - 1 - 75Goodness-of-fit-TestAnpassungstest zur Prüfung der Verteilung, vor allem bei komplexen Testverfahren
- prüft ob zwei Verteilungen deckungsgleich sind - 76Unabhängigkeitstest bei zwei nominalskalierten Variablen= prüft ob die Ausprägung einer Variable unabhängig von der Ausprägung einer anderen Variable ist
= X²-Test = k*l-X² - 77Kreuztabelle / Kontingenztabellebilden verschiedene Kombinationsmöglichkeiten der Ausprägungen der nominalskalierten
Variablen ab
k*l = Menge der Kombinationsmöglichkeiten - 78Berechnung von X² Unabhängigkeitstest (nominalskalierte Variable)Formel für beide Variablen (deswegen zwei Summenzeichen)
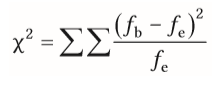
- 79Freiheitsgrade bei X² Unabhängigkeitstest (nominalskalierte Variable)df = (k-1)(l-1)
- 80Interpretation von X² Unabhängigkeitstest (nominalskalierte Variable)Test ist signifikant, wenn Häufigkeitsverteilung der einen Variable nicht unabhängig der anderen Variable ist
- 81Bestimmung der Häufigkeit, wenn keine Gleichverteilung vorliegt (X² Unabhängigkeitstest (nominalskalierte Variable))Z = Zeilensumme in Kreuztabelle
S = Spaltensummen in Kreuztabelle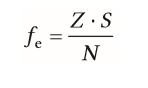
- 82Unabhängigkeitstests bei Messwiederholungen (=Mc-Nemar-X²-Test)X² = (b-c)²) / (b+c)
--> signifikantes Ergebnis = Verhältnis ist deutlich anders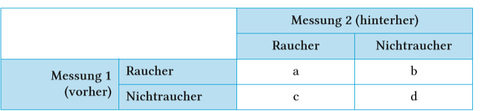
- 83Effektgröße bei Nominaldaten= Omega für alle X²-Test
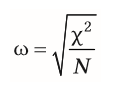
- 84Teststärke (Power)= Wahrscheinlichkeit, mit der ein vorhandener Effekt mithilfe eines Testverfahrens identifiziert werden kann
= Fläche der Alternativhypothese abzüglich Beta-Fehler --> Power = 1 - β - 85Abhängigkeit der Teststärke- Alpha-Fehler
- Stichprobengröße
- Populationseffekt - 86Festlegung der Teststärke vor der Studie--> resultiert erforderliche Stichprobengröße in Abhängigkeit von Populationseffekt und Alpha
Teststärke >0,6 bzw. 60 % - 87Bestimmung der Teststärke nach einer Studiewenn kein Effekt gefunden wurde, hilft die Teststärke um herauszufinden wie wahrscheinlich es war, überhaupt einen Effekt zu finden der tatsächlich vorhanden ist
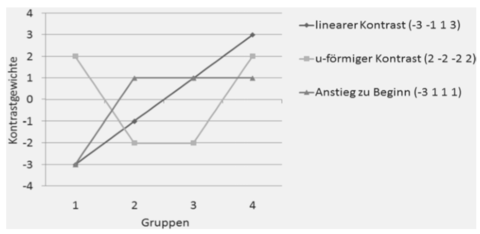
- 88Kontranstanalyse= hypothetisches Musters der Mittelwertsunterschiede von Gruppen (z.B. linear, u-förmig...) wird vor der Untersuchung festgelegt
- 89Kontrastgewichte / Lambdagewichte λ= Größe bei der Kontrastanalyse
- Muster wird vor der Untersuchung festgelegt
- Prüfung nach der Erhebung, ob eine Übereinstimmung vorhanden ist bzw. wie groß die Abweichung ist - 90Vorgehen bei der KontrastanalyseHypothese definieren
- Hypothese mit Kontrastgewichte ausdrücken, Relation ist entscheidend --> Summe muss 0 sein
- Datenerhebung
- Zuweisung & Überprüfung der Kovaration vom Lambda zum Mittelwert
- Übereinstimmung = signifikantes Ergebnis - 91Mögliche Darstellung von Kontrasten und Kontrastgewichte
- 92Kontrastanalyse bei unabhängigen Stichproben- Varianz durch Kontrast ist max, wenn beide Muster identisch sind
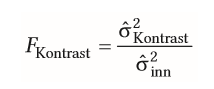
- 93F-Wert und Freiheitsgrade bei Kontrastanalyse bei unabhängigen Stichproben- F-Wert wird ebenso interpretiert wie herkömmlicher F-Wert
- kann mittels der F-Tabelle auf Signifikanz geprüft werden
- Freiheitsgrade = 1 (da nur ein Kontrast getestet wird) - 94Vorteile der Kontrastanalyse- größere Teststärke (weil Muster von Mittelwertsunterschieden geprüft werden)
- bei Zutreffen der Hypothese liefert Kontrastanalyse größeren F-Wert als Varianzanalyse --> Hypothesen müssen präzise formuliert werden
- sehr gut interpretierbare Effektgrößen - 95Effektgröße bei Kontrastanalyse für unabhängige Stichproben= Korrelation r (effect size)
- Interpretation wie Pearson-Korrelation
- F (ANOVA) = normale F-Wert Berechnung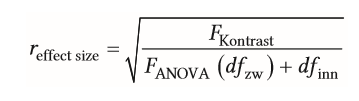
- 96einfachere Rechnung von r (effect size)- jeder Person das entsprechende Lambdagewicht zuordnen
- Lambdagewicht mit Rohdaten korrelieren - 97Kontrastanalyse für abhängige Stichproben- Muster für Varianz der Werte der einzelnen Personen über Messzeitpunkte
- Vorgehen identisch mit unabhängige Prüfung, bis:
Prüfen ob entsprechender Verlauf von Lambda bei jeder Person vorliegt --> liegt im Durchschnitt aller Personen der Trend vor - 98L-Wert= sagt aus, ob das gemessene Muster mit dem unterstellten Muster (Kontrast) bei jeder Person übereinstimmt
- L-Wert ist groß, wenn Übereinstimmung vorhanden
- wird für jede Person berechnet - 99L-Wert auf Signifikanz prüfen- Unterscheidet sich der durchschnittliche L-Wert signifikant von 0 --> Prüfung durch t-Test
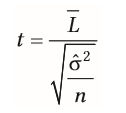
- 100Effektgröße bei der Kontrastanalyse für abhängige StichprobenHedge berechnet ob der Durchschnitt der L-Werte sich von 0 unterscheidet

- 101Berechnung bei der Metaanalyse (Unterschiedsfragestellung)- Unterschiedliche Werte der Studien auf eine gemeinsame Effektgröße bringen
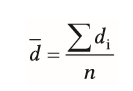
- 102vertrauenserhöhende Dinge bei der Metaanalyse- sehr viele Studien sind in die Analyse miteingeflossen
- die einzelnen Studien hatten große Stichproben
- Streuung der einzelnen Stichproben ist klein - 103Arten von multivariaten Verfahren- Faktorenanalyse
- Clusteranalyse
- Multivariate Varianzanalyse
- Multidimensionale Skalierung
- Conjoint-Analyse
- Strukturgleichungsmodelle - 104Faktorenanalyse- Reduktion vieler AV auf Faktoren und Komponenten durch Korrelation
- diese stehen stellvertretend für alle Variablen
- es gibt keine UV
- Ablauf: hohe Korrelation zwischen Variablen --> Variablen werden durch Faktor ersetzt (beschreibt alle eingeflossenen Variablen) - 105Clusteranalyse= Reduktion von Fällen (Objekten, Personen durch Zusammenfassung in Gruppen
- innerhalb einer Gruppe möglichst ähnlich, zwischen den Gruppen möglichst unähnlich
- keine UV - 106Multivariate Varianzanalyse (MANOVA)= prüft den Effekt einer oder mehrer UV auf mehr als eine AV
- Ablauf: Overall-Analyse --> keine Signifikanz = keine weiteren Berechnungen
--> Signifikanz = mehrere normale ANOVA für jede AV - 107Multidimensionale Skalierung (MDS)= Ähnlichkeitsbeurteilung, von Personen für Objekte --> Ableitung: Anzahl und Art der Bewertngsdimensionen
- Auffinden der relevanten AV
Ablauf: Anzahl der Dimensionen festlegen (2-3) --> wo liegen Objekte in den Dimensionen --> Dimensionen interpretieren - 108Conjoint-Analyse / Verbundanalyse= prüft den relativen Einfluss eines Merkmals / Merkmalsausprägung zur Bewertung von Objekten durch eine Person
- meist durch Präferenzanalyse - 109Strukturgleichungsmodelle= Kombination aus Faktorenanalyse und Regressionsanalysen
- bilden komplexe Zusammenhänge zwischen (meist latenten) Variablen
- dienen der Überprüfung sozialwissenschaftlicher Modelle & Theorien - 110quantitative / konventionelle MethodenPhänomene des Erleben und Verhalten in Zahlen ausgedrückt
- 111PositivismusPhänomene des Erlebens und Verhaltens, die wir beobachten und erforschen
- 112Qualitative MethodenPhänomene des Erleben und Verhalten qualitativ bewerten
- Datengrundlage: Text, analysiert nach übergeordneten Bedeutungen und Sinnstrukturen
- keine Zahlen, Skalen und Kennwerte - 113qualitative Forschungsprozess- mit oder ohne gezielter Fragestellung ;
bei gezielter Fragestellung:
- Daten sammeln (meist Texte, Bilder)
- nach jeweiligen qualitativen Methode auswerten
- Daten verwenden oder ggf. erneute Datensammlung - 114explorativer Charakter eines Forschungsprozessneues inhaltliches Gebiet wird erforscht
- 115Besonderheit des qualitativen Forschungsprozess- der Mensch übernimmt die Auswertung
--> aber: Subjektivität?! - 116Entkräftigung der Subjektivität bei qualitativer Forschung- läuft nicht beliebig ab, sondern auch nach bestimmten Regeln und mit mehreren Personen (--> stärt Objektivität)
- auch quantitative Forschung ist nicht frei von Subjektivität - 117Anwendungsfelder der qualitativen Forschung- immer Abhängig von der Fragestellung
- als Ergänzung / Bereichung der quantitativen Methoden bei bestimmten Fragestellungen - 118Methoden der qualitativen Forschung- qualitative Inhaltsanalyse
- Grounded Theory
- Diskursanalyse - 119Qualitative Inhaltsanalyse- folg am ehesten dem herkömmlichen Forschungsprozess; gut kombinierbar mit quantitativen Methoden
- relativ konkrete Fragestellung
- Datenmaterial: Alle Formen von Texte
- Ziel: zusammenfassende Beschreibung des Textmaterials & Auffinden von Strukturen aus dem Text - 120Prozess der qualitativen Inhaltsanalyse- Erstellen der Texte
- Zusammenfassen in Kurztext
- Erstellen von Kategorien, die für die Fragestellung relevant sind (--> theoriegeleitete Inhaltsanalyse) - 121Anwendung von qualitativer Inhaltsanalyse- bei subjektivem Erleben
- Sinnzusammenhänge
- Eindrücke
- Meinungen
welche nicht quantitativ erfasst werden können - 122Grounded Theory- strukturierte & differenzierter qualitativer Ansatz
- keine Fragestellung gegeben --> neue Theorien / Hypothesen finden
- Datengrundlage: Alle Formen von Texte
- alles wird immer protokolliert, um nachvollziehen zu können, warum der Forscher diese Schlüsse gezogen hat - 123Codieren bei der Grounded Theory- zeilenweises Codieren (--> größtmögliche Objektivität)
- fokussiertes Codieren (kleine Bedeutungseinheiten aus dem zeilenweisen Codieren werden zu Kategorien zusammengefasst) - 124theoretical sampling (Grounded Theory)- wenn nach allen analysierten ITW noch Infos fehlen / Unklarheiten bestehen --> weitere ITW werden geführt mit Personen bei denen man glaubt, dass diese die Antworten liefern könnten.
- wird so lange gemacht, bis alle offenen Punkte beseitigt wurden - 125Anwendung der Grounded Theory- Sachverhalte des subjektiven Erlebens, welche neu erforscht werden
- 126Diskursanalyse- Analyse des Konstruktivismus
- Datenmaterial: alle Arten von aufgezeichneter Sprache
- Ziel: Beantwortung bestimmter Fragestellungen (praktisches Problem oder theoretische Frage) - 127Prozess der Diskursanalyse- Text lesen --> Codierung auf Relevanz für Ausgangsfrage --> Zentrale Aussagen suchen (auch zwischen den Zeilen lesen, z.B. Grammatik, Metapher...)
Ziel: Auffinden übergeordneter Muster oder Vorstellungen, die in der Denkweise des Verfasser verankert sind - 128Vor- und Nachteile der qualitativen Methoden+ größere Flexibilität --> unvoreingenommen für Thema & keine Themen übersehen möchte
+ einbeziehen des Kontext & zusätzlicher Infos
- ungenau und objektiv nicht mehr nachvollziehbarer Umgang mit Daten, Einfluss der Subjektivität zu hoch - 129Schwierigkeiten der qualitativen Forschung- kaum konkrete Handlungsanweisungen
- sehr großer Aufwand für ein / mehrere Forscher
--> Kombination aus qualitativer und quantitativer Forschung
Informationen
- Beschreibung
- FOST (FOST 1 -4) Karteikarten am FOST 4 - Inferenzstatistik 2 und qualitative Methoden , erstellt von Kathy H am 13/08/2016.
- Erstellt von
- Kathy H
- Aufrufe
- 333
- Tags
- Bewertung