
Notizen
Granges e biostrings
Inhalt der Notizen (7)
Seite 1
o GRanges é uma extensão do IRanges para o meio genomico.
as sequencias geralmente correspondem aos cromossomos.
a funcão shift se relaciona com o final do cromossomo então vai para a direita e a função narrow se relaciona com o inicio do cromossomo então vai para a esquerda.
a coluna do matadados pode ser acessada usando a função mcols
como adicionar mcols: exemplo generico: mcolsgr)$value <- (-1,4) e isso é atribuido a cada objeto GRanges na lista.
tem um package adicional que é chamado GRanges list. É um objeto no qual há rupos de Granges juntos.
Uma ves que criamos sets de objetos GRanges ou GRangesList, uma coisa em comum é que o que podemos precisar fazer é achar sobreposições entre os objetos. Podemos definir quantos IRanges o objeto vai ter fazendo [,x,y]
usamos a função findOverlaps() para achar overlaps
usamos a função countOverlaps() para contar quantos overlaps temos.
quando fazemos ex: gr1 %over% gr2 então nos "interceptamos" os dois
o Rle é definido pelo IRanges mas tambpem tem um objeto similar na basr r o qual é uma codificação de comprimento da linha "run length encoding". O significado disso é que se você tem um vetor no qual repete certos valores, você pode poupar memoria. No lugar de armazenar cada valor, você salva o numero e então o numero de vezes que esse numero foi repetido.
ex: se você tem um vetor com valores repetidos, e salvarmos isso como Rle, sando a Rle function, vemos que é representado em uma forma compacta, os valores e os comprimentos que cada valor é repetido.
emos um Rle e queremos ver dentro de diferentes regioes, podemos contruir um "view" dos objetos. usando a função view. essa função contem um subjeto, um numero de views que são essencialmente IRanges dentro desse objeto.
Exemplo: tivemos o RLe r, e vamos dizer que queremos criar 2 views que tem inicio e fim.
Seite 2
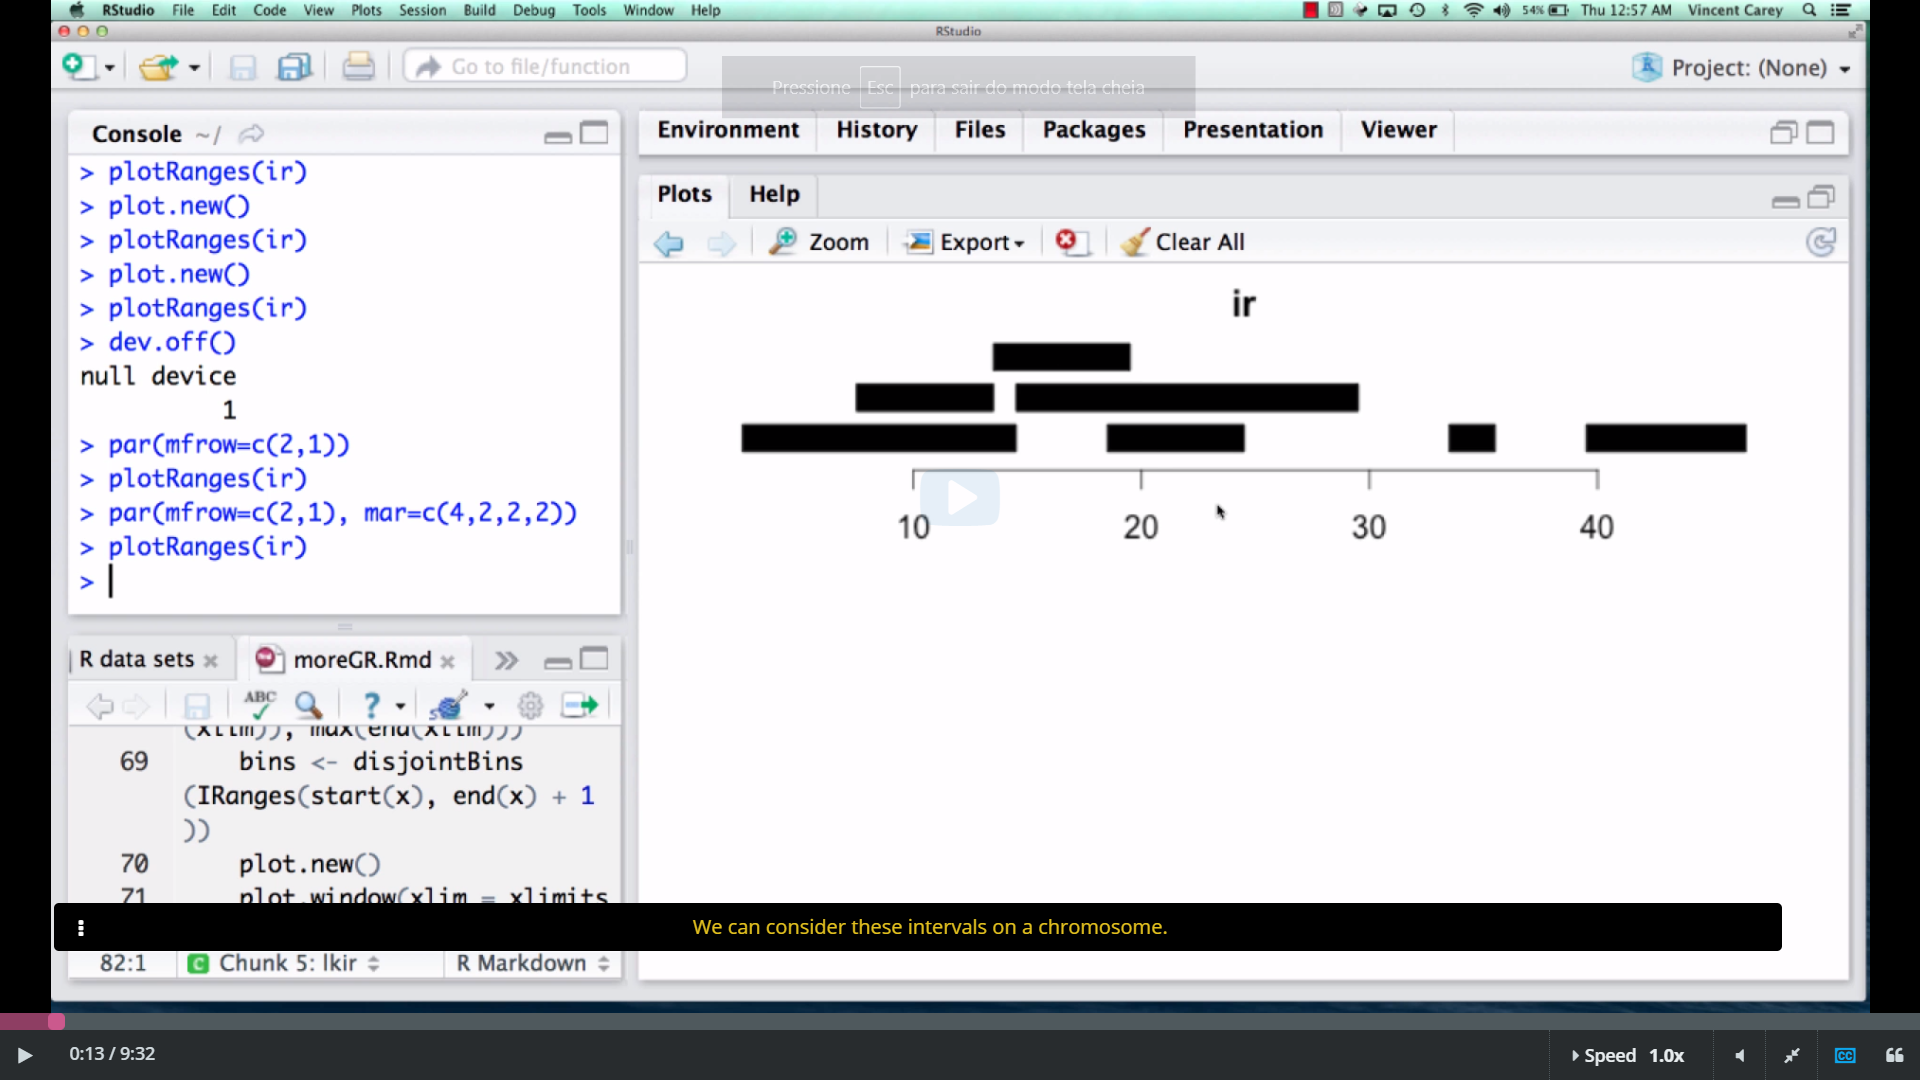
olhe a imagem 1 para ver intervalos nos cromossomos.
função plotRanges(reduce(data)): torna as bases em continuos intervalos e deixa vazio somente essas partes onde não há cobertura por qualquer um dos intervalos originais.
também dá para fazer com o disjoin. é so fazer: plotRanges(disjoin(data))
aoperação reduce é para reduzir a complexidade.
gaps operation: plotRanges(gaps(data)) : se você quiser também pode colocar um limite que é: plotRanges(gaps(data), xlim=c(0, 60))
no caso, quando há uma area que é um grafico diferente do vetor original que foi criado de primeira, o grafico secundário, que você criou depois, ai representar a região do gene que não vai ser expressa. no caso do gaps.
se quisermos adicionar os simbolos + e -, então podemos usar a função rep(+, 0) o zero nessa função representa um numero da sua escolha que pode ser usado para indicar em quantas linhas você quer que a repetição apareça. eve fazer isso duas vezes se quiser definir simbolos diferentes para as linhas do inicio e do fim.
se quisermos definir um genoma, podemos usar a função: genome(data) = "nome do genoma"
resize(): mostra o start de cada intervalo
se quisermor adicionar cor: dentro de uma função que provavelmente será um plot pois estamos falando de gráficos, colocaremos: col="a cor que você quer"
No flank, o primeiro argumento é o data, o segundo é o length e o terceiro é sua escolha. pode usar por exemplo: start=false que meio que "não vai começar do inicio".
Seite 3
achando overlaps
primeiramente, vamos criar uma lista que inclui os sites em comum a ambos os GRanges. nesse caso, queremos achar os sites que estao no HepG2 GRange e no GM12878 GRange.
para isso usamos a funcao findoverlaps.
usar a funcao queryHits
funcao grangres e extrai somente as regioes.
Seite 4
Genes como GRanges
extraimos genes usando a funçao genes
um exemplo de como fazer isso e: ghs=genes(homo.sapiens)
ghs e um vetor generico e genes e nossa funçao que extrai genes. o intervalo dado pela coluna do IRanges vai ser o inicio e o fim.
o ID e para combinar informaçao do gene atraves de diferentes databeses.
strand: o strand te conta em qual das duas fitas de dna o gene esta.
quando a expressao do gene acontece, o dna se abre. e o codigo para um gene pode estar em cada fita. O movimento de transcriçao vai em uma certa direçao.
se voce esta em uma fita, voce vai começar de um grande numero para um numero menor em termos de local.
isso significa que nesse gene a transcriçao começa nesse local porque esta em uma fita negativa (no exemplo) e entao começa a se mover e completa nesse lugar (olhando para a coluna ranges que tem o iranges com o começo e fim)
na fita negativa o começo e o segundo numero
na fita positiva"plus" começa no primeiro numero.
funçao precede nos temos um query em um subject que vai achar a entrada e o query que esta mais perto do subject
Seite 5
achando o gene mais proximo
se queremos computar a distancia entre cada binding site seu gene correspondente achado com a funçao precede, ha outra funçao chamada distance que faz isso. nesse caso, as sobreposiçoes nao aparecem porque estamos colocando os genes que foram achados com o precede.
depois, vamos pedir por cada binding site, vamos achar o start da transcriçao que é mais proximo. so para lembrar que esse começo e fim se refere aos dois numeros do iranges que são definidos pela fita negativa como o segundo e pela fita positiva como o primeiro. quando você faz isso, ele vai em direçao ao start pois você so colocou 1. quando voce faz isso, voce tem o tss dos genes.
funçao resize que os genes do GRanges tem somente um par de bases. voce pode fazer isso da seguinte forma: criar um vetor e depois usar a funçao resize. dentro dos parenteses, coloca o data, uma virgula e o numero de pares de bases que você quer.
a funçao values vai extrair os valores que não são querys ou subjects. é assim que vamos extrair a distancia.
ex: values(d)$distance
quando a distancia é zero, então é porque estão sobrepostos.
depois de achar o tss, queremos para cada um nossos binding sites, queremos achar o valor mais perto do transcription start site. ai usamos a função distancetoneartest. o que essa função faz é achar a distancia do query mais proximo e do subject mais proximo ao query. depois de usar essa função, o valor que obtemos é o mais proximo do transcription start site agora vamos obter zeros porque se sobrepoe.
se quisermos podemos fazer um histogram com a função hist e colocar dentro, os values citados ali em cima.
depois de fazer isso, vamos ter muitos sites do nosso interesse. tambem podemos definir um limite para x usando xlim. o resultado deve ser que muitos dos sites são proximos aos valores start de transcrição. isso é uma boa coisa porque
se quisermos olhar os genes que são proximos art transcription primeiro criar um vetor chamado index
e usar a função subjecthits para acha-los.
se quisermos definir o quão proximo estão, podemos usar; [dist < 1000[ por exemplo (com o colchetes virado para o outro lado)
Seite 6
anotação sobre os genes.
vamos usar a função select para ter o query da database homosapiens.
então usamos select, colocamos o homo.sapiens, uma virgula e depois usar as keys. usando o index que criamos antes por exemplo, que está dentro do tssgr, um vetor generico, achamos os genes que são muito proximos.
na verdade o GENEID ja tem isso mas fazemos isso so para confirmar.
podemos usar key.types para ver os tipos que estão disponiveis no homo.sapiens
vamos usar o key.types que ja temos. para achar eles, usamos values(tssgr[index[)$GENEID
os valores encontrados vao ser nossas keys. como tem que ser um caracter, vamos torna-lo em um caracter com: as.character.
então fica assim: keys= as.character(values(tssgr[index[$GENEID)
agora, qual informação desses genes você quer
para extrair isso, vamos usar: select(sapiens, keys=keys, keytype="GENEID")
para ver as colunas do homo.sapiens, fazemos: columns(homo.sapiens)
para achar o SYMBOL, podemos fazer: res = select(homo.sapiens, keys=keys, columns=c("SYMBOL","GENENAME"), keytype="GENEID")
as duas primeiras linhas incluem exatamente o gene que estamos estudando.
o segundo gene da lista foi o mais proximo de um dos nossos binding sites
Seite 7
Informationen
- Beschreibung
- Notiz am Granges e biostrings, erstellt von letticia mallory am 12/07/2020.
- Erstellt von
- letticia mallory
- Aufrufe
- 2
- Bewertung