
Mapa mental
ciencia de datos

Conteúdo do mapa
ciencia de datos
DATOS
- transaccionales
- Son aquellos generados a partir de transacciones o interacciones específicas en un sistema.
- Compra en una tienda: fecha, producto comprado, cantidad, precio total. Movimiento bancario: monto, cuenta origen, cuenta destino, fecha.
- Son aquellos generados a partir de transacciones o interacciones específicas en un sistema.
- No transaccionales
- Son datos estáticos o de referencia, que no se generan directamente de una transacción
- Información de clientes: nombre, dirección, correo electrónico. Catálogos de productos: descripción, precio base, categoría.
- Son datos estáticos o de referencia, que no se generan directamente de una transacción
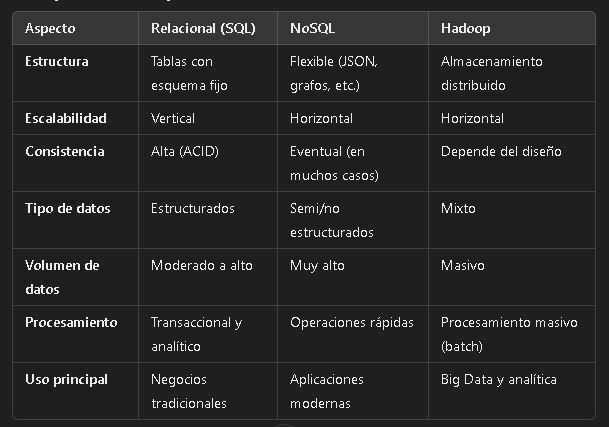
- No Sql v Sql
- bases de datos hibridas
- Microsoft Azure Cosmos
- Microsoft Azure
- Google Cloud Firestore
- Amazon Aurora
- bases de datos hibridas
- Perspectiva sobre los datos
- estructurados
- Se pueden almacenar, organizar, buscar, reordenar, combinar fácilmente con otros datos estructurados
- no estructurados
- Son datos en los que cada instancia del conjunto de datos puede tener su propia estructura interna ,y esa estructuras no son las misma de otras instancias
- Correos, mensajes de texto, publicaciones, novelas, archivos, sonido, imagen, música, novela
- Son datos en los que cada instancia del conjunto de datos puede tener su propia estructura interna ,y esa estructuras no son las misma de otras instancias
- estructurados
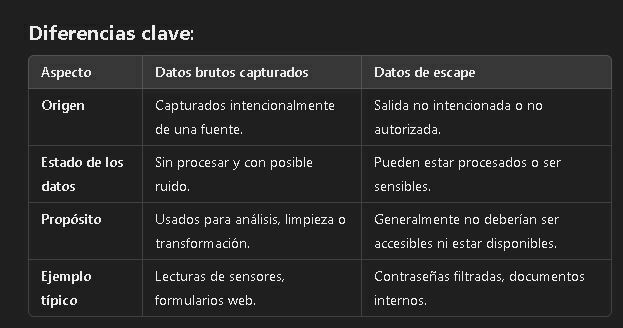
- datos brutos
- escape
- metadatos
- capturados
- escape
- datos derivados
- Aplicación de una función a los datos brutos originales
- transaccionales
Actualmente, están más alineados con él enfoque de aprendizaje automático que construir modelos de predicción y menos preocupados por el enfoque estadístico
Habilidades para un científico de datos
- Visualización de datos
- Experiencia de dominio
- comunicación
- Tratamiento de datos y base de datos
- Estadística y probabilidad
- Ética y regulación de datos
- Computación e informática
- Aprendizaje automático
HPC((High-Performance Computing
- computación de alto rendimiento,
Dato importante
- No tiene sentido ejecutar un proyecto brillante de ciencia de datos a menos de que sé utilicen y comuniquen los resultados de este de tal manera que los colegas con antecedentes no técnicos puedan comprenderlos y confiar en ellos.
- Es importante conocer los atributos importantes en un dominio.
- Numéricos(intervalo o razón), nominales, ordinales
- numericos
- operaciones aritmeticas
- Análisis estadísticos
- Valor medio
- Varianza y desviación estándar
- numericos
- Numéricos(intervalo o razón), nominales, ordinales
- La mayor parte del tiempo y esfuerzo en proyectos de ciencia de datos se dedica a crear, limpiar y actualizar el registro analitico
- Incluir atributos irrelevantes o redundantes puede tener un efecto negativo en el rendimiento de muchos de los algoritmos utilizados para analizar datos
- El valor real de un proyecto de ciencia de datos es la identificación de uno o más atributos derivados importantes que brindan información sobre un problema
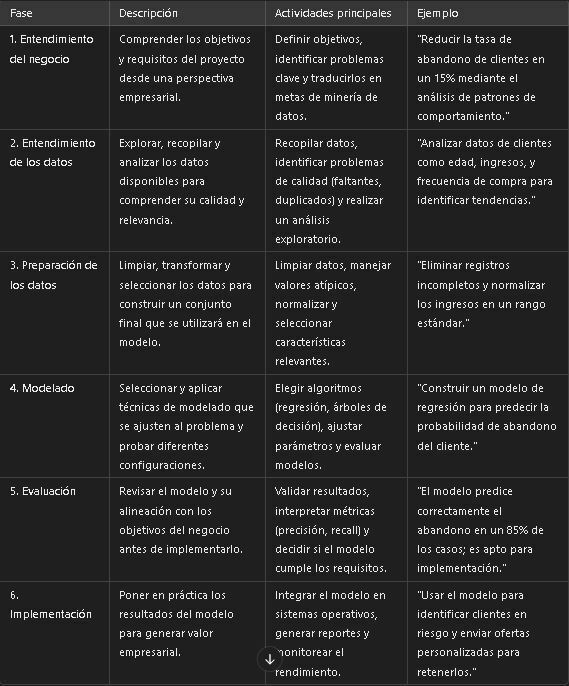
- El proceso crisp-DM
- Mueva los algoritmos a los datos en lugar de los datos Alos algoritmos
Conjuntos de datos
- Contiene un conjunto de instancias, se describe mediante un conjunto de atributos
- Instancia ,entidad, caso, individuos,registro
- a esto se le llaman a las filas
- atributos
- columnas
- Instancia ,entidad, caso, individuos,registro
- Contiene un conjunto de instancias, se describe mediante un conjunto de atributos
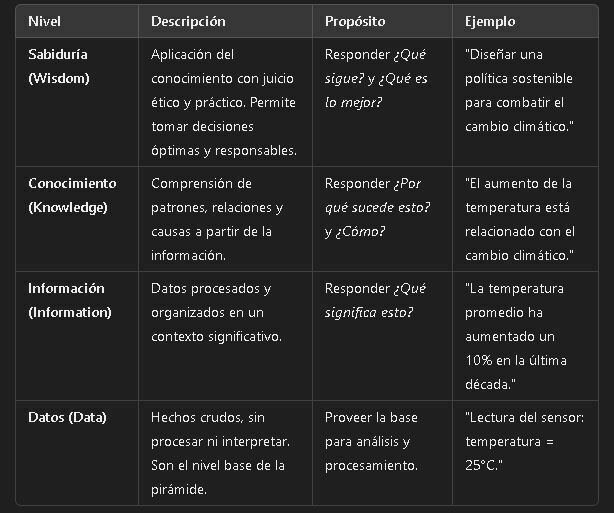
jerarquia dikw
Ecosistema de datos
- Arquitectura de datos típicos
- áreas
- fuentes de datos
- Incluyen gestión de clientes, pedidos, fabricación, banca, finanzas, gestión de relaciones con clientes(cmr), centro de llamadas, aplicaciones de planificación de recursos empresariales
- Cuando el volumen de los datos capturados aumenta
- Los datos recientemente que ingresan se les llama fuentes de big data
- big data
- 3v
- Velocidad a la que debe procesarse
- Variedad de tipos de datos
- Volumen de tipos de datos
- ejemplos
- Tráfico de red, registro de varias aplicaciones ,datos de sensores ,datos de weblog,redes sociales,datos de sitios web
- Mover algoritmos a los datos
- se puede pasar una cantidad de tiempo considerable simplemnte moviendo los datos fuera de la base de datos y volviendo a mover los resultados a la base de datos
- Los algoritmos de aprendizaje automático se han integrado en bases de datos modernas
- ventajas
- no hay necesidad de mover datos
- alta seguridad
- escalabilidad
- rendimiento mas rapido
- Despliegue y entornos en tiempo real
- ventajas
- Los algoritmos de aprendizaje automático se han integrado en bases de datos modernas
- se puede pasar una cantidad de tiempo considerable simplemnte moviendo los datos fuera de la base de datos y volviendo a mover los resultados a la base de datos
- Mover algoritmos a los datos
- Tráfico de red, registro de varias aplicaciones ,datos de sensores ,datos de weblog,redes sociales,datos de sitios web
- hadoop
- Plataforma de código abierto
- Otra plataformas de big data
- storm
- Procesamientos de datos en tiempo real
- ejemplos
- Procesamiento de transacciones financieras
- GPS
- YOUTU ,NETFLIX
- ejemplos
- Procesamientos de datos en tiempo real
- spark
- hibrido
- por lotes y flujo
- hibrido
- flink
- hibrido
- por lotes y flujo
- hibrido
- storm
- Otra plataformas de big data
- Procesamiento por lotes de datos
- EJEMPLOS
- nominas
- Facturación mensual
- Copias de seguridad de sistemas
- EJEMPLOS
- Plataforma de código abierto
- 3v
- big data
- Los datos recientemente que ingresan se les llama fuentes de big data
- tradicionales
- Cuando el volumen de los datos capturados aumenta
- Incluyen gestión de clientes, pedidos, fabricación, banca, finanzas, gestión de relaciones con clientes(cmr), centro de llamadas, aplicaciones de planificación de recursos empresariales
- almacenamiento de datos
- Proceso de agregación y análisis de datos con el objetivo de apoyar a la toma de decisiones
- 2 partes
- Software de intercambio de datos
- Sistemas de gestión de bases de datos relacionales (RDBMS)
- Columna vertebral
- Soluciones de inteligencia artificial
- Es un sistema de soporte de decisiones fácil de usar que proporciona agregación, integración e informes de datos ,así como funcionalidad de analisis
- Soluciones de inteligencia artificial
- Columna vertebral
- Sistemas de gestión de bases de datos relacionales (RDBMS)
- Administrar los datos producidos por las fuentes del big data
- Hadoop (es un marco de código abierto)
- Acelera el procesamiento de consultas en grandes conjuntos de datos
- Dividir, aplicar, combinar
- Utilizando sql podemos consultar tanto
- alamacen de datos
- datos hadoop
- Ambos se combinan automaticamente
- Utilizando sql podemos consultar tanto
- Dividir, aplicar, combinar
- Almacenar más de 10 años de datos
- Acelera el procesamiento de consultas en grandes conjuntos de datos
- Hadoop (es un marco de código abierto)
- Software de intercambio de datos
- 2 partes
- Proceso de agregación y análisis de datos con el objetivo de apoyar a la toma de decisiones
- aplicaciones
- Incluyen gestión de clientes, pedidos, fabricación, banca, finanzas, gestión de relaciones con clientes(cmr), centro de llamadas, aplicaciones de planificación de recursos empresariales
- OLAP(procesamiento analitico en linea)
- se representan
- en cubos
- conjunto fijo y predefinido de dimensiones
- En cada dimensión representa una característica particular de los datos
- conjunto fijo y predefinido de dimensiones
- en cubos
- Recuerda que es una tecnología o enfoque que interactuar tanto en las aplicaciones y en el almacenamiento de datos
- se representan
- OLAP(procesamiento analitico en linea)
- Incluyen gestión de clientes, pedidos, fabricación, banca, finanzas, gestión de relaciones con clientes(cmr), centro de llamadas, aplicaciones de planificación de recursos empresariales
- fuentes de datos
- áreas
- Arquitectura de datos típicos
transformacion de datos
- Suavización
- suavizacion exponencial
- Suavización por agrupación
- media movil
- Concretization
- poner los datos en intervalos
- Categorías con etiquetas
- normalización
- min -max normalizacion
- Z-score normalization
- Suavización
Las bases de datos modernas
- pueden almacenar y consultar datos en una variedad de formatos diferentes, además de los formatos tradicionales ,además se puede definir objetos, almacenar documentos ,consultar objetos json, datos espaciales
- Viene con varias funciones estadísticas
- pueden almacenar y consultar datos en una variedad de formatos diferentes, además de los formatos tradicionales ,además se puede definir objetos, almacenar documentos ,consultar objetos json, datos espaciales
Modelos de predicción de aprendizaje
- Correlación de Pearson
- es una forma de medir qué tan fuerte es la relación entre dos variables
- R
- 1
- Correlación perfecta de atributos
- Si el puntaje está cerca de 1, significa que cuando una variable sube, la otra también sube de manera consistente (relación positiva).
- Correlación perfecta de atributos
- -1
- Correlación negativa perfecta
- Si el puntaje está cerca de -1, significa que cuando una variable sube, la otra baja de manera consistente (relación negativa).
- Correlación negativa perfecta
- 0
- no hay relación de atributos
- + - 0,7
- Relación lineal fuerte
- + - 0,5
- Relación lineal moderada
- +-0,3
- relacion debil
- coefisiente person
- 1
- Un atributo derivado de entrada puede tener una correlación mas alta con un atributo de destino
- R
- Es una técnica de estadística
- es una forma de medir qué tan fuerte es la relación entre dos variables
- regresion lineal
- se enfoca en modelar una relaciona asumida entre atributos con el propósito de poder estimar el valor del atributo destino
- Funcionan mejor con entradas numéricas
- se enfoca en modelar una relaciona asumida entre atributos con el propósito de poder estimar el valor del atributo destino
- redes neuronales
- es un sistema de computación que funciona como el cerebro humano. Está formada por "neuronas" artificiales, son pequeñas unidades que procesan información. Estas neuronas están conectadas entre sí en varias capas.
- capas
- Entrada: Le das datos a la red, como una imagen o texto
- Procesamiento: Cada capa de la red analiza los datos y extrae información importante
- funcionan mejor con entradas numéricas
- Salida: Da un resultado, como identificar qué hay en una foto o traducir un idioma.
- Una red neuronal simple
- solo tiene una capa oculta
- Red neuronal profunda
- tiene varias capas ocultas
- capas
- es un sistema de computación que funciona como el cerebro humano. Está formada por "neuronas" artificiales, son pequeñas unidades que procesan información. Estas neuronas están conectadas entre sí en varias capas.
- arbol de decisiones
- Funcionan mejor cuando son cualitativos ( nominales y ordinales)
- El objetivo de un algoritmo de aprendizaje de árbol de decisión es encontrar un conjunto de reglas de clasificación que dividan el conjunto de datos de entrenamiento en conjuntos de instancias que tengan el mismo valor para el atributo de destino.
- Funcionan mejor cuando son cualitativos ( nominales y ordinales)
- Correlación de Pearson
Crear la tabla de base analitica
- Eliminar características redundantes puede dar como resultado modelos más simples
- Aprendizaje
- supervisado
- Aprender con ejemplos y respuestas claras.
- Tiene datos de entrada, etiquetas o respuestas correctas
- el objetivo del modelo es aprender la relación de las etiquetas con los datos,para predecir la respuesta correcta de otros datos nuevos
- Requiere intervención humana para definir análisis y relaciones.
- ejemplos
- algoritmos
- Análisis de Clústeres
- Modelos de Mezclas Gaussianas
- Análisis de Componentes Principales
- algoritmos
- ejemplos
- Requiere intervención humana para definir análisis y relaciones.
- el objetivo del modelo es aprender la relación de las etiquetas con los datos,para predecir la respuesta correcta de otros datos nuevos
- Tiene datos de entrada, etiquetas o respuestas correctas
- Aprender con ejemplos y respuestas claras.
- y no supervisado
- Buscar patrones sin saber las respuestas de antemano.
- No hay atributo destino
- No se invierten esfuerzo en etiquetar las instancias del conjunto de datos con el conjunto destino
- uso de algoritmos
- ejemplos
- regresion lineal
- Regresión Logística
- Árboles de Decisión
- Redes Neuronales
- agrupados
- Busca instancias similares
- ejemplos
- uso de algoritmos
- No se invierten esfuerzo en etiquetar las instancias del conjunto de datos con el conjunto destino
- No hay atributo destino
- desafío
- Es encontrar el algoritmo cuyo sesgo de aprendizaje sea la mejor coincidencia para un conjunto de datos en particular
- Buscar patrones sin saber las respuestas de antemano.
- supervisado
- Aprendizaje
- Eliminar características redundantes puede dar como resultado modelos más simples
Tareas estándar de ciencia de datos
- Agrupamiento (Clustering)
- es una técnica de aprendizaje no supervisado que organiza un conjunto de datos en grupos (o clústeres) de manera que los elementos dentro de un grupo sean más similares entre sí que a los de otros grupos.
- obejtivo
- Descubrir patrones o estructuras ocultas en los datos sin usar etiquetas
- Ejemplos de algoritmos
- K-means:
- DBSCAN
- Hierarchical Clustering
- Ejemplos de algoritmos
- Aplicaciones: Segmentación de clientes. Identificación de temas en textos. Clasificación de imágenes en grupos similares.
- Descubrir patrones o estructuras ocultas en los datos sin usar etiquetas
- obejtivo
- es una técnica de aprendizaje no supervisado que organiza un conjunto de datos en grupos (o clústeres) de manera que los elementos dentro de un grupo sean más similares entre sí que a los de otros grupos.
- Detección de anomalías:
- dentifica puntos de datos que son significativamente diferentes del resto.
- Objetivo
- algoritmos
- Isolation Forest
- Autoencoders
- Detección de fraudes en transacciones. Monitoreo de sistemas para identificar fallos. Detección de cambios climáticos extremos
- algoritmos
- Objetivo
- dentifica puntos de datos que son significativamente diferentes del resto.
- Minería de reglas de asociación:
- busca encontrar relaciones significativas entre variables en grandes conjuntos de datos.
- Objetivo
- Descubrir patrones, como qué productos suelen comprarse juntos en un supermercado.
- algoritmos
- Apriori
- FP-Growth
- algoritmos
- Recomendaciones de productos (ejemplo: "quienes compraron X también compraron Y"). Análisis de datos médicos para encontrar relaciones entre síntomas y enfermedades.
- Descubrir patrones, como qué productos suelen comprarse juntos en un supermercado.
- Objetivo
- busca encontrar relaciones significativas entre variables en grandes conjuntos de datos.
- Predicción
- utiliza modelos matemáticos y estadísticas para estimar valores futuros basándose en datos históricos
- Objetivo
- Predecir una variable objetivo (dependiente) basándose en una o más variables explicativas (independientes).
- Regresión lineal/múltiple.
- Redes neuronales.
- Árboles de decisión y bosques aleatorios.
- Pronósticos financieros. Predicción del comportamiento del cliente. Diagnóstico médico.
- Predecir una variable objetivo (dependiente) basándose en una o más variables explicativas (independientes).
- Objetivo
- utiliza modelos matemáticos y estadísticas para estimar valores futuros basándose en datos históricos
- Agrupamiento (Clustering)
Implicancias de la ciencia de datos:personalizacion y discriminazion
- la personalización puede dar como resultado un trato preferencial para algunos y la marginación de otros .
- Al menos que se use con mucho cuidado, la ciencia de datos puede perpetuar y reforzar los perjuicios .
- la personalización puede dar como resultado un trato preferencial para algunos y la marginación de otros .
Imagens e arquivos do mapa
Informações
- Descrição
- Mapa Mental sobre ciencia de datos, criado por Erik Emilio Miranda Santos em 27-11-2024.
- Criado por
- Erik Emilio Miranda Santos
- Visualizações
- 0
- Avaliação