
Description


|
Created by LARA ECHARRI
over 9 years ago
|
|
Page 1
0.-Índice(este es el tema de estadística inferencial)
TIP MEMORIA: los 3 primeros puntos , lo s mismos que el tema 1. 1.- Definición de estadística. Descriptiva Inferencial 2.-Términos básicos Individuo Muestra Población Estadístico 3.-Variable y tipos de variables Tipos de variable Definición de variables Tipos de variable. Ejemplos Corrección de Yates (convertir en intervalos) quizás en los ensayos clínicos variables surrogadas, intermedias y finales y algunos ejemplos. 4.ESTADÍSTICA INFERENCIAS IC azar nivel de confianza parámetros de los que depende el tamaño muestral. alfa, potencia del test, magnitud de la diferencia que se desea detectar. Pruebas de conformidad verifican una hipótesis sobre un determinado valor del parámetro. Se puede calcular: comparación de una proporción comparación de una media. 5.-Significación estadística y pruebas de hipótesis Qué son las pruebas de hipótesis Mutuamente excluyentes significado de p (se interpreta como un indicador de la credibilidad de H0.) diferencia con IC (proprociona información sobre la magnitud del efecto). cuanto más estrecho es el IC, mayor información tenemos sobre la magnitud del efecto si el IC incluye el 0, acepta H0. el efecto no es significativo/la información IC es diferente a la desviación estándar. ) valor decisorio: resta (cero) cociente (uno) nivel de confianza. Tipos de errores. Error tipo I y su complementario Error de tipo II y su complementario Potencia características de las que depende la potencia tamaño muestral. Fórmula 6.-Tipos de distribución 7.-Tipos de pruebas de hipótesis Concepto previo: verificación de hipótesis de normalidad Paramétricas studen anova y luego para diferenciar los grupos: FSnedecor, Barlet/Levene)/datos apareados. No paramétricas (TIP DE MEMORIA, LAS PRUEBAS CON 3 LETRAS (Q/U/H Y LA W DE WILCOXSON, que es la rara).Las pruebas paramétricas son muy frías. Friedman.) 8.- Regresión y correlación Regresión Correlación Características del coeficiente de correlación Tipos de coeficiente de correlación Coeficiente de determinación
Page 2
1.-2.-3.-Como el Tema 1
TIP MEMORIA: los 3 primeros puntos , lo s mismos que el tema 1. 1.- Definición de estadística. Descriptiva Inferencial 2.-Términos básicos Individuo Muestra Población Estadístico 3.-Variable y tipos de variables Tipos de variable Definición de variables Tipos de variable. Ejemplos Corrección de Yates (convertir en intervalos) quizás en los ensayos clínicos variables surrogadas, intermedias y finales y algunos ejemplos.
Page 3
4.-Estadística inferencial
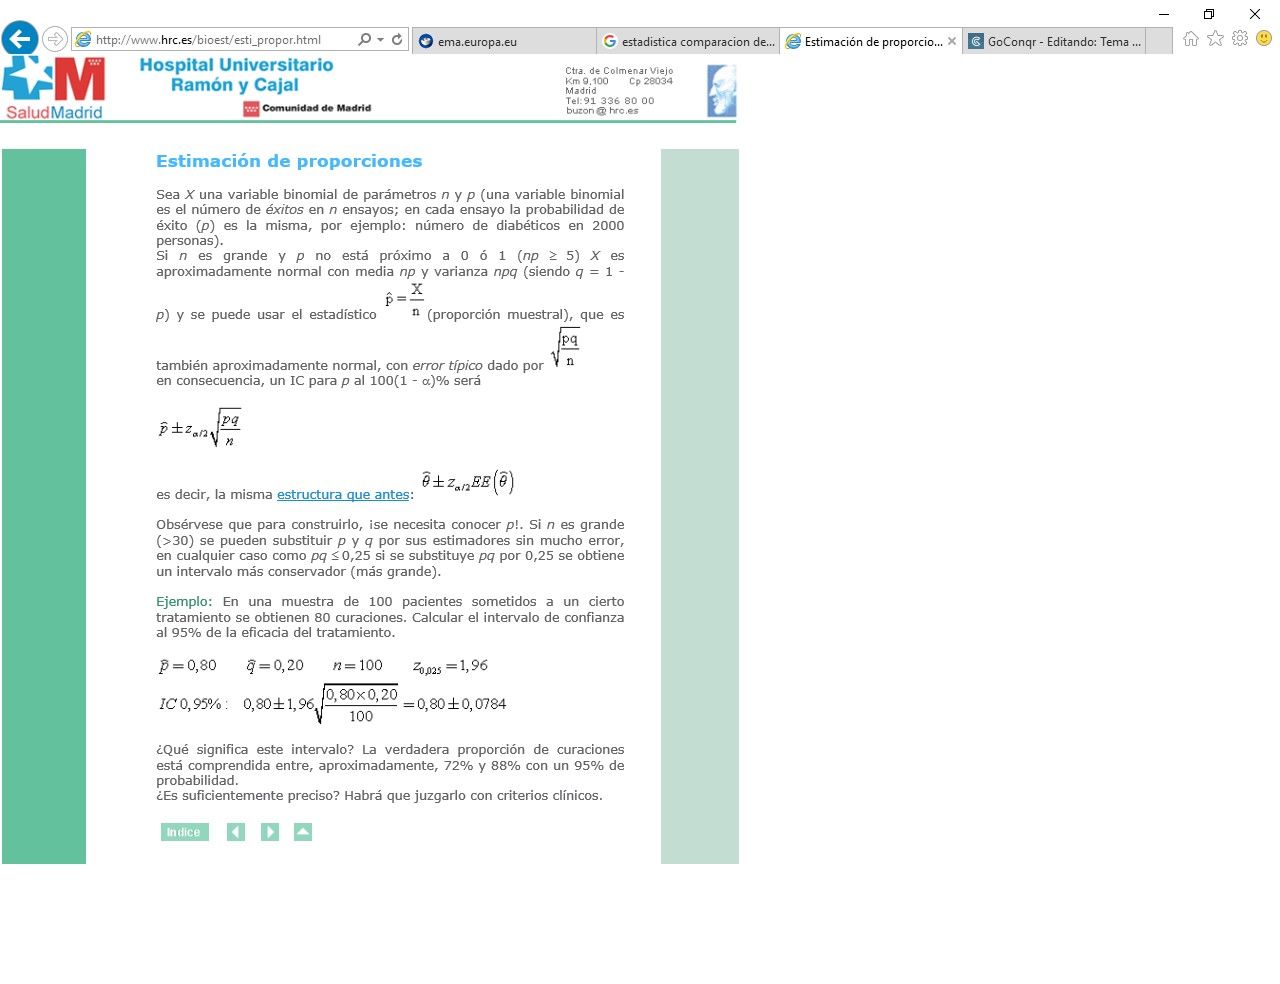
IC azar nivel de confianza parámetros de los que depende el tamaño muestral. alfa, potencia del test, magnitud de la diferencia que se desea detectar. Pruebas de conformidad. Estimación de una media y un porcentaje verifican una hipótesis sobre un determinado valor del parámetro. Se puede calcular: comparación de una proporción comparación de una media.
El termino población se utiliza para referirse a un conjunto total de sujetos, seres vivos, objetos inanimados, observaciones o unidades de cualquier tipo con una característica en común. Para estudiar sus características habitualmente se recurre a una muestra o subconjunto de la población, seleccionada de modo que sea representativa de ella, y en la que se realizarán las mediciones. - las cantidades que permiten caracterizar la distribución de una variable en una población, como su media o su varianza, se denominan parámetros (μ, σ). Las cantidades que se calculan a partir de las observaciones realizadas en muestras se denominan estadísticos (x, s). La finalidad de la estadística inferencial es estimar el parámetro de la población a partir del estadístico obtenido en una muestra. - La estimación confidencial o de intervalo consiste en determinar un posible rango de valores o intervalo, en los que pueda precisarse -con una determinada probabilidad- que el valor de un parámetro se encuentra dentro de esos límites. A éste se le denomina intervalo de confianza. El intervalo de confianza es una expresión del tipo [θ1, θ2] ó θ1 ≤ θ ≤θ2, donde θ es el parámetro a estimar. Este intervalo contiene al parámetro estimado con una determinada certeza o nivel de confianza. - El nivel de confianza es la probabilidad de que el verdadero valor del parámetro estimado en la población se sitúe en el intervalo de confianza obtenido. El nivel de confianza se denota por (1-α), aunque habitualmente suele expresarse con un porcentaje ((1-α)·100%). Es habitual tomar como nivel de confianza un 95% o un 99%, que se corresponden con valores α de 0,05 y 0,01, respectivamente.
Estimación de una media y estimación de un porcentaje
Estimación de parámetros En general, de las variables experimentales u observacionales no conocemos la fpd. Podemos conocer la familia (normal, binomial,...) pero no los parámetros. Para calcularlos necesitaríamos tener todos los posibles valores de la variable, lo que no suele ser posible. La inferencia estadística trata de cómo obtener información (inferir) sobre los parámetros a partir de subconjuntos de valores (muestras) de la variable. Estadístico: variable aleatoria que sólo depende de la muestra aleatoria elegida para calcularla.Estimación: Proceso por el que se trata de averiguar un parámetro de la población representado, en general, por q a partir del valor de un estadístico llamado estimador y representado por El problema se resuelve en base al conocimiento de la "distribución muestral" del estadístico que se use. ¿Qué es esto? Concretemos, p.e. en la media (m). Si para cada muestra posible calculamos la media muestral () obtenemos un valor distinto ( es un estadístico: es una variable aleatoria y sólo depende de la muestra), habrá por tanto una fpd para , llamada distribución muestral de medias. La desviación típica de esta distribución se denomina error típico de la media. Evidentemente, habrá una distribución muestral para cada estadístico, no sólo para la media, y en consecuencia un error típico para cada estadístico. Si la distribución muestral de un estadístico estuviera relacionada con algún parámetro de interés, ese estadístico podría ser un estimador del parámetro.
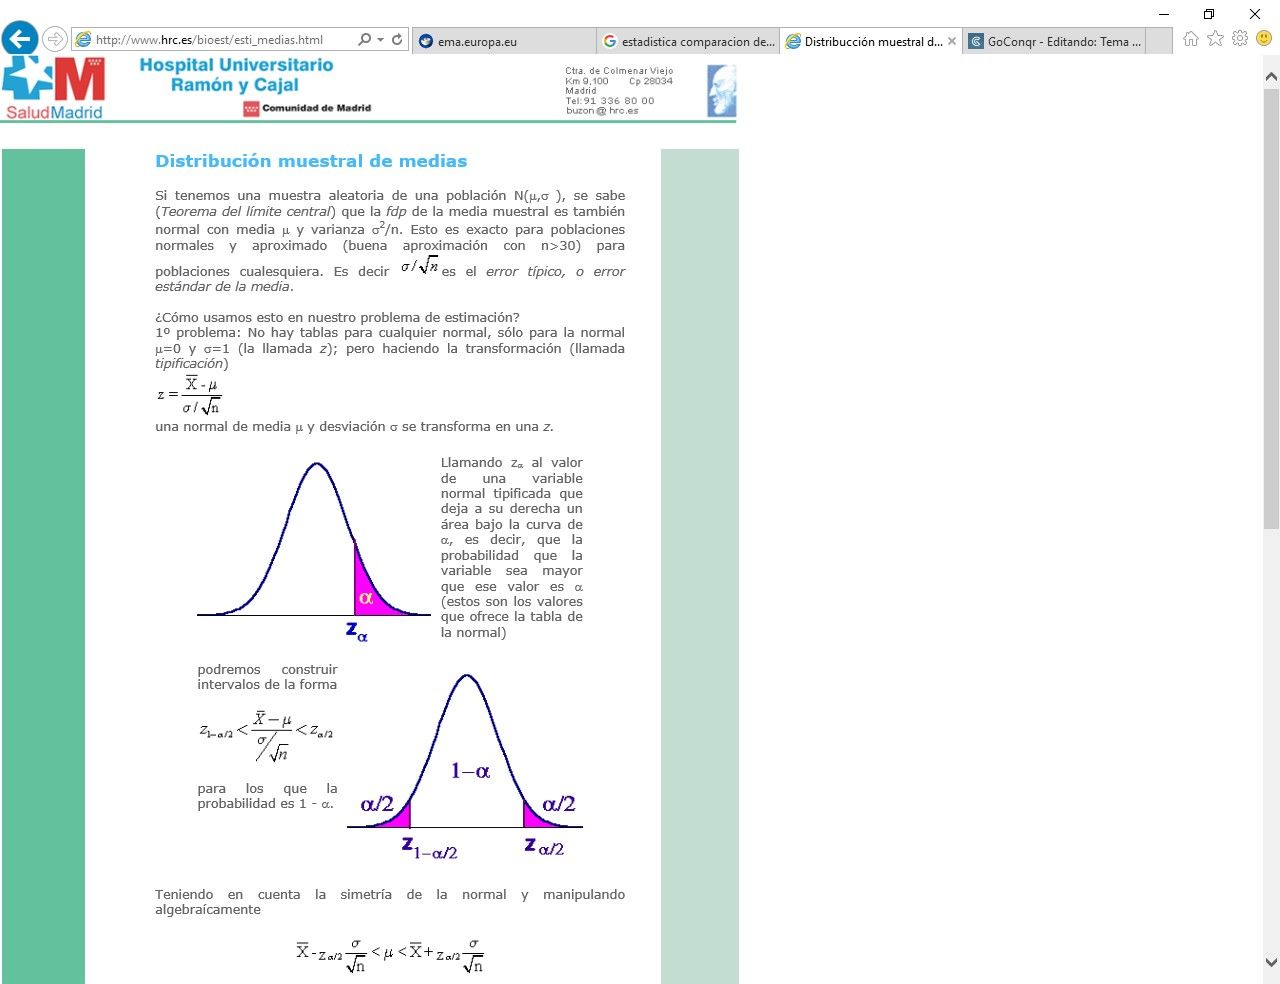
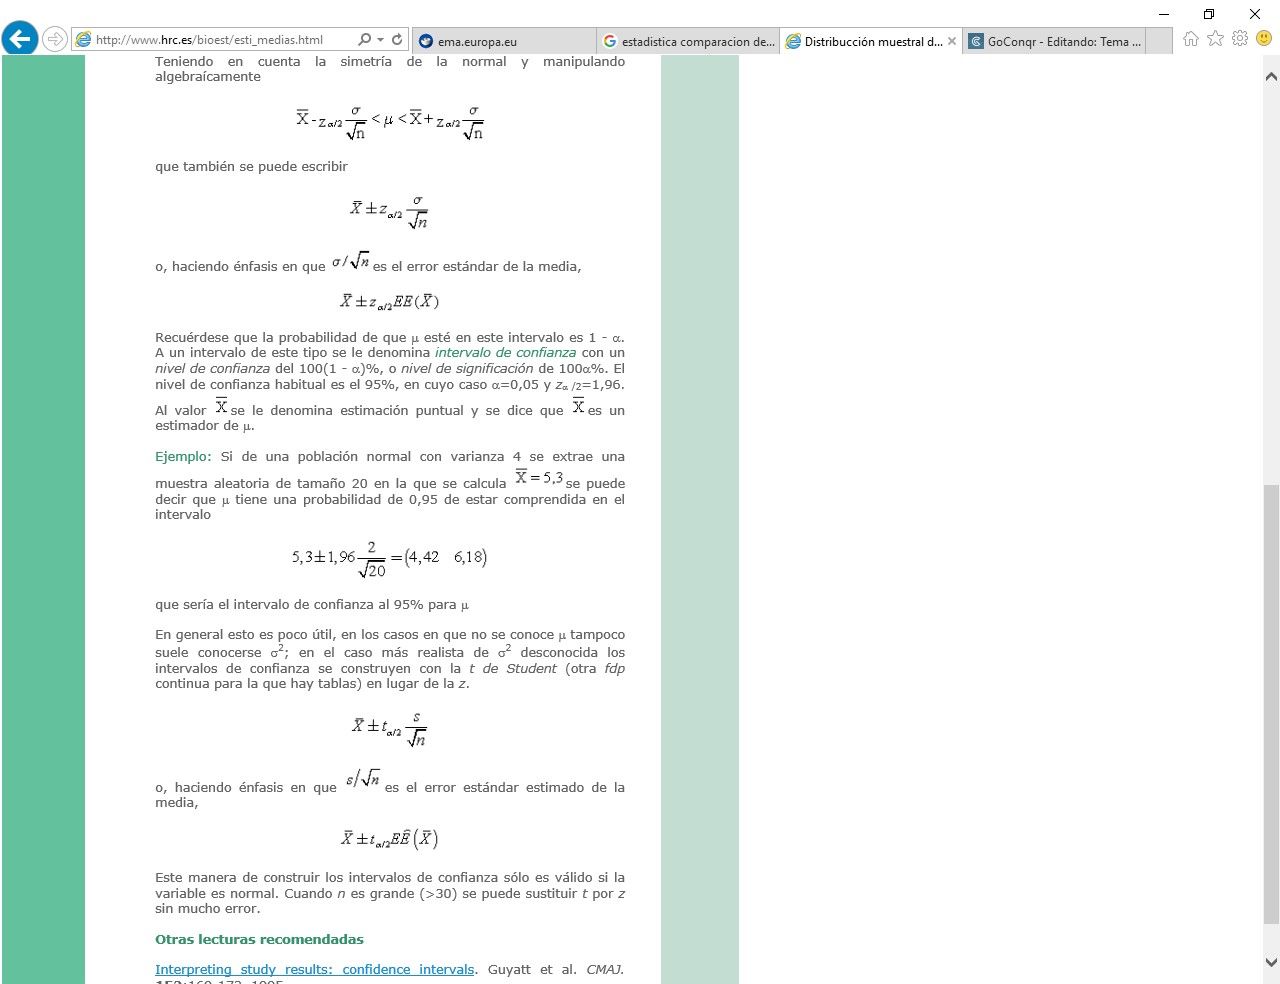
Distribución muestral de medias Si tenemos una muestra aleatoria de una población N(m,s ), se sabe (Teorema del límite central) que la fdp de la media muestral es también normal con media m y varianza s2/n. Esto es exacto para poblaciones normales y aproximado (buena aproximación con n>30) para poblaciones cualesquiera. Es decir es el error típico, o error estándar de la media. ¿Cómo usamos esto en nuestro problema de estimación? 1º problema: No hay tablas para cualquier normal, sólo para la normal m=0 y s=1 (la llamada z); pero haciendo la transformación (llamada tipificación). una normal de media m y desviación s se transforma en una z. Llamando za al valor de una variable normal tipificada que deja a su derecha un área bajo la curva de a, es decir, que la probabilidad que la variable sea mayor que ese valor es a (estos son los valores que ofrece la tabla de la normal). Recuérdese que la probabilidad de que m esté en este intervalo es 1 - a. A un intervalo de este tipo se le denomina intervalo de confianza con un nivel de confianza del 100(1 - a)%, o nivel de significación de 100a%. El nivel de confianza habitual es el 95%, en cuyo caso a=0,05 y za /2=1,96. Al valor se le denomina estimación puntual y se dice que es un estimador de m. Ejemplo: Si de una población normal con varianza 4 se extrae una muestra aleatoria de tamaño 20 en la que se calcula se puede decir que m tiene una probabilidad de 0,95 de estar comprendida en el intervalo que sería el intervalo de confianza al 95% para m En general esto es poco útil, en los casos en que no se conoce m tampoco suele conocerse s2; en el caso más realista de s2 desconocida los intervalos de confianza se construyen con la t de Student (otra fdp continua para la que hay tablas) en lugar de la z. o, haciendo énfasis en que es el error estándar estimado de la media, Este manera de construir los intervalos de confianza sólo es válido si la variable es normal. Cuando n es grande (>30) se puede sustituir t por z sin mucho error.
Page 4
5.-Significación estadística y pruebas de hipótesis
Qué son las pruebas de hipótesis Mutuamente excluyentes significado de p (se interpreta como un indicador de la credibilidad de H0.) diferencia con IC (proprociona información sobre la magnitud del efecto). cuanto más estrecho es el IC, mayor información tenemos sobre la magnitud del efecto si el IC incluye el 0, acepta H0. el efecto no es significativo/la información IC es diferente a la desviación estándar. ) valor decisorio: resta (cero) cociente (uno) nivel de confianza. Tipos de errores. Error tipo I y su complementario Error de tipo II y su complementario Potencia
- Se consideran dos hipótesis: - Hipótesis nula (H0): No existen diferencias (entre los dos tratamientos, A=B). Las diferencias se deben al azar. Se acepta provisionalmente y es sometida a comprobación empírica. - Hipótesis alternativa (H1): Sí que existen diferencias (entre los dos tratamientos, A≠B). Se acepta cuando se rechaza la hipótesis nula. - Estas dos hipótesis son mutuamente excluyentes, de forma que solamente hay dos posibles decisiones: - Rechazar H0 → aceptar H1. - Aceptar H0 → rechazar H1. - Previamente se fija la probabilidad máxima de que las diferencias observadas entre los dos grupos puedan ser debidas simplemente al azar (H0 cierta), que suele ser por convenio del 5%. Una vez que se analizan los datos (a posteriori), se calcula el “grado de significación estadística” (“p”) o nivel de significación “p”. El valor “p” de un test de hipótesis se define como la probabilidad de obtener diferencias mayores o iguales a las observadas en la muestra si la hipótesis nula (H0) fuese cierta. Así: - p < 0,05 → diferencias reales, baja probabilidad de que se deban al azar. Se rechaza H0 y se acepta H1. Se habla de “diferencias estadísticamente significativas”. - p > 0,05 → las diferencias entran dentro de las debidas al azar. Se acepta H0 y se rechaza H1.
Tipos de errores
- Error de tipo I: rechazar Ho siendo cierta (afirmar que hay diferencias significativas cuando realmente no las hay); es como un falso positivo. Se denomina riesgo α a la probabilidad de cometer un error tipo I. - se define Nivel de confianza como lo complementario de α; es decir (1-α). - el valor para el riesgo α suele establecerse en el 5%, y por lo tanto el nivel de confianza es del 95%. - Error de tipo II: aceptar Ho siendo falsa (negar que existen diferencias significativas cuando realmente las hay); es como un falso negativo. Se denomina riesgo β a la probabilidad de cometer un error tipo II. - se define Poder o potencia de un Test como lo complementario del error β, es decir (1-β). Es la capacidad que tiene un test para detectar una diferencia cuando ésta existe en realidad, es decir, corresponde a la probabilidad que tengo de demostrar la hipótesis alternativa siendo cierta. - el valor para el riesgo β suele establecerse en el 20% o, lo que es igual, un poder estadístico del 80% (1-0,20). Así, si el estudio tiene un poder del 80% significa que 8 de cada 10 veces se podrá detectar un efecto, si es que éste existe en realidad, y que 2 de cada 10 veces se asume un riesgo β de que no pueda llegarse a detectar un efecto real. - la potencia de la prueba depende de tres factores: - tamaño del efecto: grado con que un fenómeno o variable se manifiesta en la población. - tamaño de la muestra: a medida que trabajamos con un tamaño muestral más grande, la potencia de la prueba aumenta. - tamaño del error tipo I: si α es grande, la potencia de la prueba aumenta (pero también aumenta la cuantía del error tipo I), porque β se hace más pequeño. recordar si alfa aumenta beta disminuye.
Page 5
6.-Tipos de distribución
Page 6
7.-Tipos de pruebas de hipótesis
a.-Verificación de la hipótesis de normalidad
Verificación de la hipótesis de normalidad 1.- Exploración visual de los datos tras su representación gráfica (ej: histograma). 2.- Valorar la simetría de la distribución, comparando los valores de media, mediana y moda. 3.- Coeficientes: - coeficiente de asimetría (skewness) de Fisher (γ =0, distribución simétrica). - coeficiente de apuntamiento (kurtosis) de Fisher. 4.- Gráficos de probabilidad normal: - gráficos P-P (de proporciones acumuladas). - gráficos Q-Q (de cuantiles). 5.- Test: (NO PARAMÉTRICOS) - test de Kolgomorov-Smirnov. - test de Shapiro-Wilks.
b.-Paramétricas
- se aplican a variables cuantitativas que siguen una distribución normal, y tienen varianzas homogéneas (= homocedasticidad). - son más potentes que las pruebas no paramétricas. - son: 1.1.- Prueba t de Student: se aplica para analizar una variable cuantitativa con distribución normal en 2 grupos. 1.2.- Prueba del análisis de la varianza (ANOVA): se aplica para analizar una variable cuantitativa con distribución normal en más de 2 grupos. - Si al concluir el ANOVA se detectan diferencias significativas y se desea averiguar entre qué grupos las hay, se emplean test de comparación múltiple (a posteriori o post-hoc) como: test de Scheffé, test de Tukey, test de Bonferroni. *Para la comparación de las varianzas se aplica la prueba F de Snedecor o test de la razón de varianzas. También se usan: test de Barlett, test de Levene.
c.-No paramétricas
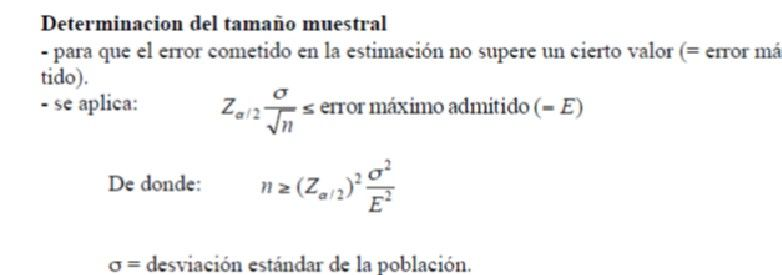
- ventajas: - no dependen de la distribución de la variable; no exigen la condición de normalidad. - permiten operar con escalas de medida ordinal y nominal (cualitativas). - son aptas para muestras muy pequeñas. - los cálculos son más sencillos. - desventajas: son menos potentes que las pruebas paramétricas, por lo que solamente demostrarán como significativas diferencias mayores. Para alcanzar la misma potencia podrá procederse a aumentar el tamaño muestral. - son: Prueba de independencia de Chi-cuadrado, test “U” de Mann-Whitney, test “T” de Wilcoxon, test de Kruskal- Wallis. - en la investigación sanitaria nos encontramos con frecuencia variables de tipo cualitativo, mediante las cuales un grupo de individuos se clasifican en dos o más categorías mutuamente excluyentes. Cuando lo que se pretende es comparar dos o más grupos de sujetos con respecto a una variable cualitativa, el número de casos observados o frecuencia en cada categoría de la variable se presentan a modo de tablas de doble entrada que reciben el nombre de tablas de contingencia y se calcula el estadístico χ2. La situación más simple es la comparación entre dos variables cualitativas en las que ambas son dicotómicas, es decir, solamente pueden tomar dos valores → tabla de 2x2. Cuando el tamaño muestral es reducido se recomienda aplicar la corrección de Yates. (n<200). Si el valor obsevado en el 80% d elas celdas es menor de 5, se recomienda aplicar la prueba exacta de Fischer. Hablamos de datos apareados en el caso de que dos medidas se hayan obtenido en la misma muestra. En general, se compara a cada individuo consigo mismo, es decir, se evalúa un mismo dato más de una vez en cada sujeto de la muestra (típicamente son estudios antes/después; ej: fiebre en un paciente a las 2 h y fiebre en el mismo paciente a las 10 h). 2.- Prueba de McNemar. TIP DE MEMORIA, LAS PRUEBAS CON 3 LETRAS (Q/U/H Y LA W DE WILCOXSON, que es la rara).Las pruebas paramétricas son muy frías. Friedman. 3.- Prueba Q de Cochran. 4.- Prueba U de Mann-Whitney. 5.- Prueba H de Kruskal-Wallis. 6.- Pruebas de los signos y de los rangos con signo de Wilcoxon. 7.- Prueba de Friedman. Nota: hablamos de datos apareados (o dependientes o relacionados) en el caso de que dos medidas se hayan obtenido en la misma muestra. En general, se compara a cada individuo consigo mismo, es decir, se evalúa un mismo dato más de una vez en cada sujeto de la muestra (típicamente son estudios antes/después; ej: fiebre en un paciente a las 2 horas y fiebre en el mismo paciente a las 10 h). Nota: los test de Kolgomorov-Smirnov y de Shapiro-Wilks también son pruebas no paramétricas. Nota: para estudiar la aleatoriedad de una muestra se utiliza el test de rachas de Wald-Wolfowitz. En general, se prefiere utilizar pruebas paramétricas, y el uso de las pruebas no paramétricas se limita a estudios con tamaños muestrales menores de 30, cuando las poblaciones no puedan ser consideradas como normales, o bien, cuando la variable represente solamente una medida aproximada o esté medida en escala ordinal o nominal. Determinación del Tamaño Muestral - el tamaño de la muestra indica el número aproximado de sujetos que se necesitan para detectar una diferencia determinada, con unos márgenes de error previamente definidos. Queda determinado por: - el riesgo α que se está dispuesto a asumir; - la potencia estadística del test (1-β); - la magnitud de la diferencia que se desea detectar; y - el tipo de comparación: unilateral (= una cola) o bilateral (= dos colas).
Page 7
8.-Análisis de regresión y correlación
En la práctica clínica nos encontramos con situaciones en las que se requiere analizar la relación entre dos variables cuantitativas. Dos objetivos: - determinar si dichas variables están asociadas y en qué sentido se da dicha asociación (es decir, si los valores de una variable tienden a aumentar –o a disminuir- al aumentar los valores de la otra) → se recurre al coeficiente de correlación. - caracterizar la relación entre ambas variables y utilizar una para predecir el valor de la otra → se recurre a la técnica de regresión lineal. Análisis de regresión - En este análisis disponemos de dos variables de interés, x e y. La variable x se llama variable independiente (= explicativa = predictiva) y es controlada por el investigador; la variable y se llama dependiente (= resultado). - se obtiene una ecuación del tipo: y = a + bx Los coeficientes a y b son los coeficientes de regresión en la población. El coeficiente a representa la ordenada en el origen, es decir, el punto en el que la recta corta el eje vertical o de ordenadas (valor de y para x = 0). El coeficiente b es la pendiente de la recta, que representa la cantidad que cambia y por una unidad de cambio de x. Análisis de correlación - El coeficiente de correlación de Pearson mide la intensidad de la relación lineal entre las dos variables cuantitativas. Cuando las variables continuas no siguen un modelo de distribución normal o se trata de variables medidas en escala ordinal, se utiliza el coeficiente de correlación de Spearman. - Las características del coeficiente de correlación son las siguientes: → -1 ≤ r ≤ +1 → para r = ± 1, hay una relación lineal perfecta entre x e y, es decir, todos los puntos (x,y) están en una línea recta. → un valor positivo de r indica que a medida que aumenta una variable, lo hace la otra, o que a medida que disminuye una también lo hace la otra (directamente relacionadas, relación creciente). -Un coeficiente de correlación negativo indica que a medida que disminuye una variable aumenta la otra o viceversa (inversamente relacionadas, relación decreciente). → r = 0 indica que no hay relación lineal entre las dos variables. - el valor r es independiente de cualquier unidad usada para medir las variables. - la correlación no implica necesariamente causalidad. el cuadrado del coeficiente de correlación de Pearson (r2) se denomina coeficiente de determinación. representa el porcentaje de variación de la variable Y que es explicado por la variable X.
Want to create your own Notes for free with GoConqr? Learn more.