
Mind map
8 - Big Dados
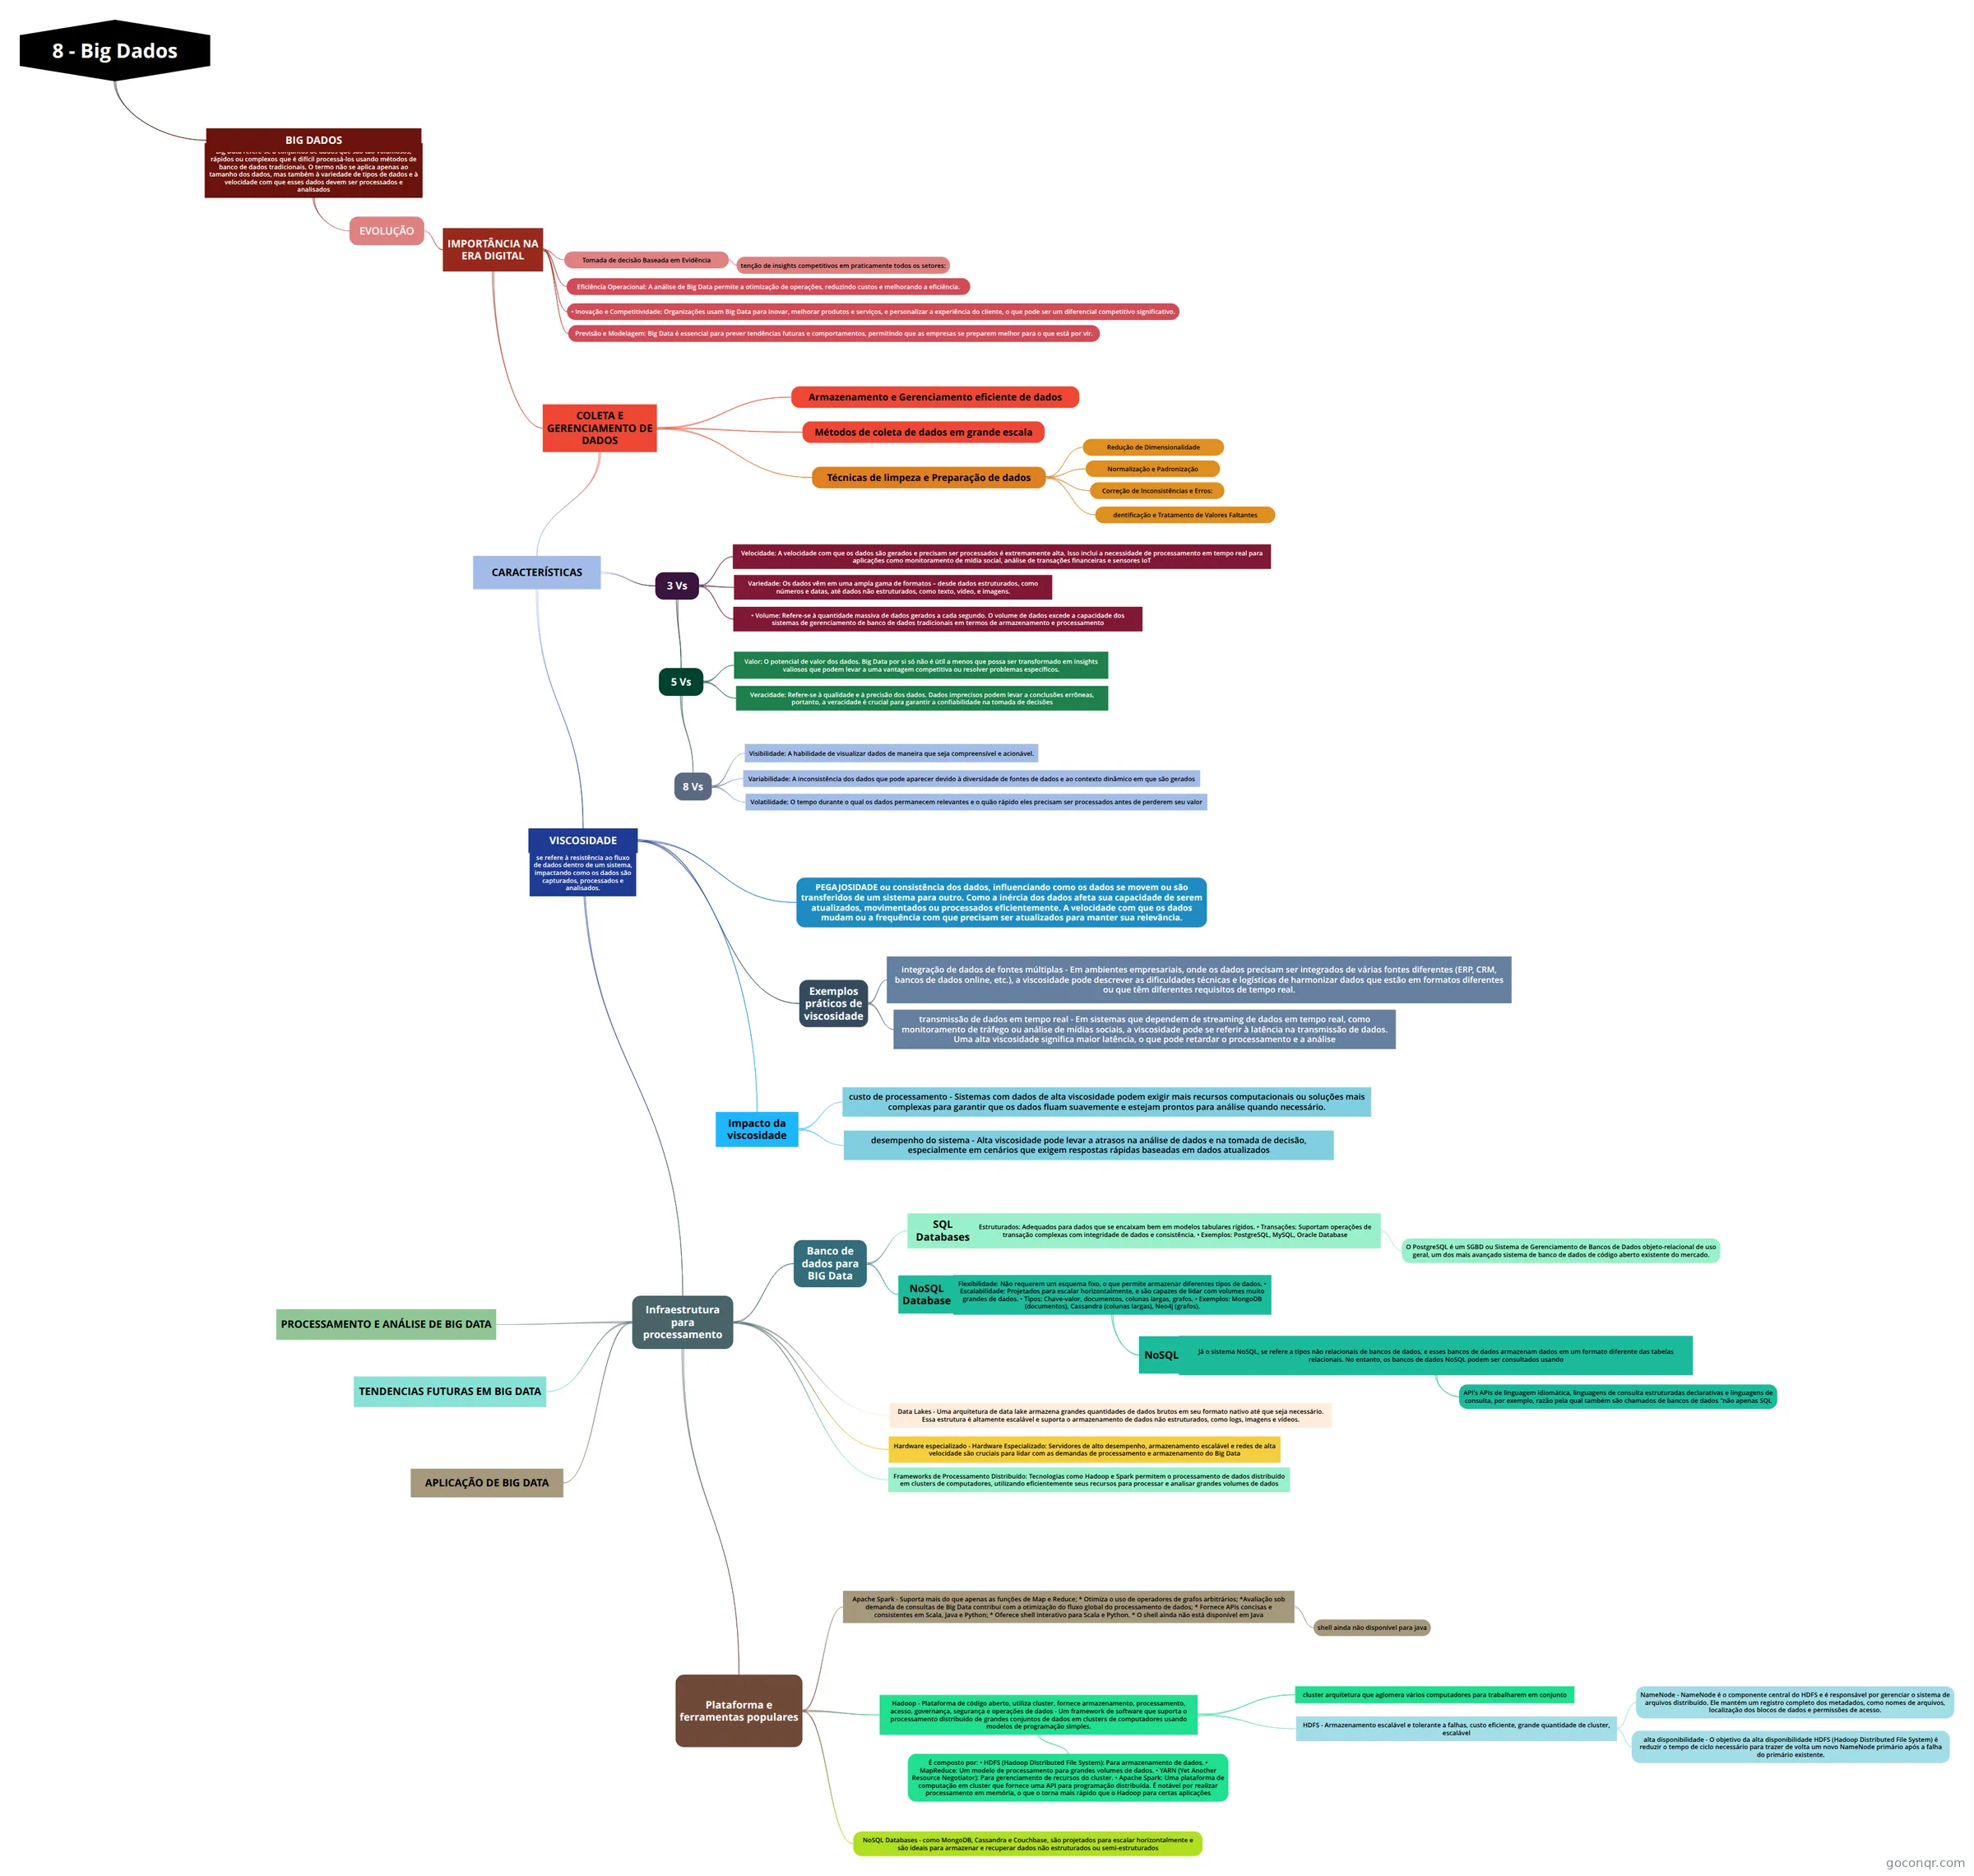
Mapa mental: Big dados
Map content
8 - Big Dados
BIG DADOS
- Big Data refere-se a conjuntos de dados que são tão volumosos, rápidos ou complexos que é difícil processá-los usando métodos de banco de dados tradicionais. O termo não se aplica apenas ao tamanho dos dados, mas também à variedade de tipos de dados e à velocidade com que esses dados devem ser processados e analisados
- Big Data refere-se a conjuntos de dados que são tão volumosos, rápidos ou complexos que é difícil processá-los usando métodos de banco de dados tradicionais. O termo não se aplica apenas ao tamanho dos dados, mas também à variedade de tipos de dados e à velocidade com que esses dados devem ser processados e analisados
- EVOLUÇÃO
- A história do Big Data pode ser vista como uma evolução dos métodos de armazenamento e análise de informações:
- • Década de 1960 e 1970: Os conceitos iniciais de grandes bases de dados emergiram com a necessidade de armazenar informações governamentais e de pesquisa.
- • Década de 1980 e 1990: A popularização dos computadores pessoais e a expansão da internet aumentaram exponencialmente a geração de dados.
- • Anos 2000: O termo “Big Data” começa a ser usado para descrever a explosão de dados digitais e a necessidade de novas ferramentas para lidar com essa vasta quantidade de informações
- • Última década: Desenvolvimento de tecnologias como Hadoop e soluções de armazenamento em nuvem que permitem às empresas e organizações gerenciar e analisar grandes volumes de dados de forma mais eficiente.
- IMPORTÂNCIA NA ERA DIGITAL
- O Big Data tornou-se um recurso crucial para a tomada de decisões e a obtenção de insights competitivos em praticamente todos os setores: •. •
- • Inovação e Competitividade: Organizações usam Big Data para inovar, melhorar produtos e serviços, e personalizar a experiência do cliente, o que pode ser um diferencial competitivo significativo.
- • Inovação e Competitividade: Organizações usam Big Data para inovar, melhorar produtos e serviços, e personalizar a experiência do cliente, o que pode ser um diferencial competitivo significativo.
- Eficiência Operacional: A análise de Big Data permite a otimização de operações, reduzindo custos e melhorando a eficiência.
- • Eficiência Operacional: A análise de Big Data permite a otimização de operações, reduzindo custos e melhorando a eficiência.
- Tomada de decisão Baseada em Evidência
- Tomada de Decisão Baseada em Evidências: Com o Big Data, as decisões podem ser mais informadas e baseadas em análises profundas de tendências de mercado e comportamentos de consumidores
- tenção de insights competitivos em praticamente todos os setores:
- Previsão e Modelagem: Big Data é essencial para prever tendências futuras e comportamentos, permitindo que as empresas se preparem melhor para o que está por vir.
- Previsão e Modelagem: Big Data é essencial para prever tendências futuras e comportamentos, permitindo que as empresas se preparem melhor para o que está por vir.
- COLETA E GERENCIAMENTO DE DADOS
- No contexto do Big Data, a coleta, limpeza, preparação e armazenamento de dados são etapas cruciais que determinam a qualidade e a utilidade das análises realizadas. Este módulo aborda métodos eficazes para coletar dados em grande escala, técnicas para limpar e preparar esses dados para análise, e estratégias para armazenar e gerenciar esses dados de forma eficiente
- CARACTERÍSTICAS
- • Volume: A quantidade de dados gerados por empresas, dispositivos, sensores e mais. • Velocidade: A rapidez com que os dados são produzidos e precisam ser processados. • Variedade: Os diferentes tipos de dados, desde dados estruturados até dados não estruturados como e-mails, vídeos e fotos. • Veracidade: Refere-se à qualidade e à precisão dos dados. Dados imprecisos podem levar a conclusões errôneas, portanto, a veracidade é crucial para garantir a confiabilidade na tomada de decisões. • Valor: O potencial de valor dos dados. Big Data por si só não é útil a menos que possa ser transformado em insights valiosos que podem levar a uma vantagem competitiva ou resolver problemas específicos. Com a evolução do campo, outros Vs foram adicionados para refletir mais desafios e características do Big Data:• Visibilidade: A habilidade de visualizar dados de maneira que seja compreensível e acionável.• Variabilidade: A inconsistência dos dados que pode aparecer devido à diversidade de fontes de dados e ao contexto dinâmico em que são gerados.• Volatilidade: O tempo durante o qual os dados permanecem relevantes e o quão rápido eles precisam ser processados antes de perderem seu valor.• Os 3 Vs que levaram à criação da tecnologia para lidar com aquilo que os SGBDs tradicionais não davam conta
- VISCOSIDADE
- se refere à resistência ao fluxo de dados dentro de um sistema, impactando como os dados são capturados, processados e analisados.
- Embora “viscosidade” não seja um dos “Vs” mais frequentemente citados ao lado de Volume, Velocidade, Variedade, Veracidade e Valor, ele oferece uma perspectiva valiosa sobre as características físicas e técnicas do gerenciamento de dados. Este conceito ajuda a destacar os desafios práticos enfrentados ao lidar com grandes volumes de dados em ambientes dinâmicos e multifacetados.
- PEGAJOSIDADE ou consistência dos dados, influenciando como os dados se movem ou são transferidos de um sistema para outro. Como a inércia dos dados afeta sua capacidade de serem atualizados, movimentados ou processados eficientemente. A velocidade com que os dados mudam ou a frequência com que precisam ser atualizados para manter sua relevância.
- Impacto da viscosidade
- desempenho do sistema - Alta viscosidade pode levar a atrasos na análise de dados e na tomada de decisão, especialmente em cenários que exigem respostas rápidas baseadas em dados atualizados
- custo de processamento - Sistemas com dados de alta viscosidade podem exigir mais recursos computacionais ou soluções mais complexas para garantir que os dados fluam suavemente e estejam prontos para análise quando necessário.
- Exemplos práticos de viscosidade
- transmissão de dados em tempo real - Em sistemas que dependem de streaming de dados em tempo real, como monitoramento de tráfego ou análise de mídias sociais, a viscosidade pode se referir à latência na transmissão de dados. Uma alta viscosidade significa maior latência, o que pode retardar o processamento e a análise
- integração de dados de fontes múltiplas - Em ambientes empresariais, onde os dados precisam ser integrados de várias fontes diferentes (ERP, CRM, bancos de dados online, etc.), a viscosidade pode descrever as dificuldades técnicas e logísticas de harmonizar dados que estão em formatos diferentes ou que têm diferentes requisitos de tempo real.
- Infraestrutura para processamento
- Hardware especializado - Hardware Especializado: Servidores de alto desempenho, armazenamento escalável e redes de alta velocidade são cruciais para lidar com as demandas de processamento e armazenamento do Big Data
- Frameworks de Processamento Distribuído: Tecnologias como Hadoop e Spark permitem o processamento de dados distribuído em clusters de computadores, utilizando eficientemente seus recursos para processar e analisar grandes volumes de dados
- Data Lakes - Uma arquitetura de data lake armazena grandes quantidades de dados brutos em seu formato nativo até que seja necessário. Essa estrutura é altamente escalável e suporta o armazenamento de dados não estruturados, como logs, imagens e vídeos.
- Plataforma e ferramentas populares
- Diversas plataformas e ferramentas foram desenvolvidas para auxiliar na manipulação e análise de Big Data:
- Hadoop - Plataforma de código aberto, utiliza cluster, fornece armazenamento, processamento, acesso, governança, segurança e operações de dados - Um framework de software que suporta o processamento distribuído de grandes conjuntos de dados em clusters de computadores usando modelos de programação simples.
- cluster arquitetura que aglomera vários computadores para trabalharem em conjunto
- HDFS - Armazenamento escalável e tolerante a falhas, custo eficiente, grande quantidade de cluster, escalável
- O Hadoop Distributed File System (HDFS) fornece armazenamento escalável e tolerante a falhas, o custo-eficiente para o seu lago de dados grande. Ele foi projetado para abranger grandes clusters de servidores de commodities escalar até centenas de petabytes e milhares de servidores. Ao distribuir o armazenamento através de muitos servidores, o recurso de armazenamento combinado pode crescer linearmente com a demanda permanecendo econômica em cada quantidade de armazenamento.
- NameNode - NameNode é o componente central do HDFS e é responsável por gerenciar o sistema de arquivos distribuído. Ele mantém um registro completo dos metadados, como nomes de arquivos, localização dos blocos de dados e permissões de acesso.
- alta disponibilidade - O objetivo da alta disponibilidade HDFS (Hadoop Distributed File System) é reduzir o tempo de ciclo necessário para trazer de volta um novo NameNode primário após a falha do primário existente.
- É composto por: • HDFS (Hadoop Distributed File System): Para armazenamento de dados. • MapReduce: Um modelo de processamento para grandes volumes de dados. • YARN (Yet Another Resource Negotiator): Para gerenciamento de recursos do cluster. • Apache Spark: Uma plataforma de computação em cluster que fornece uma API para programação distribuída. É notável por realizar processamento em memória, o que o torna mais rápido que o Hadoop para certas aplicações
- NoSQL Databases - como MongoDB, Cassandra e Couchbase, são projetados para escalar horizontalmente e são ideais para armazenar e recuperar dados não estruturados ou semi-estruturados
- Apache Spark - Suporta mais do que apenas as funções de Map e Reduce; * Otimiza o uso de operadores de grafos arbitrários; *Avaliação sob demanda de consultas de Big Data contribui com a otimização do fluxo global do processamento de dados; * Fornece APIs concisas e consistentes em Scala, Java e Python; * Oferece shell interativo para Scala e Python. * O shell ainda não está disponível em Java
- shell ainda não disponível para java
- Banco de dados para BIG Data
- NoSQL Database
- Flexibilidade: Não requerem um esquema fixo, o que permite armazenar diferentes tipos de dados. • Escalabilidade: Projetados para escalar horizontalmente, e são capazes de lidar com volumes muito grandes de dados. • Tipos: Chave-valor, documentos, colunas largas, grafos. • Exemplos: MongoDB (documentos), Cassandra (colunas largas), Neo4j (grafos).
- NoSQL
- Já o sistema NoSQL, se refere a tipos não relacionais de bancos de dados, e esses bancos de dados armazenam dados em um formato diferente das tabelas relacionais. No entanto, os bancos de dados NoSQL podem ser consultados usando
- API's APIs de linguagem idiomática, linguagens de consulta estruturadas declarativas e linguagens de consulta, por exemplo, razão pela qual também são chamados de bancos de dados "não apenas SQL
- Já o sistema NoSQL, se refere a tipos não relacionais de bancos de dados, e esses bancos de dados armazenam dados em um formato diferente das tabelas relacionais. No entanto, os bancos de dados NoSQL podem ser consultados usando
- NoSQL
- Flexibilidade: Não requerem um esquema fixo, o que permite armazenar diferentes tipos de dados. • Escalabilidade: Projetados para escalar horizontalmente, e são capazes de lidar com volumes muito grandes de dados. • Tipos: Chave-valor, documentos, colunas largas, grafos. • Exemplos: MongoDB (documentos), Cassandra (colunas largas), Neo4j (grafos).
- SQL Databases
- Estruturados: Adequados para dados que se encaixam bem em modelos tabulares rígidos. • Transações: Suportam operações de transação complexas com integridade de dados e consistência. • Exemplos: PostgreSQL, MySQL, Oracle Database
- O PostgreSQL é um SGBD ou Sistema de Gerenciamento de Bancos de Dados objeto-relacional de uso geral, um dos mais avançado sistema de banco de dados de código aberto existente do mercado.
- Estruturados: Adequados para dados que se encaixam bem em modelos tabulares rígidos. • Transações: Suportam operações de transação complexas com integridade de dados e consistência. • Exemplos: PostgreSQL, MySQL, Oracle Database
- NoSQL Database
- APLICAÇÃO DE BIG DATA
- 6. Aplicações de Big Data Big Data tem um vasto leque de aplicações em diversos setores, revolucionando a maneira como as organizações operam, tomam decisões e inovam. Este módulo explora como o Big Data está sendo utilizado em diferentes indústrias, no governo e em conjunto com a Internet das Coisas (IoT). 6.1 Big Data na Indústria: Saúde, Finanças, Varejo e Mais O impacto do Big Data se estende por várias indústrias, cada uma utilizando esses vastos conjuntos de dados de maneiras que melhoram a eficiência e a inovação. • Saúde: Big Data está transformando o setor de saúde ao melhorar o diagnóstico de doenças, personalizar tratamentos e otimizar a gestão hospitalar. Análise de grandes volumes de dados médicos ajuda na pesquisa e desenvolvimento de novos tratamentos e na prevenção de doenças através da identificação de padrões e riscos de saúde. • Finanças: Na indústria financeira, Big Data é usado para análise de riscos, detecção de fraudes, e personalização de serviços financeiros. Bancos e seguradoras utilizam algoritmos avançados para analisar o comportamento de compra dos clientes e ajustar suas ofertas de produtos. • Varejo: Comerciantes utilizam Big Data para entender melhor as preferências dos consumidores, otimizar a logística e gerir os estoques de maneira mais eficiente. Análises preditivas ajudam a prever tendências de mercado, otimizar preços e melhorar a experiência do cliente. 6.2 Big Data no Governo e Políticas Públicas Big Data oferece ferramentas poderosas para governos na formulação de políticas públicas, gestão urbana e segurança pública. • Formulação de Políticas: Análise de Big Data ajuda governos a criar políticas mais eficazes, baseadas em evidências reais. Isso inclui tudo desde políticas de saúde pública até estratégias econômicas. Big Data 12 ALFACON • Gestão Urbana: Cidades inteligentes utilizam Big Data para melhorar a infraestrutura urbana, como tráfego, serviços públicos e planejamento urbano, resultando em cidades mais eficientes e habitáveis. • Segurança Pública: Big Data é usado para melhorar a resposta a emergências, prevenção de crimes e monitoramento de áreas públicas, aumentando assim a segurança e bem-estar dos cidadãos. 6.3 Big Data e a Internet das Coisas (IoT) A combinação de Big Data com IoT está abrindo novas fronteiras para a análise de dados em tempo real e a automação. • Dispositivos Conectados: IoT envolve a conexão de dispositivos físicos à internet, que geram continuamente grandes quantidades de dados. Esses dados, quando analisados, podem melhorar significativamente a eficiência operacional e oferecer novos insights. • Automatização e Monitoramento: Em indústrias como manufatura e agricultura, IoT e Big Data são usados para monitorar e automatizar processos, melhorar a qualidade e a produção, e reduzir custos operacionais. • Análise Predominante: A integração de Big Data com IoT facilita a manutenção preditiva, que usa dados históricos e em tempo real para prever falhas em equipamentos antes que elas ocorram.
- TENDENCIAS FUTURAS EM BIG DATA
- 7. Tendências Futuras em Big Data À medida que a tecnologia continua avançando, o campo do Big Data também evolui, apresentando novos desenvolvimentos e influenciando diversas áreas da sociedade e da economia. Este módulo explora as principais tendências que moldarão o futuro do Big Data, incluindo inovações tecnológicas, o papel crescente da inteligência artificial e as mudanças no mercado de trabalho. 7.1 Desenvolvimentos Emergentes em Tecnologias de Big Data O futuro do Big Data será marcado por avanços significativos em tecnologia, que facilitarão a coleta, o processamento e a análise de dados em escalas anteriormente inimagináveis. • Edge Computing: Para lidar com a latência e os custos de transferência de grandes volumes de dados, a computação em borda (edge computing) processa dados mais perto de onde são gerados. Isso é especialmente relevante para aplicações IoT, onde dispositivos geram grandes quantidades de dados em tempo real. • Data Fabric e Data Mesh: Conceitos emergentes como data fabric e data mesh estão ganhando tração para oferecer uma arquitetura de dados mais flexível e descentralizada, facilitando o acesso e a compartilhamento de dados em grandes organizações. • Blockchain e Segurança de Dados: A aplicação de tecnologias blockchain para gerenciar grandes conjuntos de dados promete melhorar a segurança, a transparência e a integridade dos dados. 7.2 O Impacto da Inteligência Artificial e Aprendizado de Máquina A inteligência artificial (IA) e o aprendizado de máquina (ML) estão no coração da próxima onda de inovações em Big Data, transformando a forma como os dados são analisados e utilizados. • Automação de Análise de Dados: Algoritmos de ML estão permitindo a automação de complexas análises de dados, reduzindo a necessidade de intervenção humana e aumentando a eficiência. • IA Explicativa: À medida que a IA se torna mais integrada às decisões de negócios, surge uma demanda crescente por sistemas de IA explicativa, que podem detalhar como as decisões são feitas, aumentando a confiança nas análises baseadas em IA. • Personalização em Massa: A IA permite a personalização de produtos e serviços em escala, oferecendo experiências altamente adaptadas às necessidades e preferências individuais dos usuários. 7.3 O Futuro do Trabalho com Big Data As mudanças trazidas pelo Big Data também estão redefinindo o mercado de trabalho, criando novas oportunidades e desafios. • Crescente Demanda por Profissionais de Dados: Há uma necessidade crescente de profissionais especializados em dados, incluindo cientistas de dados, engenheiros de dados e analistas de dados, que possuem as habilidades para gerenciar e interpretar grandes volumes de informações. • Educação e Treinamento: À medida que o Big Data se torna mais central para as operações de negócios, a educação e o treinamento em análise de dados e ferramentas relacionadas se tornam essenciais para uma ampla gama de profissões. • Mudanças nas Habilidades Profissionais: As habilidades necessárias para trabalhar eficazmente com Big Data estão evoluindo, incluindo capacidades em estatística, programação, análise crítica e pensamento estratégico
- PROCESSAMENTO E ANÁLISE DE BIG DATA
- 5. Processamento e Análise de Big Data Para transformar grandes volumes de dados brutos em insights úteis e acionáveis, é essencial compreender e aplicar técnicas de processamento e análise de dados adequadas. Este módulo aborda o processamento paralelo e distribuído, explora métodos avançados de análise de dados, como machine learning e data mining, e discute a importância da visualização de dados no contexto do Big Data. 5.1 Introdução ao Processamento Paralelo e Distribuído O processamento paralelo e distribuído é fundamental para lidar com o Big Data, permitindo que grandes volumes de dados sejam processados de maneira eficiente e em tempo hábil. Processamento Paralelo: Envolve a execução de múltiplas operações ao mesmo tempo, dividindo tarefas grandes em partes menores que são processadas simultaneamente em múltiplos processadores. Processamento Distribuído: Consiste na distribuição de dados e tarefas de processamento através de múltiplos sistemas interconectados ou nodos, o que ajuda a aumentar a velocidade de processamento e a resiliência do sistema. Tecnologias-chave: • Apache Hadoop: Um framework que permite o processamento distribuído de grandes conjuntos de dados em clusters de computadores usando modelos de programação simples. • Apache Spark: Uma plataforma de computação em cluster que oferece uma API para programação distribuída, famosa por seu desempenho superior em processamento em memória. 5.2 Análise Avançada de Dados: Machine Learning e Data Mining A análise avançada de dados no Big Data envolve técnicas sofisticadas que permitem extrair padrões, detectar tendências e fazer previsões. Machine Learning: Algoritmos de aprendizado de máquina são usados para modelar e prever comportamentos, identificar padrões e tomar decisões com mínima intervenção humana. Inclui métodos como aprendizado supervisionado, não supervisionado e reforçado. Data Mining: O processo de descobrir padrões e relacionamentos ocultos em grandes volumes de dados. Utiliza técnicas estatísticas, de mineração de associação, de clustering e de detecção de anomalias. Aplicações: • Previsão de Comportamento do Consumidor: Usando machine learning para analisar dados de compra e personalizar ofertas. • Detecção de Fraude: Aplicação de algoritmos para identificar atividades suspeitas em transações financeiras. 5.3 Visualização de Dados em Big Data A visualização de dados é uma ferramenta crucial para a interpretação eficaz de resultados complexos de Big Data, permitindo que os usuários vejam padrões e insights de forma intuitiva. Ferramentas de Visualização: • Tableau: Uma plataforma poderosa que permite criar visualizações interativas e compartilháveis. • Power BI da Microsoft: Oferece uma gama de opções de visualização e integração de dados para visualizar e analisar informações em tempo real. • Dashboards de Dados: Usados para monitorar KPIs (Indicadores Chave de Performance) e outras métricas importantes em tempo real. Benefícios: • Compreensão Rápida: Permite que stakeholders compreendam tendências e resultados complexos rapidamente. • Tomada de Decisão Informada: Facilita a tomada de decisões baseada em dados visualizados de forma clara e compreensível.
- se refere à resistência ao fluxo de dados dentro de um sistema, impactando como os dados são capturados, processados e analisados.
- 3 Vs
- 5 Vs
- 8 Vs
- Visibilidade: A habilidade de visualizar dados de maneira que seja compreensível e acionável.
- Ferramentas de visualização de dados ajudam as organizações a entender grandes volumes de informações através de dashboards e gráficos
- Variabilidade: A inconsistência dos dados que pode aparecer devido à diversidade de fontes de dados e ao contexto dinâmico em que são gerados
- Em análises de sentimentos, a variabilidade pode ser vista na forma como as pessoas expressam sentimentos semelhantes de maneiras diferentes.
- Volatilidade: O tempo durante o qual os dados permanecem relevantes e o quão rápido eles precisam ser processados antes de perderem seu valor
- Em mercados financeiros, dados de preços de ações precisam ser processados rapidamente pois seu valor pode mudar em questão de segundos
- Visibilidade: A habilidade de visualizar dados de maneira que seja compreensível e acionável.
- Veracidade: Refere-se à qualidade e à precisão dos dados. Dados imprecisos podem levar a conclusões errôneas, portanto, a veracidade é crucial para garantir a confiabilidade na tomada de decisões
- No setor financeiro, a veracidade dos dados de transações é essencial para detectar e prevenir fraudes
- Valor: O potencial de valor dos dados. Big Data por si só não é útil a menos que possa ser transformado em insights valiosos que podem levar a uma vantagem competitiva ou resolver problemas específicos.
- Empresas de e-commerce analisam padrões de compra e feedback para oferecer recomendações personalizadas e melhorar as vendas
- 8 Vs
- • Volume: Refere-se à quantidade massiva de dados gerados a cada segundo. O volume de dados excede a capacidade dos sistemas de gerenciamento de banco de dados tradicionais em termos de armazenamento e processamento
- Empresas de mídia social como Facebook e Twitter geram petabytes de dados todos os dias a partir de postagens e interações dos usuários.
- Velocidade: A velocidade com que os dados são gerados e precisam ser processados é extremamente alta. Isso inclui a necessidade de processamento em tempo real para aplicações como monitoramento de mídia social, análise de transações financeiras e sensores IoT
- • Velocidade: A velocidade com que os dados são gerados e precisam ser processados é extremamente alta. Isso inclui a necessidade de processamento em tempo real para aplicações como monitoramento de mídia social, análise de transações financeiras e sensores IoT
- Sistemas de monitoramento de tráfego usam dados de sensores em tempo real para ajustar sinais de trânsito e rotas
- Variedade: Os dados vêm em uma ampla gama de formatos – desde dados estruturados, como números e datas, até dados não estruturados, como texto, vídeo, e imagens.
- : Empresas de varejo processam dados de transações (estruturados), feedback de clientes (não estruturados), e dados de mídia social (não estruturados)
- 5 Vs
- Métodos de coleta de dados em grande escala
- A coleta de dados em grande escala pode ser desafiadora devido ao volume, à velocidade e à variedade dos dados. Algumas abordagens comuns incluem: • Sensores e IoT (Internet das Coisas): Dispositivos conectados, como sensores em máquinas industriais ou wearables, que geram contínuas correntes de dados. • APIs (Interfaces de Programação de Aplicações): Utilização de APIs para coletar dados de serviços de terceiros, como redes sociais, serviços financeiros ou meteorológicos. • Web Scraping: Técnica usada para extrair dados de websites de forma automatizada. É útil para coletar informações públicas como preços de produtos, notícias ou dados de mercado. • Transações e Logs de Servidores: Dados gerados a partir de transações comerciais ou logs de atividades em sistemas e servidores.
- Técnicas de limpeza e Preparação de dados
- A limpeza e preparação de dados são essenciais para garantir a precisão das análises. Algumas técnicas fundamentais incluem: :
- dentificação e Tratamento de Valores Faltantes
- • Identificação e Tratamento de Valores Faltantes: Utilizar métodos para preencher ou excluir dados faltantes, dependendo do contexto e da quantidade de dados ausentes.
- Normalização e Padronização
- Converter dados para um formato comum para facilitar análise, como padronizar datas, categorias e textos.
- Correção de Inconsistências e Erros:
- Correção de Inconsistências e Erros: Revisar e corrigir dados que são digitados incorretamente, duplicados ou que não seguem um formato padrão.
- Redução de Dimensionalidade
- Técnicas como análise de componentes principais (PCA) para reduzir o número de variáveis, mantendo as informações mais importantes.
- Armazenamento e Gerenciamento eficiente de dados
- O armazenamento e o gerenciamento eficientes de dados são críticos para lidar com o volume e a complexidade do Big Data: Data Warehouses e Data Lakes: • Data Warehouse: Estruturado para consultas e análise de dados. Ideal para dados que requerem processamento intensivo de transações. • Data Lake: Armazena grandes volumes de dados brutos em seu formato original. Mais adequado para dados não estruturados e para situações onde o esquema dos dados não é definido antecipadamente. Tecnologias de Armazenamento: • Soluções Baseadas em Nuvem: Plataformas como Amazon S3, Google Cloud Storage e Azure Data Lake oferecem escalabilidade, durabilidade e flexibilidade. • Bancos de Dados NoSQL: Como MongoDB, Cassandra e HBase, que são projetados para escalar horizontalmente e são ótimos para lidar com dados semi-estruturados e não estruturados. Segurança e Governança de Dados: Big Data 10 ALFACON Implementação de políticas de segurança rigorosas e ferramentas de governança para proteger os dados contra acessos não autorizados e garantir conformidade com as regulamentações de dados
- EVOLUÇÃO
Information
- Description
- concurso Informática Mind Map on 8 - Big Dados, created by JOHNATAS R on 16/09/2024.
- Created by
- JOHNATAS R
- Views
- 0
- History
-
- Created by JOHNATAS R · Aug 10, 2024
- Copied by JOHNATAS R · Sep 16, 2024
- Copied by JOHNATAS R · Sep 16, 2024
- Copied by JOHNATAS R · Sep 16, 2024
- Rating