
Mindmap
Técnicas de Validación
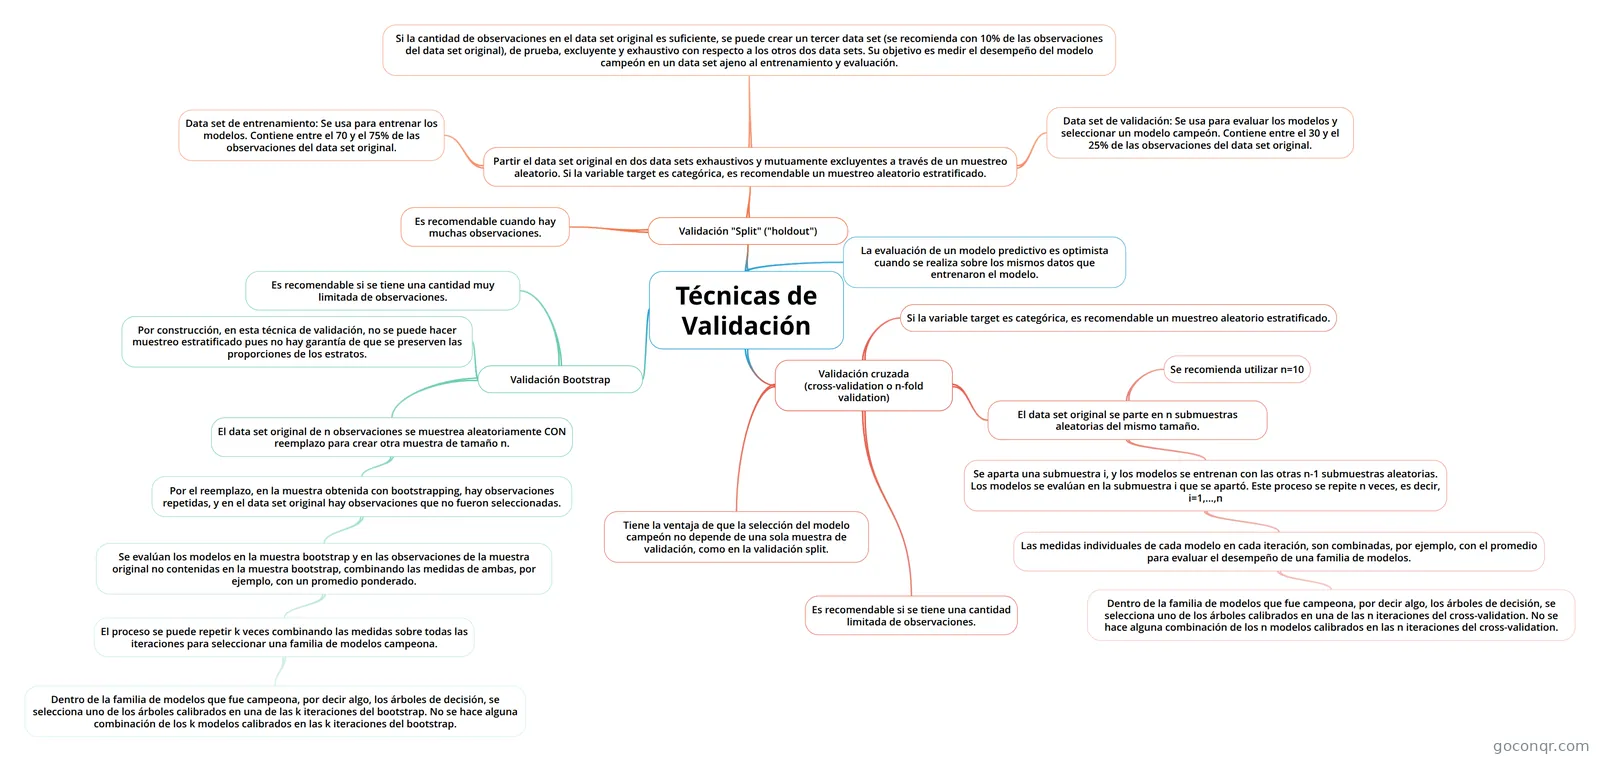
Mapa mental: Técnicas de validación
Inhalt der Mindmap
Técnicas de Validación
La evaluación de un modelo predictivo es optimista cuando se realiza sobre los mismos datos que entrenaron el modelo.
Validación "Split" ("holdout")
- Partir el data set original en dos data sets exhaustivos y mutuamente excluyentes a través de un muestreo aleatorio. Si la variable target es categórica, es recomendable un muestreo aleatorio estratificado.
- Data set de entrenamiento: Se usa para entrenar los modelos. Contiene entre el 70 y el 75% de las observaciones del data set original.
- Data set de validación: Se usa para evaluar los modelos y seleccionar un modelo campeón. Contiene entre el 30 y el 25% de las observaciones del data set original.
- Si la cantidad de observaciones en el data set original es suficiente, se puede crear un tercer data set (se recomienda con 10% de las observaciones del data set original), de prueba, excluyente y exhaustivo con respecto a los otros dos data sets. Su objetivo es medir el desempeño del modelo campeón en un data set ajeno al entrenamiento y evaluación.
- Es recomendable cuando hay muchas observaciones.
- Partir el data set original en dos data sets exhaustivos y mutuamente excluyentes a través de un muestreo aleatorio. Si la variable target es categórica, es recomendable un muestreo aleatorio estratificado.
Validación cruzada (cross-validation o n-fold validation)
- Es recomendable si se tiene una cantidad limitada de observaciones.
- El data set original se parte en n submuestras aleatorias del mismo tamaño.
- Se aparta una submuestra i, y los modelos se entrenan con las otras n-1 submuestras aleatorias. Los modelos se evalúan en la submuestra i que se apartó. Este proceso se repite n veces, es decir, i=1,...,n
- Las medidas individuales de cada modelo en cada iteración, son combinadas, por ejemplo, con el promedio para evaluar el desempeño de una familia de modelos.
- Dentro de la familia de modelos que fue campeona, por decir algo, los árboles de decisión, se selecciona uno de los árboles calibrados en una de las n iteraciones del cross-validation. No se hace alguna combinación de los n modelos calibrados en las n iteraciones del cross-validation.
- Las medidas individuales de cada modelo en cada iteración, son combinadas, por ejemplo, con el promedio para evaluar el desempeño de una familia de modelos.
- Se recomienda utilizar n=10
- Se aparta una submuestra i, y los modelos se entrenan con las otras n-1 submuestras aleatorias. Los modelos se evalúan en la submuestra i que se apartó. Este proceso se repite n veces, es decir, i=1,...,n
- Tiene la ventaja de que la selección del modelo campeón no depende de una sola muestra de validación, como en la validación split.
- Si la variable target es categórica, es recomendable un muestreo aleatorio estratificado.
Validación Bootstrap
- Es recomendable si se tiene una cantidad muy limitada de observaciones.
- El data set original de n observaciones se muestrea aleatoriamente CON reemplazo para crear otra muestra de tamaño n.
- Por el reemplazo, en la muestra obtenida con bootstrapping, hay observaciones repetidas, y en el data set original hay observaciones que no fueron seleccionadas.
- Se evalúan los modelos en la muestra bootstrap y en las observaciones de la muestra original no contenidas en la muestra bootstrap, combinando las medidas de ambas, por ejemplo, con un promedio ponderado.
- El proceso se puede repetir k veces combinando las medidas sobre todas las iteraciones para seleccionar una familia de modelos campeona.
- Dentro de la familia de modelos que fue campeona, por decir algo, los árboles de decisión, se selecciona uno de los árboles calibrados en una de las k iteraciones del bootstrap. No se hace alguna combinación de los k modelos calibrados en las k iteraciones del bootstrap.
- El proceso se puede repetir k veces combinando las medidas sobre todas las iteraciones para seleccionar una familia de modelos campeona.
- Se evalúan los modelos en la muestra bootstrap y en las observaciones de la muestra original no contenidas en la muestra bootstrap, combinando las medidas de ambas, por ejemplo, con un promedio ponderado.
- Por el reemplazo, en la muestra obtenida con bootstrapping, hay observaciones repetidas, y en el data set original hay observaciones que no fueron seleccionadas.
- Por construcción, en esta técnica de validación, no se puede hacer muestreo estratificado pues no hay garantía de que se preserven las proporciones de los estratos.
Informationen
- Beschreibung
- Mapa mental de técnicas de validación de modelos predictivos
- Erstellt von
- Jose Enrique Perez Salvador
- Aufrufe
- 93
- Tags
- Bewertung