
Fichas
FOST 2 Deskriptive und explorative Datenanalyse
Fichas del conjunto (78)
- 1Ziel der deskriptiven und explorativen Datenanalysewichtigste Aussagen der Rohdaten beschreiben und grafisch darstellen
- 2Schritte der statistischen Auswertung- deskriptive Statistik
- explorative Statistik
- Inferenzstatistik - 3deskriptive Statistik= alle Methoden zur zusammenfassenden Darstellung und Beschreibung von empirischen Daten
- dazu dienen Kennwerte, Grafiken und Tabellen - 4explorative Statistik= Durchsuchen der Daten nach bestimmten Mustern oder Zusammenhängen
- bietet sich für komplexe Daten an - 5statistische Kennwerte= grundlegendste & häufigste Möglichkeit zur Beschreibung von Daten
- Anteile
- Häufigkeiten
- Lagemaße
- Streuungsmaße - 6demografischen Datenwird in fast allen Studien erfragt, z.B. Alter, Geschlecht, Familienstand...
- 7Anteile und Häufigkeiten= Daten in Nominalskala werden in Kategorien dargestellt (z.B. männlich, weiblich)
--> dadurch entsteht die Häufigkeit (z.B. 30 von 50 etc.)
Häufigkeit = nominal; Anteil = prozentual - 8Ratings= differenzierte Darstellung der Kategorien (Intervallskala)
= Erstellen von Reihenfolge der Werte - 9mögliche Darstellung von Anteilen und Häufigkeiten- Zahlenwerte
- Tabellen
- Abbildungen (Diagramme) - 10N (kursiv)Anzahl von Personen, die an der Studie teilgenommen haben / Stichprobengröße
- 11MerkmalachseX-Achse bei der Darstellung von Häufigkeitsverteilungen - dort steht das gemessene Merkmal
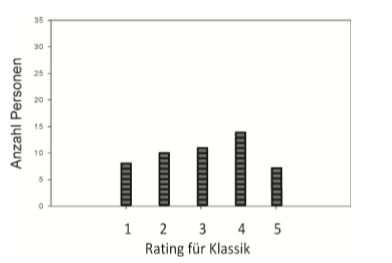
= kategoriale Variable, gemessen auf Nominalskala - 12Häufigkeitsverteilungen= Darstellung der Anzahl / Anteil von Personen, die bestimmten Messwert erzielt haben
- 13Charakterisierung der Häufigkeitsverteilung- Lagemaß (Mittelwert alleine ist nicht aussagekräftig genug!)
- Streuungsmaß - 14Lage der Verteilung= Wert, um den sich die Verteilung konzentriert
- 15Kennwerte für die Lage der Verteilung= Lagemaße, stehen für Häufigkeitsverteilung
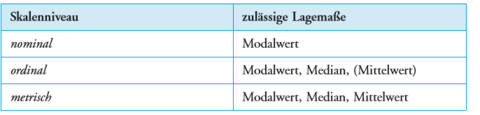
- abhängig vom Skalenniveau:
- Modalwert
- Median
Mittelwert - 16Modalwert / Modus einer Verteilung= häufigste Merkmalsausprägung
- 17Median= welcher Wert liegt in der Mitte (Anzahl der Werten!) der Verteilung
- robust gegenüber Ausreißern
- erst ab Ordinalskala möglich
- häufige Anwendung bei explorativer Datenanalyse - 18Modalwert ist nicht gleich Medianbei einer unsymmetrische Häufigkeits-verteilung
- 19Mittelwert- wird auf eine Nachkommastelle gerundet
- häufigstes Lagemaß
- Ausreißer beeinflussen M
- notwendig für weitere statistische Berechnungen
- steht stellvertretend für Verteilung
- 20x (kursiv)einzelner Messwert
- 21i (kursiv)Index
- 22Unterschied der grafischen Darstellung des Mittelwerts vs. HäufigkeitsverteilungBei grafischer Darstellung des Mittelwertes:
- Merkmal auf Y-Achse
- Keine Häufigkeitsverteilung / Personen
--> Mittelwerte entstehen aus Häufigkeitsverteilungen - 23Mittelwerte auf Ordinalskalasollte vermieden werden. Differenz zwischen Stufen der Ordinalskala ist nicht ersichtlich, deswegen ist Mittelwert nicht dafür geeignet
- 24Lagemaße bei unterschiedlichen Skalenniveaus
- 25Streuungsmaße- Spannweite (Range)
- Interquartilsabstand
- Varianz
- Standardabweichung
- - 26Spannweite= Differenz zwischen größten und kleinsten gewählten Wert der Daten
- schlechte Differenzierung zwischen unterschiedlichen Verteilungen
- anfällig gegenüber Ausreißern
- seltene Anwendung - 27InterquartilsabstandFOST S. 20
- 28Varianz (s²)= durchschnittliche quadrierte Abweichung aller Werte vom gemeinsamen Mittelwert
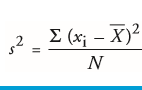
- 29Standardabweichung (s oder SD)= Wurzel aus Varianz
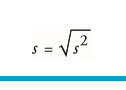
- 30bestes Streuungsmaß um die durchschnittliche Abweichung vom Mittelwert zu bestimmenVarianz und Standardabweichung (sehr genaue Differenzierung zwischen den unterschiedlichen Verteilungen)
- 31Kennwerte= Angaben über Stichproben (z.B. Mittelwerte, SD)
- lateinische Buchstaben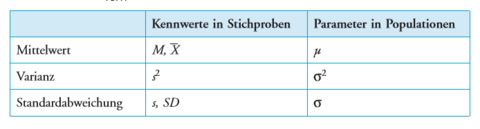
- 32Parameter= Angaben über Populationen
- Schätzwerte
- griechische Buchstaben
- 33Varianzaufklärung= wichtigstes Ziel der Statistik
= welchen Anteil der Varianz der AV kann die UV aufklären - 34Fehlervarianz= Teil der Varianz, der aufgrund der natürlichen Streuung entsteht
- 35durch UV hervorgerufene Varianz= Effekt der UV
= sollte möglichst groß - 36Gesetz der großen Zahlen (Jakob Bernoulli)= Je größer die Stichprobe desto eher entspricht die Häufigkeitsverteilung der Populationsverteilung
--> wir vertrauen großen Stichproben mehr als kleinen (ab 30 Personen zuverlässige Werte) - 37unsichtbare Populationsverteilungdie Populationsverteilung ist unbekannt, deswegen: große Stichprobe --> Schätzung der entsprechenden Werte in der Population
- 38Formen der Verteilung- symmetrische Verteilung
- schiefe Verteilung
-unimodale Verteilung
- bimodale Verteilung - 39schiefe Verteilung= Verteilung ist in eine Richtung eingeschränkt
-> z.B. Deckeneffekt (weiter nach oben ist nicht möglich)
--> Mittelwert ist ebenfalls verzerrt - 40unimodale Verteilung= ein "Gipfel"/Hochwert in der Verteilung
- 41bimodale Verteilung= Variable hat zwei Merkmalsausprägungen (Gipfel/Höchstwerte)
--> Mittelwert wenig informativ - 42Normalverteilung= symmetrische und unimodale Verteilung in einer Glockenform (Gauss'sche Glockenform)
- 43Vorteil der Normalverteilung+ Wissen: Merkmale sind normalverteilt --> Form der Verteilung klar --> nur noch Mittelwert und Streuung notwendig
ABER: immer Normalverteilung prüfen! - 44z-Transformation / z-Standardisierung= unterschiedliche Skalen auf eine Skala transformieren und so umrechnen und vergleichbar machen
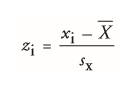
- 45Besondere an z-Transformation= standardisierte Skala
Mittelwert = 0
SD = 1
muss für jeden Wert einzeln berechnet werden - 46z-Verteilung / Standardnormalverteilung= stellt dar wie viel Prozent über / unter dem Mittelwert sind
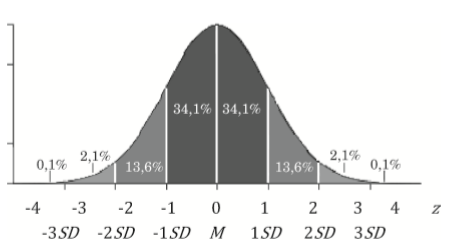
- 47grafische Datenanalyse bei der explorativen Datenanalyse- Boxplot
- Stamm- & Blatt-Diagramm
- Streudiagramm (Scatterplot)
- Sonnenblumendiagramm
- Bubble Plot
- Streudiagrammmatrix (Scatterplotmatrix) - 48Boxplot= grafische Darstellung des Median (Strich im Kasten) und Interquartilsabstand (graue Box)
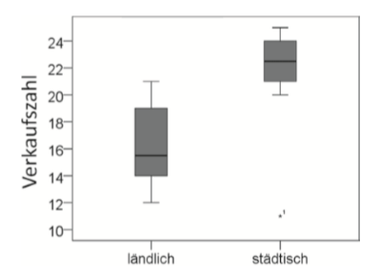
- 49Informationen, die man aus der Boxplot zieht- Median -> deutet auch die Verteilung an
- Interquartilsabstand
- Ausreißer (mit Stern und Nummer versehen)
- Whiskers - 50Whiskers (Barthaare)= kleinen Querstriche oben und unten des Boxplot
Interquartilsabstand * 1,5 (oben und unten der Boxplot)
Nur die Werte die außerhalb den Whiskers sind, sind Ausreißer - 51Vorteile von Boxplot+ unverzerrte Darstellung der Rohdaten
+ Ausreißer identifizieren --> werden meist aus Daten entfernt - 52Stamm- und Blatt-Diagramm (Stem & Leaf Plot)kein Informationsverlust; jede Zahl bei Leaf = 1 Person
* zwischen 0-4 und . 5-9 -> liegt aber im eigenen Ermessen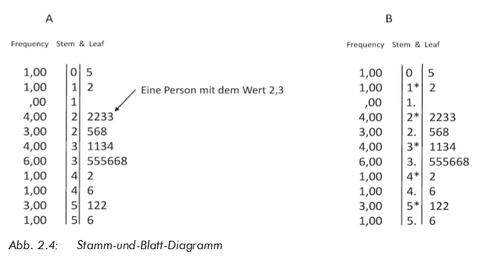
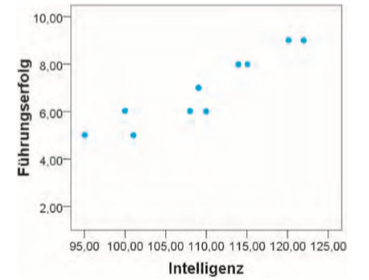
- 53Streudiagramm (Scatterplot)Darstellung von zwei Variablen in einem Diagramm; 1 Person = 1 Punkt
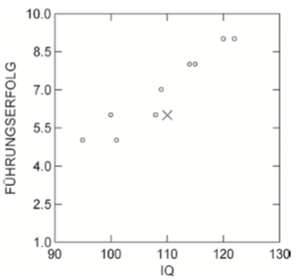
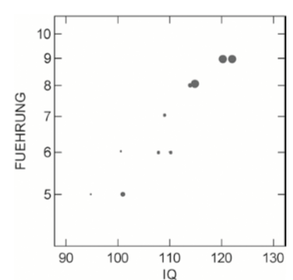
- 54Sonnenblummendiagrammübereinstimmende Daten werden als Sonnenblumen dargestellt; ansonsten wären identische Werte nicht ersichtlich
- 55Bubble-Plot3 Variablen, dritte wird in der Größe des Punktes dargestellt
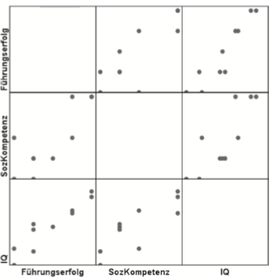
- 56Streudiagramm-Matrix (Scatterplot-Matrix)Darstellung mehrerer Variablen durch jeweilige Streudiagramme von 2 Variablen
- 57(bivariaten) Korrelation= Ausmaß des linearen Zusammenhangs zweier Variablen
- 58positiv korrelierte Datenlinearer Zusammenhang
aber perfekte Datenzusammen-hänge kommen in der Forschung eher nicht vor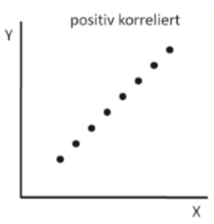
- 59negativ korrelierte Datenlinearer Zusammenhang
aber perfekte Datenzusammen-hänge kommen in der Forschung eher nicht vor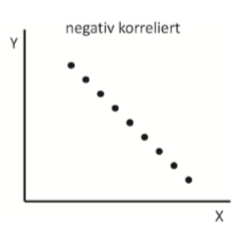
- 60unkorrelierende DatenEs besteht kein Zusammenhang
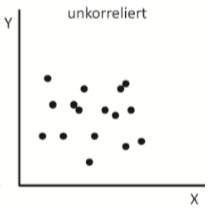
- 61nicht lineare Zusammenhänge- werden nicht weiter berechnet
- kurvilinearen Zusammenhänge sind nicht selten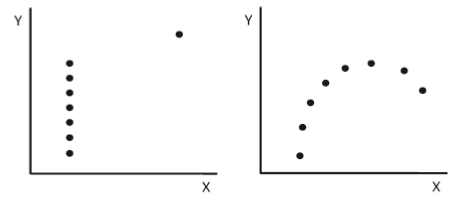
- 62Kovarianz= zwei Variablen sind in der Ausprägung abhängig voneinander
- gleiche Skala notwendig --> unterschiedliche Skala: Korrelation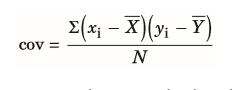
- 63KorrelationskoeffizientKovarianz unabhängig der Skala zu machen
Anwendung der Streuung
--> Kovarianz / Streuung beider Variablen = Korrelation (r) (Werte zwischen -1 und 1)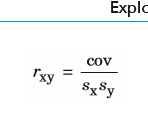
- 64Regression= Vorhersageanalyse - nutzt Korrelation, um Werte der Variable1 (Kriterium) aus den Werten der Variable 2 (Prädiktor) hervorzusagen
- 65Korrelationskoeffizient= Varianzaufklärung
Alle Werte auf einer Geraden -> beide Variablen voneinander abhängig - 66Gründe für keine vollständige Gesamtvarianz- Messfehler
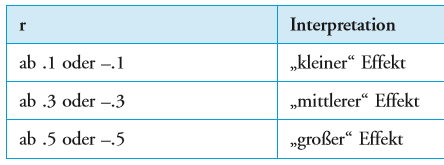
- Varianz korreliert nicht nur mit einer Variable sondern mit mehreren - 67Interpretation von Korrelation nach Cohen (Faustregel)
- 68Voraussetzungen für Korrelationsberechnung- intervallskalierte Daten oder dichotome Variablen
- linearer Zusammenhang (Streudiagramm nutzen!) - 69Korrelation vs. KausalitätKorrelation lässt keine Rückschlüsse auf inhaltliche Kausalität zu
- 70mögliche Zusammenhänge zwischen Variablen- X ruft Y hervor
- Y ruft X hervor
- Zusammenhang zwischen X und Y wird durch Z bedingt (=Scheinkorrelation) - 71Wichtigkeit von Experimenten für die Forschung= aus experimentell gewonnene Daten berechnete Korrelation lassen Kausalschlüsse zu
- 72dichotome Variablen= Variable hat zwei Ausprägungen
- 73RegressionsgeradeBestimmung der Gerade:
- Gerade beliebig in Punktewolke legen
- Abweichungsquadrat bestimmen (Abstand der Punkte zur Geraden vertikal messen & quadrieren)
- Quadratsumme bilden (Abweichungsquadrat aller Punkte)
- Gerade anpassen bis die Quadratsumme so gering wie möglich ist - 74Vorhersagefehler / Residuum / Residualwert= Differenz zwischen Schätzung und wahrem Wert in der Population;
= Abweichungen auf Y von der Regressionsgerade --> ist nicht erklärbar
--> Y-Wert ist nur eine Schätzung!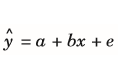
- 75Anwendungsfelder der Regression- konkrete Werte eine Variable vorherzusagen
- Enge des Zusammenhangs & Güte der Vorhersage - 76Determinationskoeffizient r²= Ausmaß der Varianzerklärung von Variable Y zu Variable X
= Korrelationskoeffizient ² - 77einfache lineare Regression= schätzt den Wert einer Person mithilfe der Ausprägung einer Prädiktorvariable auf einer Kriteriumsvariable
- beruhen auf bivariater Korrelation - 78Werte der Regression- β (Beta-Gewicht) = r (bei bivariater Korrelation)
- r² (Determinations-Koeffizient)
Información
- Descripción
- (FOST 1 -4) FOST Fichas sobre FOST 2 Deskriptive und explorative Datenanalyse, creado por Kathy H el 02/08/2016.
- Creado por
- Kathy H · ago 2016
- Actualizado
- 23 abr 2019
- Visitas
- 373
- Etiquetas
- Valoración