
Mind map
Evaluating the Scalability of Distributed Systems
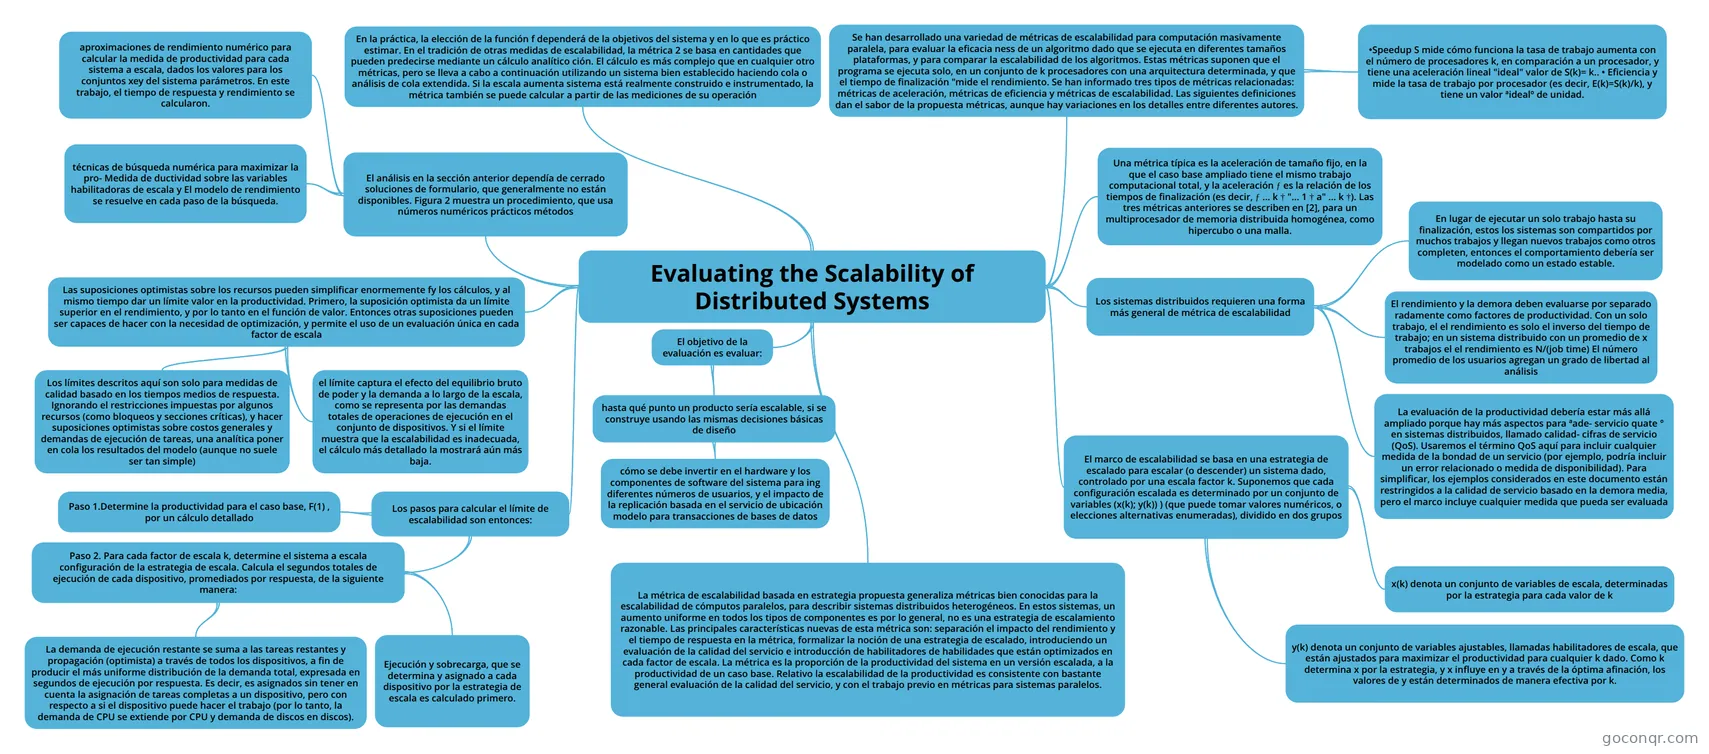
Mind map: evaluating the scalability of distributed systems
Map content
Evaluating the Scalability of Distributed Systems
Se han desarrollado una variedad de métricas de escalabilidad para computación masivamente paralela, para evaluar la eficacia ness de un algoritmo dado que se ejecuta en diferentes tamaños plataformas, y para comparar la escalabilidad de los algoritmos. Estas métricas suponen que el programa se ejecuta solo, en un conjunto de k procesadores con una arquitectura determinada, y que el tiempo de finalización "mide el rendimiento. Se han informado tres tipos de métricas relacionadas: métricas de aceleración, métricas de eficiencia y métricas de escalabilidad. Las siguientes definiciones dan el sabor de la propuesta métricas, aunque hay variaciones en los detalles entre diferentes autores.
- •Speedup S mide cómo funciona la tasa de trabajo aumenta con el número de procesadores k, en comparación a un procesador, y tiene una aceleración lineal "ideal" valor de S(k)= k.. • Eficiencia y mide la tasa de trabajo por procesador (es decir, E(k)=S(k)/k), y tiene un valor ªidealº de unidad.
Una métrica típica es la aceleración de tamaño fijo, en la que el caso base ampliado tiene el mismo trabajo computacional total, y la aceleración ƒ es la relación de los tiempos de finalización (es decir, ƒ ... k † "... 1 † a" ... k †). Las tres métricas anteriores se describen en [2], para un multiprocesador de memoria distribuida homogénea, como hipercubo o una malla.
Los sistemas distribuidos requieren una forma más general de métrica de escalabilidad
- En lugar de ejecutar un solo trabajo hasta su finalización, estos los sistemas son compartidos por muchos trabajos y llegan nuevos trabajos como otros completen, entonces el comportamiento debería ser modelado como un estado estable.
- El rendimiento y la demora deben evaluarse por separado radamente como factores de productividad. Con un solo trabajo, el el rendimiento es solo el inverso del tiempo de trabajo; en un sistema distribuido con un promedio de x trabajos el el rendimiento es N/(job time) El número promedio de los usuarios agregan un grado de libertad al análisis
- La evaluación de la productividad debería estar más allá ampliado porque hay más aspectos para ªade- servicio quate ° en sistemas distribuidos, llamado calidad- cifras de servicio (QoS). Usaremos el término QoS aquí para incluir cualquier medida de la bondad de un servicio (por ejemplo, podría incluir un error relacionado o medida de disponibilidad). Para simplificar, los ejemplos considerados en este documento están restringidos a la calidad de servicio basado en la demora media, pero el marco incluye cualquier medida que pueda ser evaluada
El marco de escalabilidad se basa en una estrategia de escalado para escalar (o descender) un sistema dado, controlado por una escala factor k. Suponemos que cada configuración escalada es determinado por un conjunto de variables (x(k); y(k)) ) (que puede tomar valores numéricos, o elecciones alternativas enumeradas), dividido en dos grupos
- x(k) denota un conjunto de variables de escala, determinadas por la estrategia para cada valor de k
- y(k) denota un conjunto de variables ajustables, llamadas habilitadores de escala, que están ajustados para maximizar el productividad para cualquier k dado. Como k determina x por la estrategia, y x influye en y a través de la óptima afinación, los valores de y están determinados de manera efectiva por k.
En la práctica, la elección de la función f dependerá de la objetivos del sistema y en lo que es práctico estimar. En el tradición de otras medidas de escalabilidad, la métrica 2 se basa en cantidades que pueden predecirse mediante un cálculo analítico ción. El cálculo es más complejo que en cualquier otro métricas, pero se lleva a cabo a continuación utilizando un sistema bien establecido haciendo cola o análisis de cola extendida. Si la escala aumenta sistema está realmente construido e instrumentado, la métrica también se puede calcular a partir de las mediciones de su operación
El análisis en la sección anterior dependía de cerrado soluciones de formulario, que generalmente no están disponibles. Figura 2 muestra un procedimiento, que usa números numéricos prácticos métodos
- aproximaciones de rendimiento numérico para calcular la medida de productividad para cada sistema a escala, dados los valores para los conjuntos xey del sistema parámetros. En este trabajo, el tiempo de respuesta y rendimiento se calcularon.
- técnicas de búsqueda numérica para maximizar la pro- Medida de ductividad sobre las variables habilitadoras de escala y El modelo de rendimiento se resuelve en cada paso de la búsqueda.
Las suposiciones optimistas sobre los recursos pueden simplificar enormemente fy los cálculos, y al mismo tiempo dar un límite valor en la productividad. Primero, la suposición optimista da un límite superior en el rendimiento, y por lo tanto en el función de valor. Entonces otras suposiciones pueden ser capaces de hacer con la necesidad de optimización, y permite el uso de un evaluación única en cada factor de escala
- Los límites descritos aquí son solo para medidas de calidad basado en los tiempos medios de respuesta. Ignorando el restricciones impuestas por algunos recursos (como bloqueos y secciones críticas), y hacer suposiciones optimistas sobre costos generales y demandas de ejecución de tareas, una analítica poner en cola los resultados del modelo (aunque no suele ser tan simple)
- el límite captura el efecto del equilibrio bruto de poder y la demanda a lo largo de la escala, como se representa por las demandas totales de operaciones de ejecución en el conjunto de dispositivos. Y si el límite muestra que la escalabilidad es inadecuada, el cálculo más detallado la mostrará aún más baja.
Los pasos para calcular el límite de escalabilidad son entonces:
- Paso 1.Determine la productividad para el caso base, F(1) , por un cálculo detallado
- Paso 2. Para cada factor de escala k, determine el sistema a escala configuración de la estrategia de escala. Calcula el segundos totales de ejecución de cada dispositivo, promediados por respuesta, de la siguiente manera:
- Ejecución y sobrecarga, que se determina y asignado a cada dispositivo por la estrategia de escala es calculado primero.
- La demanda de ejecución restante se suma a las tareas restantes y propagación (optimista) a través de todos los dispositivos, a fin de producir el más uniforme distribución de la demanda total, expresada en segundos de ejecución por respuesta. Es decir, es asignados sin tener en cuenta la asignación de tareas completas a un dispositivo, pero con respecto a si el dispositivo puede hacer el trabajo (por lo tanto, la demanda de CPU se extiende por CPU y demanda de discos en discos).
El objetivo de la evaluación es evaluar:
- hasta qué punto un producto sería escalable, si se construye usando las mismas decisiones básicas de diseño
- cómo se debe invertir en el hardware y los componentes de software del sistema para ing diferentes números de usuarios, y el impacto de la replicación basada en el servicio de ubicación modelo para transacciones de bases de datos
- hasta qué punto un producto sería escalable, si se construye usando las mismas decisiones básicas de diseño
La métrica de escalabilidad basada en estrategia propuesta generaliza métricas bien conocidas para la escalabilidad de cómputos paralelos, para describir sistemas distribuidos heterogéneos. En estos sistemas, un aumento uniforme en todos los tipos de componentes es por lo general, no es una estrategia de escalamiento razonable. Las principales características nuevas de esta métrica son: separación el impacto del rendimiento y el tiempo de respuesta en la métrica, formalizar la noción de una estrategia de escalado, introduciendo un evaluación de la calidad del servicio e introducción de habilitadores de habilidades que están optimizados en cada factor de escala. La métrica es la proporción de la productividad del sistema en un versión escalada, a la productividad de un caso base. Relativo la escalabilidad de la productividad es consistente con bastante general evaluación de la calidad del servicio, y con el trabajo previo en métricas para sistemas paralelos.
Information
- Description
- Ingeniería de Sistemas Mind Map on Evaluating the Scalability of Distributed Systems, created by David Cermeño on 11/05/2018.
- Created by
- David Cermeño
- Views
- 1
- Rating