
Mind map
Spanish word embedding
Map content
Spanish word embedding
Word2Vec
- Log-Lineal model continuous bag of words CBOW
- Proyección de una palabra, sobre las palabras de contexto
- Skip-gram
- Omite la palabra y calcula proyección sobre palabras de contexto
- Log-Lineal model continuous bag of words CBOW
Qué se usó
- BD
- Adaptación de las BD al español
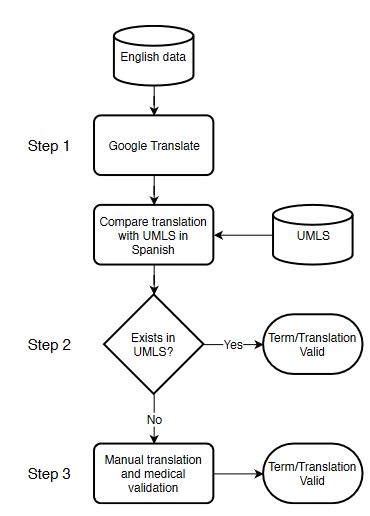
- 1. Google traslate, 2. Los comceptos hallados, se comparan con el CUI (asignación de términos correctos), 3. Los conceptos no hallados se evalua manualmente
- SBWCE - Spanish Billion word corpus
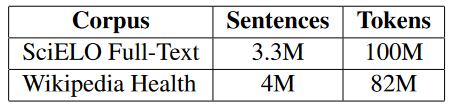
- Scielo y wikipedia principalmente
- Scielo tiene 22% más tokens (palabras) y Wikipedia tiene mas datos
- Adaptación de las BD al español
- Word2Vec embedding pre entrenado
- Universidad de chile desarrolló y tiene público uno en español
- BD
Conclusiones
- Algunas de las revisiones realizadas por los autores mencionados no realizaron evaluación extrínseca
- Los word embeddings desarrollados pueden ser adaptados para desarrollar resumenes
- No se clasiican drogas porque varrían mucho por territorios
Evaluación
- Se adaptaron las BD que estaban en inglés para el español
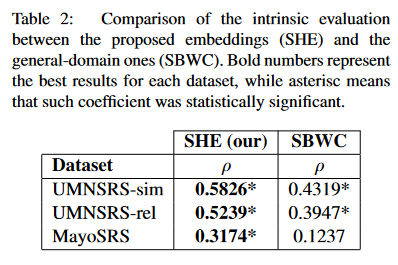
- Intrínseca
- tareas específicas que solo están relacionadas con la incrustación en sí, como las relaciones sintácticas o semánticas entre palabras. Los ejemplos más comunes son evaluaciones de similitud, parentesco y analogía
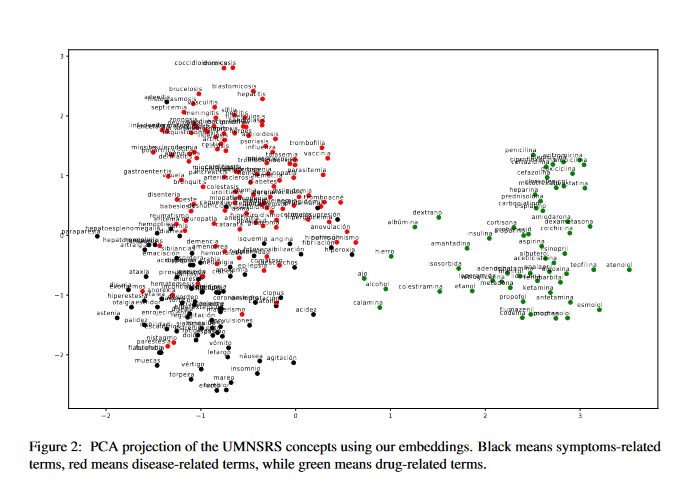
- UMNSRS, MayoSRS
- Se tradujeron las BD
- UMNSRS, MayoSRS
- tareas específicas que solo están relacionadas con la incrustación en sí, como las relaciones sintácticas o semánticas entre palabras. Los ejemplos más comunes son evaluaciones de similitud, parentesco y analogía
- Extrínseca
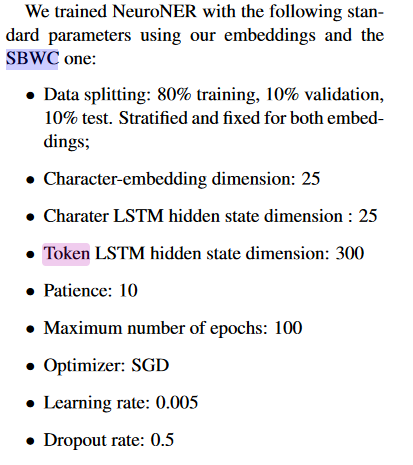
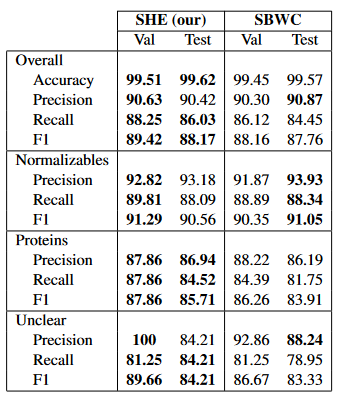
- NER
- Datos: Spanish Clinical Case Corpus (SPACCC)
- MyMiner
- redes neuronales, que se basan en la memoria a corto plazo (LSTM) para predecir la etiqueta de una secuencia de tokens
- En la data usaron embeddings disponibles
- Datos: Spanish Clinical Case Corpus (SPACCC)
- NER
Metodología
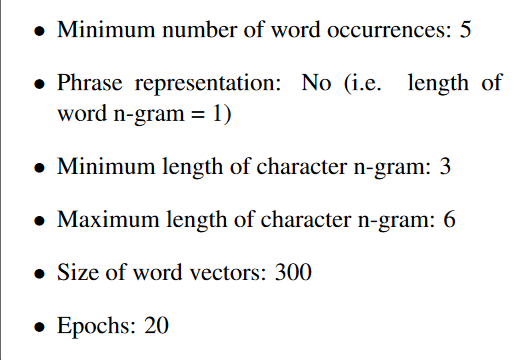
- FastText
- Usa varios subcomponentes para obtener embeddings de mejor calidad (milokov et al)
- CBOW con posición dependiente de peso
- Minimiza costo computacional
- Aprende representaciones de posición
- se fusionan las palanas para capturarlo Brain_Dead
- Word2Vec basico no es sensible al orden de las palabras
- Cada palabra se descompone en sus caracteres n-gramas que luego se aprenden.
- vector de palabra final es la suma simple del vector de palabra y sus representaciones de n-gramas
- evita que los vectores de palabras estándar ignoren la estructura interna de la palabra
- Detección de languaje BD
- langdetect de python
- Wikipedia API de python
- Embeddings
- SHE: Spanish health embedding: Propuesto
- SBWC embedding: Spanish Billion Word Corpus embedding pre entrenado
- FastText
Images and files in the map
Information
- Description
- https://aclanthology.org/W19-1916.pdf Article review
- Created by
- yasmin ceballos
- Views
- 11
- Rating