
Flashcards
FOST 3 - Inferenzstatistik
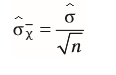
Flashcards do conjunto (83)
- 1Ziel der InferenzstatistikSchlüsse von einer Stichprobe auf Population zu ziehen sowie Aussagen über die Güte der Schlüsse
- 2wie kann man sicherstellen, dass Ergebnis einer Stichprobe auf Population verallgemeinert werden kann- Metaanalysen
- Berücksichtigung der Wahrscheinlichkeit, dass die Bestimmung des Ergebnis aus der Stichprobe falsch ist - 3Stichprobenverteilung= Streuung der Mittelwerte aus einzelnen Stichprobe
= zeigt, mit welcher Wahrscheinlichkeit ein Ergebnis erwartet werden kann - 4Unterschiede der Stichprobenverteilung zur Häufigkeitsverteilung- Werte der Verteilung müssen nicht der Skala entsprechend (da sie Mittelwerte sind)
- Y-Achse: Anzahl der Stichproben / Wahrscheinlichkeit
- Werte in der Mitte kommen häufigst vor (da Mittelwerte der Studien), Randwerte eher selten - 5theoretische Stichprobenverteilung= Verteilung aufgrund Ergebnisse einer Stichprobe --> durch deren Kennwerte wird die Stichprobenverteilung am PC simuliert
- 6zentraler Grenzwert= Verteilung einer großen Anzahl von Stichproben folgt immer der Normalverteilung
- 7Vorteil von steigender StichprobengrößeStreuung der Stichprobenverteilung sinkt
- 8Kennwerte von Stichprobenergebnisse der Inferenzstatistik- Kennwerte der Lage und Streuung (Mittelwert)
- Kennwerte bzgl. Unterschied zwischen Gruppen (Mittelwertsunterschiede)
- Kennwerte, die Zusammenhang zwischen Variablen beschreiben (Korrelation) - 9Standardfehler s(e)= Standardfehler des Mittelwertes
= Standard-abweichung der Stichprobenverteilung
= durchschnittlicher Unterschied zwischen den geschätzten Mittelwert einzelner Stichproben und dem tatsächlichen Mittelwert - 10Populationsstreuung= Formel für SD in der Population
= exaktere Schätzung als mit der Formel für den Standardfehler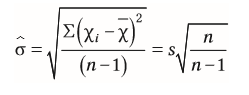
- 11Konfidenzintervalle / Vertrauensintervalle= Wertebereich, bei dem wir darauf vertrauen, dass sich der wahre Wert in der Population mit der Vertrauenswahrscheinlichkeit deckt
- 12Vertrauenswahrscheinlichkeit= gewünschte Güte des Intervalls
- 13Konstruktion des Konfidenzintervall1. Vertrauenswahrscheinlichkeit festlegen
2. Stichprobe und Mittelwert erheben
3. Stichprobenverteilung konstruieren
4. Fläche der Vertrauenswahrscheinlichkeit markieren
5. Werte die über und unter der Fläche von 4. werden abgeschnitten - 14Festlegung der Vertrauenswahrscheinlichkeit- Vertrauenswahrscheinlichkeit kann beliebig festgelegt werden, sollte aber nicht zu hoch sein, da sonst die Aussage ihren Wert verliert
Normal: 90, 95, selten 99 % - 15Vorteil des Konfidenzintervalls- Wahrscheinlichkeit der Güte einer Schätzung ist vorstellbar
Aber: nur Aussage über die Wahrscheinlichkeit der Korrektheit des Intervalls möglich - 16Alternative Möglichkeit zur Erstellung der Konfidenzintervalle- große Stichprobe (ab 30 P.): Standardnormalverteilung
- kleine Stichprobe: t-Verteilung - 17t-Verteilung- Mittelwert 0
- Streuung 1
- Form ist abhängig von der Stichprobengröße
- symmetrische Verteilung - 18Notwendige Werte für die t-Verteilung- Freiheitsgrade
- 19Freiheitsgrade (df)= Werte, die in einem statistischen Ausdruck frei variieren können
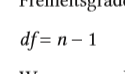
- 20Berechnung der oberen und unteren Grenze des Konfidenzintervalls mittels der t-Verteilung bei Mittelwerten
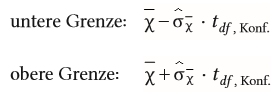
- 21Vorteil von größeren Stichproben bei Konfidenzintervallen- informativer Aussage, da die Grenzen des Intervalls näher zusammen rücken
- 22Standardfehler bei Anteilen1. Stichprobenverteilung bestimmen --> Binomialverteilung (bei zwei Ausprägungen)
2. Standardabweichung bestimmen (definiert durch n und Wahrscheinlichkeit p)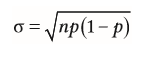
- 23Risiken bei Hypothesentesten- Verallgemeinerung auf die Population
- Effekte entstanden durch Zufall -> nicht übertragbar auf Population - 24vertrauensvolle Verallgemeinerung- Berechnung von Standardfehler
- Berechnung von Konfidenzintervallen
- Durchführung von Signifikanztests - 25Abhängige Messungen- Messwiederholungen: within-subject-design: Personen durchlaufen beide Tests
- gepaarte Stichproben: matching: Versuchsgruppen werden konstant gehalten, d.h. vergleichbare Personen in Gruppe 1 und 2 - 26unabhängige Messungen= jede Messung wird in jeweiliger Stichprobe vorgenommen
- Between-subject-Design: Teilnehmer werden randomisiert und so den verschiedenen Versuchsgruppen zugeordnet - 27Art der Messung bei Zusammenhangshypothesenabhängige Messung
--> es müssen beide Variablen an beiden Gruppen untersucht werden um Messwerte beiden Variablen zuordnen zu können und Streudiagramm erstellen zu können - 28Standardfehler - s(e) - bei Hypothesentesten (Zusammenhänge & Unterschiede)ist nicht alleine aussagekräftig!
Zusätzlich noch Konfidenzintervall und Signifikanztest
weil: es geht um Entscheidungen treffen, und da ist s(e) alleine nicht ausreichend - 29Standardfehler für Mittelwertsunterschiede bei unabhängigen Messungen= berechnet aus der Streuung der einzelnen Stichproben
Berücksichtigt werden muss die Streuung jeder Stichprobe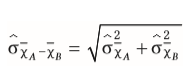
- 30Gesamtstreuung (Standardfehler für Mittelwertsunterschied bei unabhängigen Messungen)= Fehlerstreuung + systematische Streuung
- 31Fehlerstreuung (Standardfehler für Mittelwertsunterschied bei unabhängigen Messungen)= Streuung ohne erkennbaren / systematischen Grund, die die Messwerte variieren lässt --> schmälert Bedeutsamkeit des gefundenen Effekts (bei großer Fehlerstreuung kann Mittelwertsunterschied auch zufällig entstanden sein)
= Streuung innerhalb der Gruppe - 32systematische Streuung (Standardfehler für Mittelwertsunterschied bei unabhängigen Messungen)= Streuung zwischen den Gruppen
= ergibt sich durch den Mittelwertsunterschied
= interessanter Effekt - 33Standardfehler für Mittelwertsunterschiede bei abhängigen MessungenDifferenz der Messwerte relevant = Streuung innerhalb der Person --> Durchschnitt aller Differenzen über alle Personen hinaus
Differenz ist entscheidend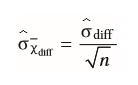
- 34Streuung der Differenz (Standardfehler für Mittelwertsunterschiede bei abhängigen Messungen)
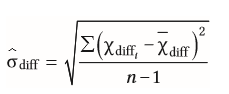
- 35Fehlerstreuung (Standardfehler für Mittelwertsunterschiede bei abhängigen Messungen)besteht nur in der Streuung der Differenz --> Differenzen sollten gleich groß und gleiche Richtung haben. wenn nicht: Vergrößerung der Fehlervarianz --> gefundener Effekt weniger bedeutsam
- 36Korrelationskoeffizient bei Zusammenhängebeschreibt die Enge des Zusammenhangs
(r = groß --> Streuung klein) - 37Standardfehler für Korrelationskoeffizient bei Zusammenhänger nahe 1 /-1 führt zu Standardfehler nahe 0
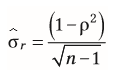
- 38Regressionsgewicht= beschreibt den relativen Einfluss einer Variable auf die andere
= beschreibt den Anstieg der Regressionsgeraden
aus einzelnem Regressionsgewicht kann nicht die Güte abgeleitet werden - 39Standardschätzfehler bei der Regressionwie stark streuen die Werte um die Regressionsgrade - beschreibt Ungenauigkeit wenn man Y-Werte aus X-Werte mithilfe der Regressiongeraden schätzt
= Gütemaß für die Vorhersage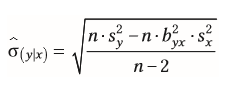
- 40Berechnung des Standardfehler aus dem Regressionskoeffizienten (also aus dem Standardschätzfehler)Bezeichnung: SE
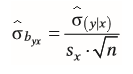
- 41Vorteile von Konfidenzintervalle- leicht verständliche Angabe, ob Effekt durch Zufall entstand oder statistischer Bedeutung hat
- 42Konfidenzintervalle für Mittelwertsunterschiede bei unabhängigen Stichproben- Verwendung der Stichprobenverteilung von Mittelwertsunterschieden oder die t-Verteilung
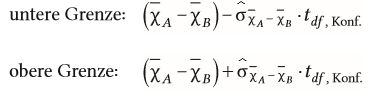
- 43Der Wert 0 beim Konfidenzintervall für Mittelwertsunterschiede bei unabhängigen Stichprobenes gibt keinen Mittelwertsunterschied in der Population --> Hypothese verwerfen
Gründe:
- zu hohe Vertrauenswahrscheinlichkeit
- Mittelwert nahe 0 (je kleiner der Effekt desto eher wird 0 Bestandteil des Konfidenzintervalls sein) - 44Konfidenzintervall für Mittelwertsunterschiede bei abhängigen StichprobenAndere Formel, gleiche Interpretation wie bei unabhängigen Stichproben
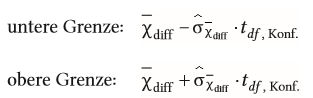
- 45Besonderheit des Korrelationskoeffizient bei Zusammenhänget-Verteilung ist nur symmetrisch, wenn r=0 --> r > 0 -> t-Verteilung unbrauchbar, da unsymmetrische Darstellung
--> Nutzung der z-Verteilung - 46Konfidenzintervalle für Korrelationskoeffizienten bei Zusammenhängewerden meist nicht berechnet, wenn über z-Verteilung
Ablauf: Korrelationskoeffizient in z-Wert umrechnen -> kritischer Wert für Intervallgrenzen ablesen --> Grenzen berechnen (siehe Formel) --> Umrechnung auf Korrelationskoeffizient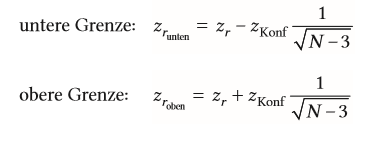
- 47Berechnung des Konfidenzintervall für Regressionsgewicht β bei unsymmetrischer Verteilung
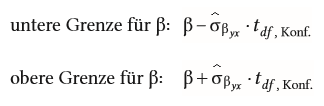
- 48SignifikanztestsEntscheidungshilfe bei Hypothesen
es werden Hypothesen gegeneinander getestet
lässt keine Aussage über Wahrscheinlichkeit einer Hypothese zu! - 49Grundlage der SignifikanztestsStichprobenverteilungen (Verteilungen, die aus theoretischen Überlegungen erwachsen)
- 50Nullhypothese (H0)= Forschungshypothese
= behauptet es gibt keinen Effekt in der Population
Gegenteil: Alternativhypothese (H1)
--> Achtung bei Berechnung und Interpretation - 51Stichprobenverteilung bei der NullhypotheseMittelwert = 0
- 52p-Wert= Wahrscheinlichkeit des gefundenen Effekts unter der Annahme dass die Nullhypothese gilt
- 53Irrtumswahrscheinlichkeit α / Signifikanzniveau / Alpha-Niveau= entspricht Wert bei p, ab dem man die Nullhypothese nicht mehr akzeptiert
- kleinere Werte = signifikant -> Ablehnung der Nullhypothese - 54Alpha-Fehler= legt das Niveau der Irrtumswahrscheinlichkeit fest
= Risiko die Nullhypothese fälschlicherweise abzulehnen
p < α Ergebnis ist signifikant = Ablehnung der Nullhypothese - 55"Entstehung" des p-Wertest-Werte der Stichprobe = Mittelwert = 0 --> entspricht Verteilung der Nullhypothese --> p-Wert aus Verteilung ablesen
- 56Prüfverteilungen- z-Verteilung (ist einzelner Wert signifikant)
- t-Verteilung (bei Mittelwertsunterschieden, Korrelationskoeffizienten und Regressionsgewichten) - 57einseitige Tests= Hypothese geht nur in eine Richtung - Effekt ist auf der rechten Seite der Nullhypothese zu finden
schließen Alpha-Fehler auf der linken Seite aus --> müssen keinen Signifikanztest machen, wenn Kontrollgruppe höhere Werte erzielt, da Hypothese bereits widerlegt ist - 58zweiseitige Tests= Richtung des Effekts ist unbekannt
- Effekt kann auf beiden Seiten der t-Verteilung liegen --> Alpha-Fehler muss auf beide Seiten gleich aufgeteilt werden, dadurch wird es schwerer ein signifikantes Ergebnis zu erzielen - 59Alternativhypothese= unterscheidet sich um die Größe des erwarteten Effekts von H0
- 60Verteilung der Alternativhypothesetheoretische Verteilung bestimmbar durch:
- Größe des interessanten Mindesteffekts
- Effekte aus bereits durchgeführten Studien
Überschneidung mit H0 - 61Fehler erster Art= Alpha-Fehler
Nullhypothese wird fälschlicherweise verworfen / in der Population gilt H0
Interessante Teil der Verteilung: rechter Überschneidungsbereich - 62Fehler zweiter Art= Beta-Fehler
Alternativhypothese wird fälschlicherweise abgelehnt / in der Population gilt H1
Interessante Teil der Verteilung: linker Überschneidungsbereich - 63Abwägung von Alpha- und Beta-FehlerAbhängig von der Fragestellung, relevant wenn Verteilungen sich stark überschneiden
- 64Minimierung der Alpha- und Beta-Fehler- Effekt in der Population ist groß
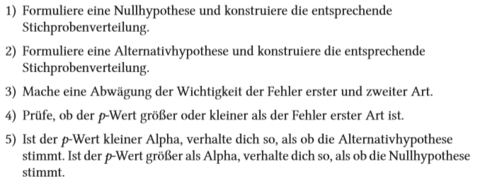
- größere Stichprobe -> Verteilung wird schmaler, geringe Überlappung - 65Ablauf der Signifikanztest unter Berücksichtigung der Alternativhypothese
- 66Hybrid-Vorgehensweise= Alternativhypothese und Abwägung der Fehler erster und zweiter Art wird nicht gemacht
wenn Ergebnis nicht signifikant -> H0 stimmt - 67Einflussgrößen auf Signifikanztests- Größe des Populationseffekts
- Stichprobengröße
- Alpha-Niveau - 68Kritik an Signifikanztests- die Größe eines Effektes in der Population kann nicht geschätzt werden --> inhaltliche Bedeutung ebenfalls nicht erkennbar
- - 69Zusätzlich notwendige Angaben zu Signifikanztests- Konfidenzintervalle
- Effektgrößen - 70Effektgröße= standardisierte Effekte, welche die Stichprobengröße berücksichtigen --> sind über Stichproben und Themenbereiche hinweg vergleichbar
- 71Möglichkeiten der Berechnung der Effektgrößen- aus Rohdaten
- aus anderen Effektgrößen
- aus Signifikanztestergebnissen - 72Effektgrößen aus Rohdaten- bei unabhängigen Messungen
- bei abhängigen Messungen
- für Zusammenhänge (Korrelationskoeffizient) - 73Abstandsmaß d (bei unabhängigen Messungen)repräsentieren den Abstand der Mittelwerte
--> Effektgröße erhöht sich, wenn Streuung kleiner wird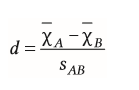
- 74Streuung für Abstandsmaß nach Cohens (bei unabhängigen Messungen)Stichproben-streuung
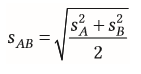
- 75Alternative zum Abstandsmaß (bei unabhängigen Messungen)= Hedges' (g) aus Populationsstreuung
liefert exaktere Schätzungen als d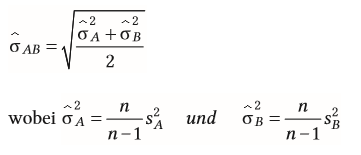
- 76Berechnung von Hedges bei unabhängigen MessungenPopulationsstreuung bestimmen
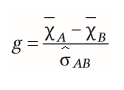
- 77Abstandsmaß d bei abhängigen Messungen
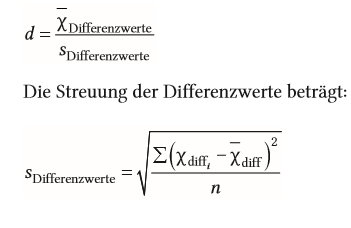
- 78Hedges g bei abhängigen Messungen
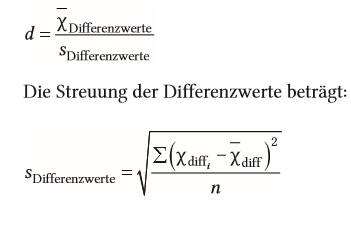
- 79Überführung Unterschieds- und Zusammenhangsfragen bei Effektgrößenn = ist Gesamtstichprobe
Freiheitsgrade = n - k (Anzahl der Gruppen)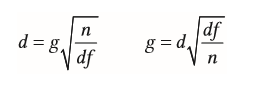
- 80Berechnung Korrelation aus Abstandsmaßennur bei gleicher Stichprobengröße
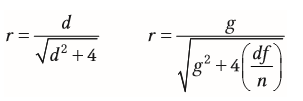
- 81Berechnung Abstandsmaße aus Korrelation
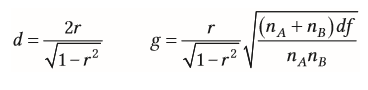
- 82Effektgröße aus SignifikanztestergebnissenSignifikanztestergebnis = Prüfgröße
Größe der Studie = mithilfe der Freiheitsgrade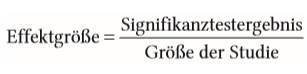
- 83Interpretation von Effektgrößen- Abhängig von der Fragestellung
- Anwendung von Konventionen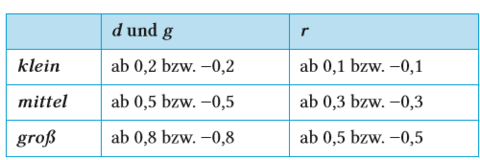
Informações
- Descrição
- FOST (FOST 1 -4) FlashCards sobre FOST 3 - Inferenzstatistik , criado por Kathy H em 09-08-2016.
- Criado por
- Kathy H
- Visualizações
- 311
- Tags
- Avaliação