
Mind map
Alpha INFORMÁTICA

Map content
Alpha INFORMÁTICA
SEGURANÇA DA INFORMAÇÃO
- PRINCÍPIOS
- DICANÃO
- sdfsfds
- DISPONIBILIDADE
- a informação estará sempre disponível quando solicitado.
- A relação da segurança da informação com a disponibilidade é basicamente a garantia de acesso aos dados sempre que necessário.
- INTEGRIDADE
- - Não alteração da mensagem. - Páginas enumeradas - Algoritmos Hash (MD5, * mais usado SHA)
- Exige que apenas pessoas autorizadas possam modificar dados. A modificação inclui escrever, alterar, mudar o estado, excluir e criar. Qualquer falha nesse quesito, gera a quebra da integridade.
- AUTENTICIDADE
- AUTENTICIDADE ESTA PARA A INFORMAÇÃO
- O princípio da autenticidade busca garantir que determinada pessoa ou sistema é, de fato, quem ela diz ser.
- autenticação
- AUTENTICAÇÃO PARA O USUÁRIO
- CONFIDENCIALIDADE
- GARANTE O SIGILO, SO PARA QUEM É DE DIREITO
- no contexto da segurança da informação, nada mais é do que a garantia de que determinada informação, fonte ou sistema é acessível apenas às pessoas previamente autorizadas a terem acesso. Ou seja, sempre que uma informação confidencial é acessada por um indivíduo não autorizado, intencionalmente ou não, ocorre o que se chama de quebra da confidencialidade. A ruptura desse sigilo, a depender do teor das informações, pode ocasionar danos inestimáveis para a empresa, seus clientes e até mesmo para todo o mercado. A exemplo, instituições financeiras, detentoras de dados pessoais e bancários de uma infinidade de usuários, não só precisam, mas devem manter a confidencialidade de todas as informações em seu domínio. A quebra desse sigilo significaria expor a riscos uma grande quantidade de pessoas, causando prejuízos incalculáveis.
- NÃO REPUDIO IRRETRABILIDADE
- Não pode negar a sua autoria, pois apenas ele detém a a chave privada que poderia gerar a informação
- garantia que o emissor de uma mensagem ou a pessoa que executou determinada transação de forma eletrônica, não poderá posteriormente negar sua autoria, visto que somente aquela chave privada poderia ter gerado aquela assinatura digital.
- DICANÃO
- PROTEÇÃO
- CRIPTOGRAFIA
- Ciência que estuda princípios, meios e métodos para tornar as mensagens ininteligíveis (cifragem), inteligíveis ( decifragem)
- criptografia oculta o significado
- esteganografia oculta a existência da mensagem
- SIMÉTRICA
- Os dois precisam ter a mesma chave
- Algoritmos de cifragem em bloco DES AES
- mais rápido
- A função essencial da criptografia é a garantia de confidencialidade ou de sigilo da informação, em que há a proteção dos dados contra divulgação não autorizada. Nesse caso, um esquema de criptografia simétrica possui cinco itens: 1) Texto claro: É a mensagem ou os dados originais inseridos como entrada do algoritmo. 2) Algoritmo de criptografia: O algoritmo de criptografia realiza várias substituições e transformações no texto claro. 3) Chave secreta:A chave secreta também é a entrada para o algoritmo de criptografia. As substituições e transformações exatas realizadas pelo algoritmo dependem da chave. 4) Texto codificado: É a mensagem em códigos produzida como saída. Ela depende do texto claro e da chave secreta. Para determinada mensagem, duas chaves diferentes produzirão dois textos codificados diferentes. 5) Algoritmo de decriptografia: É basicamente o algoritmo de criptografia executado ao contrário. Ele torna o texto codificado e a chave secreta e produz o texto claro original
- ASSIMÉTRICA
- par de chaves para troca de mensagem.
- mais demorada
- C. S. A
- ANTIMALWARE ANTIVÍRUS
- Os programas antimalware, muitas vezes chamados de programas antivírus, são ferramentas desenvolvidas com o objetivo de detectar, identificar e remover códigos maliciosos do sistema.
- ESTÁTICA
- HÍBRIDA
- DINÂMICA
- analise de código malicioso realizada pelo perito por meio da execução do código suspeito em ambiente de sandbox e de sua observação e a analise
- DETECÇÃO
- HEURÍSTICA
- baseia-se nas estruturas, instruções e características que o código malicioso possui.
- ASSINATURA
- a assinatura de um código malicioso corresponde a características específicas nele contidas e que permitem que seja identificado unicamente. Um arquivo de assinaturas corresponde ao conjunto de assinaturas definidas pelo fabricante para os códigos maliciosos já detectados.
- COMPORTAMENTO
- baseia-se no comportamento apresentado pelo código malicioso quando executado
- HEURÍSTICA
- GERAÇÃO
- 1ª
- escaneadores simples - um escaneador de primeira geração requer uma assinatura do código malicioso para identificar o malware
- 2ª
- escaneadores heurísticos - um escaneador de segunda geração não depende de uma assinatura específica. Em vez disso, ele usa regras heurísticas para procurar prováveis instâncias de um malware.
- 3ª
- detecção baseada na atividade - são programas residentes na memória que identificam malwares por suas ações, em vez de sua estrutura em um programa infectado. Tais programas têm a vantagem de que não é necessário desenvolver assinaturas e heurísticas para uma grande coleção de malwares. Em vez disso, basta identificar o pequeno conjunto de ações que indica que uma tentativa de atividade maliciosa está em curso e intervir
- 4ª
- proteção total - são pacotes que consistem em uma variedade de técnicas antivírus usadas em conjunto. Eles incluem componentes de escaneamento e de captura de atividades. Além disso, esses pacotes incluem recursos de controle de acesso, o que limita a capacidade do malware de penetrar em um sistema e, assim, limita a capacidade de um malware atualizar arquivos para se propagar
- NGAV
- NGAV (Next Generation Antivirus) - são soluções que utilizam uma combinação de inteligência artificial, detecção comportamental e análise preditiva baseada em aprendizado de máquina para antecipar e prevenir ameaças conhecidas e desconhecidas.
- 1ª
- mac
- (3.2) IMPORTANTE – Vários algoritmos podem ser usados para gerar o código, por exemplo, o DES. Em geral, utiliza-se um código de 16 ou 32 bits
- CÓDIGO DE AUTENTICAÇÃO Remetente - Quando vai enviar uma mensagem utiliza-se uma chave secreta para gerar um pequeno bloco de dados. Destinatário usar a mesma chave secreta para fazer o mesmo cálculo, se der valor igual, o receptor tem que a garantia que a mensagem não foi alterada e pertence ao emissor.
- Hash
- Algoritmos utilizam a informação para gerar uma sequencia de bits menor (resultado Hash), o destinatário utiliza a mensagem recebida para rodar os mesmos algoritmos, se as sequências de bits forem as mesmas, terá a garantia que a mensagem tem integralidade e pertence ao emissor.
- Resistência à colisão difícil encontrar duas mensagens com o mesmo reusultado.
- - Verificar integridade dos seus arquivos, backups, em dados obtidos em sites que disponibilizam o hash. - Gerar assinaturas digitais
- FIREWALL
- Um firewall é um dispositivo de segurança que monitora o tráfego de rede de entrada e saída, permitindo que alguns pacotes passem e bloqueando outros de acordo com um conjunto definido de regras de segurança, isto é, todo o tráfego de fora para dentro, e vice-versa, passa por um firewall. Dessa forma, é possível isolar uma rede interna de uma organização da Internet em geral. Um firewall pode ser um hardware, software ou ambos.
- FILTRO DE PACOTE TRADICIONAL (STATELLES SEM ESTADO)
- - stateless firewall (firewall sem estado) - examina cada datagrama de forma isolada - determinando se deve passar ou ficar baseado nas regras específicas definidas pelo administrador da rede - As decisões de filtragem costumam ser baseadas em * Endereço IP de origem e de destino * Regras diferentes para datagramas que entram e saem da rede * Porta TCP ou UDP de origem e de destino
- Os filtros de pacotes tradicionais também são chamados de stateless firewall (firewall sem estado). Esse tipo de firewall examina cada datagrama de forma isolada, determinando se deve passar ou ficar baseado nas regras específicas definidas pelo administrador da rede. As decisões de filtragem costumam ser baseadas em: • Endereço IP de origem e de destino • Porta TCP ou UDP de origem e de destino • Regras diferentes para datagramas que entram e saem da rede
- ATUA NA CAMADA DE REDE E TRANSPORTE
- FILTRO DE PACOTE COM CONTROLE DE ESTADO (STATEFUL INSPECTION)
- Um firewall com inspeção de estado permite ou bloqueia tráfego de acordo com o estado, a porta e o protocolo. Ele monitora toda atividade desde o momento em que uma conexão é aberta até que ela seja fechada. As decisões de filtragem são tomadas de acordo com as regras definidas pelo administrador e com o contexto, o que significa o uso de informações de conexões e pacotes anteriores que pertencem à mesma conexão.
- ATUA NA CAMADA DE REDE E TRANSPORTE
- FIREWALL DE PROXY
- Um firewall de proxy é um sistema de segurança de redes que protege uma rede filtrando mensagens na camada de aplicação. Nesse caso, funciona como a passagem de uma rede para outra de uma aplicação específica. Servidores proxy podem oferecer recursos adicionais, como armazenamento em cache e segurança de conteúdo ao evitar conexões diretas de fora da rede. No entanto, isso também pode afetar a capacidade de taxa de transferência e as aplicações que eles podem comportar.
- ATUA ATÉ NA CAMADA DE APLICAÇÃO
- UTM (Unified Threat Management)
- GERENCIAMENTO UNIFICADO DE AMEAÇAS O gerenciamento unificado de ameaças, normalmente abreviado como UTM (Unified Threat Management), é um termo de segurança de informações que se refere a uma única solução de segurança, e normalmente um único dispositivo, que oferece várias funções de segurança em um único ponto da rede. Normalmente, um dispositivo de UTM inclui funções como: antivírus, antispyware, antispam, firewall de rede, detecção e prevenção de invasões, filtragem de conteúdo e prevenção de vazamentos.
- IDS
- IDS - Sistema de detecção de intrusão: ferramenta (hardware ou software) para monitorar o tráfego da rede, detectar e alertar sobre possíveis ataques e tentativas de acessos indevidos.
- IPS
- IPS - Sistema de prevenção de intrusão: ferramenta (hardware ou software) para monitorar o tráfego da rede, detectar possíveis tentativas de acessos indevidos e ataques. Além de enviar um alerta ao administrador, também pode derrubar pacotes maliciosos, bloquear o tráfego a partir da origem e redefinir a conexão.
- NGFW
- FIREWALL DE PRÓXIMA GERAÇÃO (NGFW) Os firewalls evoluíram para além da simples filtragem de pacotes e inspeção stateful. A maioria das empresas está implantando firewall de próxima geração para bloquear ameaças modernas, como malware avançado e ataques na camada da aplicação. Seu diferencial é trazer uma inspeção mais aprofundada de pacotes, com recursos de controle robustos e focados em uma performance mais coesa. Assim, o NGFW engloba não apenas a barreira contra ataques, mas cria políticas de controle de acesso eficientes e assertivas para os atuais desafios da segurança digital. De acordo com a definição do Gartner, Inc., um firewall de próxima geração deve incluir: ͫ Recursos padrão de firewall, como inspeção stateful ͫ Prevenção de invasão integrada ͫ Reconhecimento e controle da aplicação para detectar e bloquear aplicativos nocivos ͫ Atualização de caminhos para incluir feeds futuros de informação ͫ Técnicas para lidar com as ameaças à segurança em evolução
- BACKUP
- ARQUIVOS
- Essa abordagem faz backup de dados comuns somente ao criar uma segunda cópia em um segundo local, mas não faz backup de aplicativos ou outros arquivos de sistema. Os arquivos que são armazenados em backup não são excluídos da mídia origem.
- IMAGEM
- Essa é uma maneira de fazer backup de um computador (arquivos, aplicativos e arquivos de sistema) que permite armazenar a coleção inteira de dados disponíveis do computador, incluindo arquivos de programa e sistema operacional, em um só arquivo (uma “imagem”) que pode ser usado mais tarde para restaurar o computador exatamente da forma que era quando a imagem foi feita originalmente. Esse é um bom jeito de se recuperar de uma grande falha de hardware ou de reinstalar o sistema operacional sem ter que perder muito tempo também reinstalando programas, restaurando e-mails e arquivos.
- ARQUIVAMENTO
- NÃO É BACKUP
- LOCAL
- - Local - Remoto - nuvem
- INTEGRIDADE
- É possível detectar alterações em arquivos armazenados em uma mídia, com uso da função HASH. Nesse caso, Hash é o resultado único e de tamanho fixo gerado quando uma função de resumo (tipo de método criptográfico) é aplicada sobre uma informação. Funciona assim: aplique a função hash sobre o arquivo original e, se necessário, aplique novamente a função hash sobre o arquivo que representa uma cópia do original. Dessa forma, se os dois hashes forem iguais então você pode concluir que o arquivo representa uma cópia fiel do original, caso contrário, é uma indicação de que o arquivo esteja corrompido ou que foi modificado. Exemplos de métodos de hash são: MD5 (128 bits), SHA-1 (160 bits), SHA-256 e SHA-512.
- REGRA DO 3-2-1
- A estratégia de backup, conhecida como “regra de backup 3-2-1”, pode ajudar a salvar seus dados em caso de desastres, erros humanos ou ações de intrusos, como, por exemplo, ataques de ransomwares, cada vez mais comuns. A regra afirma que você precisa: Ter pelo menos 3 cópias dos dados (a original e 2 backups); Armazenar as cópias em 2 tipos diferentes de mídias; Pelo menos uma cópia de dados deve ser colocada fora do centro de dados primário ou do escritório, evitando assim desastres como incêndio, inundações ou outras circunstâncias de força maior. Com a nuvem temos soluções de armazenamento geo-redundantes mais baratas e eficientes.
- ATRIBUTO ARQUIVO (flag arquive)
- Para controlar se um determinado arquivo está com sua cópia de segurança desatualizada ou não, os programas de backup utilizam um atributo dos arquivos chamado atributo arquivo (flag arquive). Quando ele está marcado é indicativo de que o arquivo ou nunca foi copiado ou foi alterado desde o último backup. Quando estiver desmarcado é sinal de que ele está com sua cópia de segurança atualizada. O programa de backup desmarca automaticamente esse atributo ao final da execução de uma cópia (dependendo do tipo de backup). Depois disso, qualquer alteração que você promova neste arquivo o atributo voltará a ficar marcado, também automaticamente.
- backup normal
- 2.1 Backup normal (completo, total, global ou full) Tipo de backup que copia todos os arquivos selecionados e marca cada arquivo como tendo sofrido backup (em outras palavras, o atributo de arquivamento é desmarcado). Com backups normais, você só precisa da cópia mais recente do backup para restaurar todos os arquivos
- backup cópia
- 2.2 Backup cópia Tipo de backup que copia todos os arquivos selecionados, mas não marca cada arquivo como tendo sofrido backup (em outras palavras, o atributo de arquivamento não é desmarcado).
- backup incremental
- 2.3 Backup incremental Tipo de backup que copia somente os arquivos criados ou alterados desde o último backup normal ou incremental. Os arquivos que sofreram backup são marcados como tal (ou seja, o atributo de arquivamento é desmarcado)
- backup diário
- 2.5 Backup diário Tipo de backup que copia todos os arquivos selecionados que forem alterados no dia de execução do backup diário. Os arquivos que sofreram backup não são marcados como tal (ou seja, o atributo de arquivamento não é desmarcado).
- quente
- Backup quente O backup quente, também chamado de backup on-line ou backup dinâmico, é um backup realizado enquanto o banco de dados está operacional e acessível aos usuários. A maior vantagem do backup quente é a continuidade dos negócios, ou seja, quando um backup quente está sendo processado, você pode continuar trabalhando normalmente, já que seu banco de dados ainda está disponível.
- frio
- 3.2 Backup frio O backup frio, geralmente conhecido como backup offline ou backup estático, é uma espécie de serviço de backup que exige que todo o sistema de dados esteja completamente desligado. Nenhum negócio pode ser feito durante o backup frio. Assim, geralmente é realizado no início ou no final do dia para manter a continuidade dos negócios.
- ARQUIVOS
- CRIPTOGRAFIA
- CERTIFICADO DIGITAL ( RAIZ ÚNICA )
- (ICP) INFRAESTRUTURA DE CHAVES PÚBLICAS BRASILEIRAS
- DADOS BÁSICOS QUE COMPÕES UM CERTIFICADO DIGITAL
- - versão e número de série do certificado; - dados que identificam a AC que emitiu o certificado; - dados que identificam o dono do certificado (para quem ele foi emitido); - chave pública do dono do certificado; - validade do certificado (quando foi emitido e até quando é válido); - assinatura digital da AC emissora e dados para verificação da assinatura;
- GARANTIA
- - Validade jurídica - Autenticidade - Confiabilidade - Integridade -Não repúdio
- USOS
- - ASSINATURAS DE DOCUMENTOS E CONTRATOS DIGITAIS
- - AUTENTICAÇÃO EM SISTEMAS
- - ATUALIZAÇÃO DE INFORMAÇÕES EM SISTEMAS
- CATEGORIAS PROFISSIONAIS
- ICP BRASIL
- INFRAESTRUTURA DE CHAVES PÚBLICAS BRASILEIRA
- CADEIA HIERÁRQUICA QUE VIABILIZA A EMISSÃO DE CERTIFICADOS PARA IDENTIFICAÇÃO VIRTUAL DO CIDADÃO
- RAIZ ÚNICA ( ITI )
- Observa-se que o modelo adotado pelo Brasil foi o de certificação com raiz única, sendo que o ITI (Instituto nacional de tecnologia da informação), além de desempenhar o papel de Autoridade Certificadora Raiz – AC-Raiz, também tem o papel de credenciar e descredenciar os demais participantes da cadeia, supervisionar e fazer auditoria dos processos.
- CREDENCIA DESCREDENCIA AUDITA ESUPERVISIONA
- AC RAIZ
- - EMITE - EXPEDE - DISTRIBUI -REVOGA - GERENCIA OS CERTIFICADOS DAS AUTORIDADES CERTIFICADORAS
- - EMITE A LISTA DE CERTIFICADOS REVOGADOS - LCR
- FISCALIZA E AUDITA AS -AC -AR -DEMAIS
- AC
- - pública ou privada, subordinada à hierarquia da ICP-Brasil - responsável por emitir, distribuir, renovar, revogar e gerenciar certificados digitais. - tem a responsabilidade de verificar se o titular do certificado possui a chave privada que corresponde à chave pública que faz parte do certificado. - Cria e assina digitalmente o certificado do assinante, onde o certificado emitido pela AC representa a declaração da identidade do titular, que possui um par único de chaves (pública/privada).- Cabe também à AC emitir Listas de Certificados Revogados – LCR e manter registros desuas operações sempre obedecendo às práticas definidas na Declaração de Práticas deCertificação – DPC. -Estabelecer e fazer cumprir, pelas Autoridades de Registro – ARs a ela vinculadas, as políticas de segurança necessárias para garantir a autenticidade da identificação realizada.
- AR
- - RESPONSÁVEL PELO REGISTRO ENTRE USUÁRIO E A AC. - OBJETIVO O RECEBIMENTO, A VALIDAÇÃO, O ENCAMINHAMENTO DE SOLICITAÇÕES DE EMISSÃO OU REVOGAÇÃO DE CERTIFICADOS DIGITAIS E IDENTIFICAÇÃO, DE FORMA PRESENCIAL, DE SEUS SOLICITANTES. - É RESPONSABILIDADE AR MANTER REGISTROS DE SUAS OPERAÇÕES. - PODE ESTAR LOCALIZADA EM UMA AC OU REMOTAMENTE.
- ONDE ARMAZENAR
- CERTIFICADO A1 (COMPUTADOR OU DISPOSITIVO MÓVEL, VALIDADE DE 1 ANO)
- CERTIFICADO A3 (MÍDIA CRIPTOGRÁFICA, VALIDADE DE 1 A 5 ANOS)
- AUTENTICAÇÃO DE MENSAGEM
- A criptografia protege contra ataques passivos (espionagem). Uma necessidade diferente é proteger contra ataques ativos (falsificação de dados e transações). A proteção contra esses ataques é conhecida como autenticação de mensagem.
- MÉTODOS
- - conteúdo da mensagem não foi alterado e se a origem é autêntica.
- AUTENTICAÇÃO MEDIANTE CRIPTOGRAFIA SIMÉTRICA
- É possível realizar autenticação simplesmente pelo uso da criptografia simétrica.
- ASSINATURA DIGITAL
- Comprova que quem assinou esta de acordo
- a mesma validade de uma assinatura feita de punho
- A verificação é feita com uma chave pública correspondente, pois a codificação é feita com uma chave privada
- Para contornar a baixa eficiência característica de chave assimétrica, a codificação é feita com hash, que possui tamanho reduzido
- Não fornece confidencialidade, nem disponibilidade
- CÓDIGOS MALICIOSOS
- MALWARE (3.5)
- bot
- - Bot é um programa que dispõe de mecanismos de comunicação com o invasor que permitem que ele seja controlado remotamente.
- zombie computer
- Capaz de se propagar automaticamente
- Possui um processo similar de infecção ao do worm
- botnet
- Botnet é uma rede formada por centenas ou milhares de computadores zumbis e que permite potencializar as ações danosas executadas pelos bots.
- Ex.: Ataque a servidores, derrubando-os
- Sigla: Ataque de negação de serviços distribuídos (DDOS)
- SPYWARE
- é um programa projeto para monitorar atividades de um sistema e enviar as informações coletadas a terceiros, ou seja, um software espião. Nem sempre é utilizado de forma maliciosa.
- Pode espionar para fazer o bem.
- Vender os cliques que o usuário faz nessas páginas
- Redirecionam toda página visitada para uma outra página
- vende para pessoas as informações que você mais visualiza e clica.
- ransoware
- Projetado para tornar inacessíveis dados armazenados em um equipamento, ou seja, é um sequestro de dados ->
- Cobrança de resgate
- ROOTKIT
- Rootkit é um conjunto de programas e técnicas que permite esconder e assegurar a presença de um invasor ou de outro código malicioso em um computador comprometido.
- Rootkits com estratégias de kernel podem, portanto, fazer quase tudo na memória de trabalho. O propósito dessas ferramentas é ler, alterar ou influenciar os processos em execução, dados ou arquivos do sistema. Um rootkit ajuda o invasor a ganhar acesso ao sistema, sem o usuário perceber nada.
- O conjunto de programas e técnicas fornecido pelos rootkits pode ser usado para: • remover evidências em arquivos de logs; • instalar outros códigos maliciosos, como backdoors, para assegurar o acesso futuro ao computador infectado; • esconder atividades e informações, como arquivos, diretórios, processos, chaves de registro, conexões de rede etc.; • mapear potenciais vulnerabilidades em outros computadores, por meio de varreduras na rede; • capturar informações da rede onde o computador comprometido está localizado, pela interceptação de tráfego
- DIFERENÇA
- Todo vírus é malware. Malware é uma categoria que engloba, além dele, outros códigos maliciosos.
- VÍRUS
- pequeno programa de computador que propositalmente se replica, algumas vezes de forma alterada. Ele precisa de um hospedeiro/portador. O arquivo hospedeiro necessita ser executado, geralmente, pelo próprio usuário.
- PARTES DE UM VÍRUS
- (1/3) MECANISMO DE INFECÇÃO
- (2/3) MECANISMO DE ATIVAÇÃO - evento ou condição que determina quanto a carga útil será ativada!)
- (3/3) CARGA ÚTIL: Geralmente destrutível
- TIPOS
- script
- - Recebido ao acessar uma página de internet
- - Pode autoexecutável
- - Também pode fazer parte do corpo de e-mail.
- macro
- Escrito em linguagem de macro, ele infecta arquivos manipulados por aplicativos que utilizem linguagem.
- Excel, Power point, Word ...
- boot
- Ataca a inicialização do sistema
- camuflado (stealth)
- Fica camuflado no sistema
- Polimórfico
- Muda de assinatura a cada nova infecção
- metamórfico
- Muda a assinatura a cada nova infecção, rescrevendo o seu comportamento e aparência.
- worm
- é um pequeno programa de computador que propositalmente se replica, mandando cópias de si mesmo sem precisar de hospedeiro ou de execução por parte do usuário (normalmente)
- propagação
- Identificação dos computadores
- Envio das cópias
- Ativação das cópias
- Reinicio do processo ( o computador passa a ser originador de ataques )
- script
- TROJAN
- É um exemplo de malware, para a banca é um vírus.
- Eles é um programa que executa atividades maliciosas além das quais ele foi projetado, sem o conhecimento do usuário.
- Geralmente é a instalação de códigos maliciosos ou execução de funções maliciosas.
- spam
- são e-mails indesejáveis que poder estar sendo utilizador por um atacante de botnet.
- hoax
- são boatos, exemplo, corrente de e-mail para o envia ao maior número de pessoas
- backdoor
- é um programa de computador que permite o retorno de um invasor a um computador comprometido.
- Ele cria/abre portas que permite a entrada do invasor
- spoofing
- falsificação de e-mail, ou e-mail spoofing, é uma técnica que consiste em alterar campos de cabeçalho de um e-mail, de forma a aparentar que ele foi enviado de uma determinada origem quando, na verdade, foi enviado de outra.
- sniffing
- é uma técnica que consiste em inspecionar os dados trafegados em redes de computadores, por meio de uso de programas específicos chamados sniffers
- Interceptação de tráfego
- farejador
- LEGÍTIMO : por administradores de redes, para detectar problemas, analisar desempenhos e monitorar atividades maliciosas relativas aos computadores ou redes por ele administradas.
- MALICIOSA: utilizada por atacantes para capturar informações sensíveis, como senhas, números de cartões de crédito e o conteúdo de arquivos confidenciais que estejam trafegando por meio de conexões inseguras, ou seja, sem criptografia.
- phishing
- uma forma de fraude na internet na qual a vitima recebe um e-mail pedindo para ele ou ela verificar ou confirmar uma conta junto ou provedor de serviços (em massa)
- spear phishing
- Técnica maliciosa utilizada por criminoso para obter dados pessoas ( engenharia social )
- Golpe proveniente de e-mail ou comunicação eletrônica, direcionada a um indivíduo, organização ou empresas específicas
- pharming
- direciona o usuário alterando o DNS, levando-o para sites falsos.
- defacement
- DESCONFIGURAÇÃO DE PÁGINA : é uma técnica que consiste em alterar o conteúdo da página WEB de um site (pichação)
- brute force
- consiste em adivinhar por tentativa e erro, um nome de usuário e senha, assim, executar processos e executar sites, computadores e serviços em nome e com os mesmo privilégios do usuário.
- Em média, metade de todas as chaves precisa ser testadas para funcionar
- bot
- ATIVO
- qualquer coisa que tenha valor para uma organização
- AMEAÇA
- causa potencial de um acidente indesejado que pode causar dano a um sistema ou organização.
- ATAQUE
- Tentativa de destruir, expor, alterar, inutilizar, roubar ou obter acesso não autorizado a um ativo
- VULNERABILIDADE
- Fraqueza de um ativo ou um grupo de ativos que pode ser explorada por uma ou mais ameaças
- MALWARE (3.5)
- varreduras em redes (scan)
- é uma técnica que consiste em buscas minuciosas em redes, com o objetivo de identificar computadores ativos e coletar informações sobre eles, como serviços disponibilizados e programas instalados
- legítima: Por pessoas devidamente autorizadas, para verificar a segurança de computadores e redes e, assim, tomar medidas corretivas e preventivas
- MALICIOSAS: pro atacantes, para encontrar vulnerabilidades nos serviços disponibilizados e nos programas instalados para a execução de atividades maliciosas.
- PRINCÍPIOS
SISTEMAS OPERACIONAIS
- CLASSIFICAÇÃO DO SOFTWARE
- FREE SOFTWARE
- - LINUX - NÃO É QUESTÃO DE PREÇO -LIBRE OFFICE -FIREFOX
- LINUX
- o primário não possuía ambiente gráfico
- 4 LIBERDADES
- 0 - Executar o programa como desejar (empresa ou pessoal)
- 1 - Funcionamento e adaptação > Requisito código fonte (executável é diferente de modificável)
- 2 - Redistribuir cópias (pode $ para redistribuir)
- 3 - Redistribuir cópias modificadas > Requisito: acesso código fonte.
- DIRETÓRIOS
- / pasta / subpasta
- /
- RAIZ
- /bin
- - armazena os comandos essenciais para o funcionamento do sistema
- - Binários ou executáveis - Diretório público
- /sbin
- Administradores do sistema Usuário ROOT
- - Manutenção
- /boot
- arquivos de inicialização
- /dev
- - armazenamento de arquivos de dispositivos (Hardware)
- /etc
- armazena arquivos de configuração
- /tmp
- armazena arquivos temporários
- /home
- armazena arquivos pessoais (exceto super usuário)
- /root
- diretório home do super usuário
- FREE SOFTWARE
- Não necessariamente é gratuito
- Freeware é soft livre de pagamentos
- DISTRIBUIÇÕES
- Debian CentOS Ubuntu (MAIS COBRADO) Manjaro linux Fedora Linux Mint
- KERNEL + MODIFICAÇÕES = DISTRIBUIÇÕES
- AMBIENTES GRÁFICOS
- KDE Unity ( mais cobrado) CfceL xde Cinnamon Gnome (mais cobrado)
- KERNEL
- - GNU LINUX - 1983/84 = GNU - 1991 = KERNEL LINUX - Terminal = Shell
- TERMINAL
- LINHA DE COMANDO (PROMPT SHELL) $ Usuário comum # usuário root
- COMANDOS BASICOS
- - LINUX -> case sensitive
- pwd
- mostra o diretório atual por extenso
- cd
- -muda o diretório - entra em outro diretório - sai do diretório
- cd.. referência diretório anterior
- /cd ou /cd ~ vai para o diretório pessoal
- cd / vai para o diretório raiz
- ls
- ls ( lista arquivos e diretórios dentro do local atual)
- ls-a (lista tudo, visível e oculto)
- ls -l (lista arquivos + detalhes)
- ls - la (lista arquivos ocultos e com seus detalhes)
- cp
- copiar arquivos cp nome do arquivo nome do diretório -> unico arquivo
- cp - r (copiar recursivamente -> copia diretório e arquivos que estiverem dentro)
- mv
- RENOMEAR mv nome do arquivo nome novo
- MOVER mv nome do arquivo nome diret.
- rm
- remover/excluir arquivo rm nome do arquivo
- rm -r nome do diretório Exclui diretório e tudo que está dentro dele
- mkdir
- comandos para criar diretórios
- rmdir
- comando utilizado para apagar diretórios vazios.
- touch
- comando para criar arquivos vazios
- shutdown
- shutdown - h + 15 deliga o PC em 15 minutos
- shutdown -r now reinicia o pc
- shutdown -c (cancela o desligar)
- passwd
- comando para alterar a senha do usuário
- sudo
- permite que usuários sem acesso root executem comandos que normalmente precisariam de privilégios de super usuário, necessita de uma senha específica.
- --- enquanto o arquivo sudoers dá instruções para o sistema sobre como lidar com o comando sudo
- chmod
- chmod
- top
- = Gerenciador de tarefas do Windows - exibe informações sobre o computador+ uso de processamento+ memória utilizada (total por processo)
- kill
- Encerra um processo - id específico = pid ( mostrar : comando ) Kill nº do processo
- 4 LIBERDADES
- 0 - Executar o programa como desejar (empresa ou pessoal)
- 1 - Funcionamento e adaptação pode alterar o funcionamento e fazer adaptações (requisito: acesso ao código fonte) ( executável diferente de modificável )
- 2 - pode redistribuir cópias ( vender )
- 3 - redistribuir cópias modificadas, pedir código fonte.
- SOFTWARE PROPRIETÁRIO
- Usuário não tem acesso ao código fotne
- gratuito ou não
- Restrição: - reprodução - distribuição - uso
- WINDOWS
- $
- Características em comum 4M
- - Multitarefas ou Multiprogramáveis - Multiusuários - Multiprocessável ( + de um processador na placa mãe) - Monolítico (MONOBLOCO)
- menu iniciar
- WIN + i Iniciar -> configuração -> personalização -> Iniciar
- barra de tarefa
- Iniciar -> Configuração -> Personalização -> barra de tarefas
- área de notificação
- RELÓGIO CALENDÁRIO ÍCONES
- PODEMOS OCULTAR OU MOSTRAR MAIS
- central de ações
- - win + a - HÁ UMA PRÉ SELEÇÃO DOS ÍCONES QUE PODEM APARECER
- INICIAR -> CONFIGURAÇÕES -> SISTEMA -> NOTIFICAÇÕES E AÇÕES ( ADICIONAR, REMOVER, REORGANIZAR)
- modo tablete
- AÇÕES RÁPIDAS SEM T E M NÃO TEM WIND + D
- windows hello
- biometria - impressão digital Identificação do rosto do usuário
- Iniciar -> Configuração -> Contas -> Opções de entrada
- DRIVE E DRIVER
- DISPOSITIVO SOFTWARE
- shell
- INTÉRPRETE ENTRE O USUÁRIO E O SOLFTWARE
- LINHA DE COMANDO OU GRÁFICO
- kernel
- NÚCLEO DO S.O CONTROLA O HARDWARE
- SOFTWARE
- CONJUNTO DE PROGRAMAS QUE CONTROLA O HARDWARE
- Sistema operacional
- +1
- Basta particionar o HD e instalar outro S.O C: Windows D: Linux
- Dual Boot
- - Grub - Lilo
- Ao ligar perguntará
- desempenho
- Não altera
- Máquina Virtual
- - Virtual Box - Pode afetar o desempenho(memória e o processador)
- +1
- Menu Iniciar
- Padrão: Windows 7, W10 Tela Inteira: W8, também W10
- iniciar -> configurar -> personalização -> iniciar
- win + i
- barra de tarefas
- iniciar -> configurações -> personalização -> barra de tarefa
- área de trabalho virtual
- criar
- win + ctrl + d
- deletar
- win + ctrl + f4
- mudar
- win + ctrl + <- setas ->
- criar
- histórico de atividade
- - até 30 dias -local ou na nuvem
- iniciar -> configurações -> privacidade -> histórico e atividade (limpar, desabilitar função que windows colete atividade do usuário)
- multitarefas
- Alternar entre as tarefas alt + tab
- Iniciar -> configuração -> sistema -> multitarefas
- Arrastar as janelas para o lado, para cima, para os cantos
- off
- hibernar
- salva o estado do computador no disco rígido Computador desliga
- desligar
- não salva o estado do computador. Computador desliga
- suspender
- Aplicativos ficam abertos, mas nada é salvo Não desliga
- hibernar
- cortana
- Assistente digital igual ao ECO WIN + C Se estiver habilitada
- Cortana -> Configurações -> permissões 2023
- WINDOWS DEFENDER
- W 7
- Antispyware
- W 8
- antispyware + Antivírus (Windows defender + firewall recursos separados)
- W 10
- antispaware + antivírus windows defender incluso firewall
- Firewall protege contra acessos não autorizados
- W 7
- opções da família
- controle dos pais
- EXPLORADOR DE ARQUIVOS
- wind+ E
- - acesso rápido: lista dos arquivos (usados com frequência, recentemente) (pastas/arquivos fixados
- Para retirar do acesso rápido: Guia exibir-> Opções -> Privacidade: desmarcar as caixas de seleção
- ARRASTAR E SOLTAR
- OUTRA UNIDADE
- MOVER
- SHIFT + ARRASTAR
- COPIAR
- ARRASTAR
- MOVER
- MESMA UNIDADE
- MOVE
- MOVER
- APENAS ARRASTAR
- COPIAR
- CTRL + ARRASTAR
- OUTRA UNIDADE
- COMPUTADOR
- - VERSÕES ANTERIORES W10 MEU COMPUTADOR - A PARTIR W10 ESTE COMPUTADOR
- nomes de arquivos
- 1) ? 2) " 3) \ 4) / 5) : 6) * 7) I 8) < 9) >
- Até 260 caracteres
- Não pode usar em nome de arquivo \ / | < > * " : ?
- diretório
- C:\Pasta\subpasta até 260 caracteres
- lixeira
- até 40gb -> 10% acima 40 -> 5%
- teams
- O Microsoft Teams, parte do Office 365, inclui vários recursos de segurança e conformidade, como criptografia de dados em trânsito e em repouso, autenticação multifator (MFA), e gerenciamento de identidades e acessos.
- Não têm antivírus integrado
- A autenticação multifator é um método de autenticação eletrônica em que um usuário recebe acesso a um site ou aplicativo somente após apresentar com sucesso duas ou mais evidências a um mecanismo de autenticação.
- azure
- PACOTE OFFICE
- ONEDRIVE
- - SINCRONIZA ARQUIVOS NA NUVEM -W10 FAZ PARTE DO EXPLORADOR DE ARQUIVOS
- excel
- word
- sherepoint
- é uma ferramenta de gestão de arquivos. No Microsoft Office SharePoint, é possível compartilhar arquivos em um grupo de usuários, de forma online, e criar site para conectar uma equipe de forma que seus membros colaborem em projetos, por exemplo, para acompanhar calendário compartilhado de tarefas gerenciadas.
- ONEDRIVE
- ATALHOS
- espiar
- Canto inferior direito da tela
- visão de tarefa
- WIN+TAB Visão panoramica
- espiadinha rápida
- wind + ,
- espiar
- $
- FREEWARE
- SOFT LIVRE DE PAGAMENTO
- funcionamento completo por tempo indeterminado.
- Restrição ou não no uso
- DEMO
- -Demonstração -Uso por tempo limitado -Não tem todas as funcionalidade liberadas -Gratuito
- Shareware
- -Tempo limitado - Gratuito para testa, o usuário decidirá se comprará ou não.
- FREE SOFTWARE
- CLASSIFICAÇÃO DO SOFTWARE
DADOS
- Um dado é qualquer registro ou indício relacionável a alguma entidade ou evento. Sendo assim, os dados são unidades transportadoras de valor, armazenáveis, quantificáveis e transmissíveis, que não têm significado relevante num primeiro momento, mas que podem ser posteriormente transformadas em informações de real significância. Resumindo, dados podem ser definidos como sucessões de fatos brutos, que não foram processados, relacionados, avaliados ou interpretados, representando apenas partes isolada de eventos, situações ou ocorrências.Os dados são fatos que podem ser gravados e que possuem um significado implícito.
- BANCO DE DADOS
- - Conjunto de dados integrados que tem por objetivo atender a uma comunidade de usuários; - Um banco de dados é uma coleção de dados inter-relacionados, representando informações sobre um domínio específico; - Um banco de dados é uma coleção de dados relacionados
- Definir um banco de dados envolve especificar os tipos, estruturas e restrições dos dados a serem armazenados. A definição ou informação descritiva do banco de dados também é armazenada pelo SGBD na forma de um catálogo ou dicionário, chamado de metadados.
- SGBD
- Um sistema gerenciador de banco de dados (SGBD) é uma coleção de programas que permite aos usuários criar e manter um banco de dados. Podemos citar como exemplo o MySQL, o Microsoft Access, o Microsoft SQL Server, o Oracle Database e o dBASE.
- Função - O SGBD é um sistema de software de uso geral que facilita o processo de definição, de construção, de manipulação e de compartilhamento de bancos de dados entre diversos usuários e aplicações.
- USUÁRIOS
- DBA
- Database administrador - Autorizar o acesso ao banco de dados - coordenar e monitorar seu uso - adquirir recursos de software e hardware - falhas na segurança - demora no tempo de resposta do sistema - em grandes organizações ele é auxiliado por uma equipe
- PROJETISTAS
- - Identificam os dados a serem armazenados e escolhem a estrutura apropriada para apresentar esses dados, preferencialmente antes da implementação e população. - Conversar com os usuários.
- Os projetistas de banco de dados são responsáveis por identificar os dados a serem armazenados e escolher estruturas apropriadas para representar e armazenar esses dados. Essas tarefas são realizadas, principalmente, antes que o banco de dados esteja realmente implementado e populado com dados. É responsabilidade dos projetistas de banco de dados de se comunicar com todos os potenciais usuários a fim de entender suas necessidades e criar um projeto que as atenda. Em muitos casos, os projetistas estão na equipe de DBAs e podem receber outras responsabilidades após o projeto do banco de dados estar concluído. Os projetistas de banco de dados normalmente interagem com cada grupo de usuários e desenvolvem visões do grupo de dados que cumprem os requisitos de dados e processamento desses grupos. O projeto final do banco de dados precisa ser capaz de atender às necessidades de todos os grupos de usuários.
- USUÁRIOS FINAIS
- Um SGBD típico oferece múltiplas facilidades para acessar um banco de dados. Usuários iniciantes precisam aprender muito pouco sobre as facilidades oferecidas pelo SGBD; eles simplesmente têm de entender as interfaces de usuários das transações padrão projetadas e implementadas para seu uso. Os usuários casuais aprendem apenas algumas facilidades que podem usar repetidamente. Usuários sofisticados tentam aprender a maioria das facilidades do SGBD para satisfazer suas necessidades complexas. Usuários isolados costumam se tornar especialistas no uso de um pacote de software específico
- casuais
- ocasionalmente acessam o banco de dados, mas podem precisar de diferentes informações a cada vez. Utilizam uma linguagem sofisticada de consulta ao banco de dados para especificar suas necessidades e normalmente são gerentes de nível intermediário ou alto.
- iniciante ou paramétrico
- compõem uma grande parte dos usuários finais do banco de dados. Sua função principal gira em torno de consultar e atualizar o banco de dados constantemente, usando tipos de padrão de consultas e atualizações – denominadas transações programadas – que foram cuidadosamente programadas e testadas. As tarefas que esses usuários realizam são variadas:
- - Caixas de banco verificam saldos de conta e realizam saques, depósitos, pagamentos etc. - Agentes de companhias aéreas, hotéis e locadoras de automóveis verificam a disponibilidade de determinada solicitação e fazem reservas. - Funcionários nas estações de recebimento de transportadoras inserem identificações de pacotes por códigos de barra e informações descritivas por meio de etiquetas para atualizar um banco de dados central de pacotes recebidos e em trânsito.
- sofisticados
- incluem engenheiros, cientistas, analistas de negócios e outros que estão profundamente familiarizados com as facilidades do SGBD a ponto de implementar as próprias aplicações para que atendam a suas necessidades complexas.
- isolados
- mantêm bancos de dados pessoais usando pacotes de programas prontos, que oferecem interfaces de fácil utilização, baseadas em menus ou gráficos. Um exemplo é o usuário de um pacote de cálculos de impostos, que armazena uma série de dados financeiros pessoais para fins de declaração de impostos.
- ANALISTAS e ENGENHEIROS
- Analistas de sistemas e programações de aplicações (engenheiros de software) - Analistas de sistemas identificam as necessidades dos usuários finais, especialmente os iniciantes, e definem as especificações das transições padrão que atendam esses usuários. Os programadores de aplicações implementam essas especificações como programas; depois, eles testam, depuram, documentam e mantêm essas transações programadas. Esses analistas e programadores – também conhecidos como engenheiros de software e desenvolvedores de sistemas de software – devem estar familiarizados com todo o conjunto de capacidades fornecido pelo SGBD para realizarem suas tarefas.
- DBA
- FUNÇÃO
- construir
- manipular
- compartilhar
- outras
- controle de redundancia
- controle de acesso
- backup e recuperação
- restrição de integridade
- OBSERVAÇÕES
- Definir um banco de dados envolve especificar os tipos, estruturas e restrições dos dados a serem armazenados. A definição ou informação descritiva do banco de dados também é armazenada pelo SGBD na forma de um catálogo ou dicionário, chamado de metadados.
- Em um ambiente de bancos de dados, o recurso principal é o próprio banco de dados, e o recurso secundário é o SGBD e os softwares relacionados
- PROPRRIEDADES IMPLÍCITAS
- 1- • Um banco de dados representa alguns aspectos do mundo real, sendo chamado, às vezes, de minimundo ou de universo de discurso (UoD). As mudanças no minimundo são refletidas em um banco de dados
- 2 - Um banco de dados é uma coleção lógica e coerente de dados com algum significado inerente, ou seja, - uma organização de dados ao acaso (randômica) não pode ser corretamente interpretada como um banco de dados -
- Um banco de dados é projetado, construído e povoado por dados, atendendo a uma proposta específica. Possui um grupo de usuários definido e algumas aplicações predefinida, de acordo com o interesse desse grupo de usuários
- 4 - Um banco de dados pode ser de qualquer tamanho e de complexidade variável;
- 5 - Um banco de dados pode ser gerado e mantido manualmente ou pode ser automatizado (computadorizado).
- SISTEMA DE BANCO DE DADOS
- Um conjunto formado por um banco de dados, um SGBD e as aplicações que o manipulam, é chamado de sistema de banco de dados
- ARQUITETURA DE TRÊS ESQUEMAS
- O objetivo da arquitetura de três esquemas é separar as aplicações do usuário do banco de dados físico. Nessa arquitetura, os esquemas podem ser definidos nos três níveis a seguir:
- 1. O nível interno: tem um esquema interno, que descreve a estrutura do armazenamento físico do banco de dados. O esquema interno usa um modelo de dados físico e descreve os detalhes completos do armazenamento de dados e caminhos de acesso para o banco de dados.
- 2. O nível conceitual ( OU LÓGICO ): tem um esquema conceitual, que descreve a estrutura do banco de dados inteiro para uma comunidade de usuários. O esquema conceitual oculta os detalhes das estruturas de armazenamento físico e se concentra na descrição de entidades, tipos de dados, relacionamentos, operações do usuário e restrições. Normalmente, um modelo de dados representativo é usado para descrever o esquema conceitual quando um sistema de banco de dados é implementado. Esse esquema conceitual de implementação costuma estar baseado em um projeto de esquema conceitual em um modelo de dados de alto nível
- 3. O nível externo ou de visão: inclui uma série de esquemas externos ou visões do usuário. Cada esquema externo descreve a parte do banco de dados em que um grupo de usuários em particular está interessado e oculta o restante do banco de dados do grupo de usuários. Como no nível anterior, cada esquema externo é comumente implementado usando um modelo de dados representativo, possivelmente baseado em um projeto de esquema externo em um modelo de dados de alto nível.
- 1 - Nível interno descreve o banco de dados físico, suas característica, localização, acesso. 2 - Esquema conceitual, descreve a parte lógica as entidades, relacionamentos, como funciona toda a parte de configuração lógica. 3 - Nível externo, define quem e qual o nível de acesso dos usuários.
- INDEPENDÊNCIA DE DADOS
- Independência de dados lógica: é a capacidade de alterar o esquema conceitual sem mudar o esquema externo ou os programas. • Independência física de dados: é a capacidade de mudar o esquema interno sem ter de alterar o esquema conceitual.
- MODELAGEM DE DADOS
- - Nível de abstração, supressão de detalhes Organização e armazenamento, coleção de conceitos que podem ser usados para descrever a estrutura de um banco de dados representação simplificada da realidade. - Característica principal da abordagem do banco de dados é que ela oferece algum nível de abstração
- refere-se a supressão de detalhes da organização e armazenamento de dados, destacando recursos essenciais para um melhor conhecimento desses dados.
- Um modelo de dados é uma coleção de conceitos que podem ser usados para descrever a estrutura de um banco de dados.
- o modelo de dados pode ser de alto nível ou de baixo nível. Sendo assim os modelos de dados são classificados em:
- MODELOS
- Etapas para projetar um banco de dados 1 - Observar o mundo real 2 - Obter aspecto do mundo reale implementar no BD
- 1ª Etapa Criar modelo conceitual 2ª Etapa Criar modelo lógico 3ª Etapa Criar modelo Físico (não é obrigatório essa ordem, mas seguindo, as chances de eros são menores)
- CONCEITUAL
- Mais alto nível de abstração ( mais próximo da linguagem natural) < nível de detalhamento - Modelos de dados de alto nível ou conceituais oferecem conceitos que são próximos ao modo como muitos usuários percebem os dados, ou seja, descreve a estrutura de um banco de dados de forma independente de um SGBD específico. Podemos citar como exemplo de modelo de dados conceitual o Modelo Entidade-Relacionamento que utiliza conceitos como entidades, atributos e relacionamentos.
- não se usa o SGBD
- - Mais próximo do que o usuário percebe - Independe de um SGBD específico - MER ( modelo entidade relacionamento ) entidade, atributos, relacionamentos -Relacionamento que utiliza conceitos como entidades, atributos e relacionamentos.
- MER
- DER
- DIAGRAMA ENTIDADE RELACIONAMENTO
- entidade
- coisa que pode ser identificada: - Aluno, professor, universidade, disciplina ( entidade concreta e abstrata)
- Tipos de Entidades As entidades podem ser de três tipos:
- 1 - Entidade Forte: a entidade forte é a mais comum de ser encontrada. Essa entidade existe independentemente de qualquer outra entidade. Por ser a mais comum, normalmente a denominamos apenas entidade.
- 2 - Entidade Fraca: ao contrário das entidades fortes, as fracas são aquelas que dependem de outras entidades para existirem, pois individualmente elas não fazem sentido. Por exemplo, a entidade dependente só existirá se houver instâncias de funcionários que declarem filhos ou outros entes como dependentes. Assim, a entidade dependente é fraca, por depender da entidade funcionário.
- 3 - Entidade Associativa: também denominada agregação, trata-se de uma abstração pela qual os relacionamentos são tratados como entidades de nível superior.
- * Na prova o CESP disse não identificado, significa que não há entidade fraca * Entidade fraca = chave primária parcial + chave estrangeira * Entidade forte = tem sentido independente
- atributos
- o conceito de atributo é sinônimo de característica da entidade.
- - Atributo chave Dentre os atributos de uma entidade, devemos indicar um atributo identificador, que é comumente chamado de atributo-chave. Esse atributo identificará cada instância dentro da entidade.
- - Atributo simples Também conhecido como atributo atômico: CPF, CNPJ e NÚMERO DO CLIENTE
- - ATRIBUTO COMPOSTO Formado por itens menores, ou seja, pode ser subdividido em outros atributos. Ex. Endereço
- - Atributo multivalorado Conjunto de valores na mesma instância. Ex. Telefone,
- - Atributo derivado Deriva de outro atributo, idade que deriva de data de nascimento.
- - Atributo em relacionamento professor - - disciplina - no relacionamento ministrar há um atributo horário
- - valores nulos de atributos Apartamento = null, Para as pessoas que não moram em apartamento.
- relacionamento
- DER
- AUTORRELACIONAMENTO
- (CARDINALIDADES) RELACIONAMENTOS BINÁRIOS
- Razões de cardinalidade para relacionamentos binários (cardinalidade máxima) A razão de cardinalidade para um relacionamento binário especifica o número máximo de instâncias de relacionamento em que uma entidade pode participar. Há na literatura menções a quatro razões de cardinalidade possíveis para tipos de relacionamentos binários
- - um para um (1:1), - um para muitos (1:N) - muitos para um (N:1) - muitos para muitos (N:N). É importante destacar que a razão muitos para um (N:1) é a leitura inversa da razão um para muitos (1:N), sendo assim, a maioria dos autores acaba por excluí-la da tipologia.
- 1 : 1
- Esse relacionamento indica que uma instância de uma entidade só pode estar relacionada a no máximo a uma instância de outra entidade e vice-versa. Por exemplo, um professor só pode ministrar uma única disciplina, enquanto a disciplina só pode ser ministrada por um único professor.
- 1 : n
- Em um relacionamento um para muitos (1:N), uma instância de uma entidade pode estar relacionada a múltiplas instâncias da outra entidade, mas a recíproca não é verdadeira. Por exemplo, no caso do relacionamento entre professor e disciplina, pode ocorrer de um professor ministrar várias disciplinas, mas cada disciplina ser ministrada somente por um professor.
- n : 1
- Podemos encontrar a situação inversa, em que a disciplina pode ser ministrada por mais de um professor, mas, por sua vez, o professor leciona somente uma disciplina.
- n : n
- seguimos para o último caso, em que a cardinalidade é de muitos para muitos. Assim, temos que um professor ministra mais de uma disciplina e uma disciplina pode ser ministrada por mais de um professor.
- PÉ DE GALINHA
- TERNÁRIO
- Denominamos ternários os relacionamentos entre três conjuntos de entidades. Nesse caso, a cardinalidade refere-se a pares de entidades relacionadas com a terceira. No exemplo a seguir queremos garantir que a seguinte situação seja representada de forma apropriada: o professor X ministra a disciplina Y para a turma Z. Sendo assim, essa condição deve ser representada através de um relacionamento ternário. Funciona assim: - TURMA E DISCIPLINA: Esse par pode estar associado a no máximo um professor. - TURMA E PROFESSOR: Esse par pode estar associado a muitas disciplinas, ou seja, o mesmo professor pode ministrar na mesma turma várias disciplinas. - PROFESSOR E DISCIPLINA: Esse par pode estar associado a muitas turmas, ou seja, o professor pode ministrar a mesma disciplina em várias turmas.
- (CARDINALIDADES) RELACIONAMENTOS BINÁRIOS
- MAPEAMENTO PARA O MODELO LÓGICO
- Etapa 1: cada entidade torna-se uma tabela. Etapa 2: cada atributo torna-se um campo (coluna) da tabela criada. Etapa 3: o atributo-chave torna-se chave primária da tabela criada. Etapa 4: uma chave estrangeira é criada em uma tabela específica com base em regras definidas de acordo com a cardinalidade prescrita
- entidade = planilha atributos = campos/coluna
- TERMINOLOGIA M.R.
- CHAVE PRIMARIA PK-PRIMARY KEY
- chaves candidatas
- Uma chave é definida como chave candidata quando reúne todas as características de uma chave que pode ser utilizada para identificar exclusivamente uma tupla dentro de uma tabela. Portanto, é possível que a mesma tabela tenha mais de uma chave candidata. Por exemplo, observe a tabela Aluno apresentada na figura a seguir:
- Chave alternativa
- aquela que não foi escolhida como PK será uma chave alternativa
- composta
- Super Chaves
- Uma superchave é um conjunto de um ou mais atributos que, tomados coletivamente, nos permitem identificar de maneira unívoca uma entidade em um conjunto de entidades. Ou seja, uma superchave é capaz de diferenciar de forma única as instâncias de uma entidade.
- Super Chaves
- características
- - Única; - Campos obrigatórios (not null); - Irredutível.
- Chave primária
- Já as chaves primárias são um tipo especial de superchave. Elas são escolhidas pelo projetista do banco de dados entre as chaves candidatas, que são chaves que identificam univocamente uma entidade. A chave primária é a chave candidata selecionada para ser a principal forma de identificação de uma entidade.
- chaves candidatas
- CHAVE ESTRANGEIRA FK-FOREIGN KEY
- Uma chave estrangeira é um campo ou conjunto de campos de uma tabela que aponta para a chave primária (candidata) de outra tabela ou, em casos específicos, podendo apontar para a chave primária da mesma tabela. Principais características: • Uma mesma tabela pode ter mais de uma chave estrangeira • A chave estrangeira pode aceitar valor nulo (NULL) • A chave estrangeira de uma tabela tem que existir como chave primária na tabela referenciada (restrição de integridade referencial).
- FK -> PK NA MESMA TABELA
- FOREIGN KEY CHAVE ESTRANGEIRA
- CARACTERÍSTICAS
- Principais características: • Uma mesma tabela pode ter mais de uma chave estrangeira; • A chave estrangeira pode aceitar valor nulo (NULL); • A chave estrangeira de uma tabela tem que existir como chave primária na tabela referenciada (restrição de integridade referencial).
- 1 : N
- -no modelo lógico não pode ter campos multivalorados - a chave FK foreign Key tem que ser do lado N por se for no lado 1, será criado um capo COD como FK e ele será multivalorado (isso não pode) - Sendo no lado N (FK) será criado um campo CPF pois é mínimo zero e máximo N, podendo ter campo nulo
- N : M
- 1 : 1
- RESTRIÇÃO DE INTEGRIDADE
- de domínio
- Integridade de domínio: define os valores que podem ser assumidos pelos campos de uma coluna.
- de vazio
- Integridade de vazio: especifica se o campo de uma coluna pode ou não ser vazio.
- de unicidade
- Integridade de unicidade: define que o valor do campo seja único.
- de chave
- • Integridade de chave: define que os valores da chave primária e alternativa devem ser únicos.
- de entidade
- Integridade de entidade: define que nenhum valor da chave primária pode ser nulo.
- referêncial
- • Integridade referencial: define que os valores dos campos que aparecem numa chave estrangeira devem aparecer na chave primária da tabela referenciada.
- de domínio
- fusão de tabelas
- A CARDINALIDADE MÁXIMA TEM QUE SER 1 : 1 E O OBRIGATORIEDADE EM PELO MENOS UM DOS LADOS
- 1:1
- LÓGICO
- TEM QUER TER UM SGBD MAS NÃO ESPECÍFICO
- representa a estrutura de dados de um banco de dados conforme o paradigma que será utilizado
- No modelo lógico não podemos ter campos multivalorados
- M. Hierárquico
- Modelo Hierárquico: nesse modelo, os dados são organizados similarmente a organização de pastas do computador, pois foi a primeira construção de uma base de dados em substituição ao sistema de arquivos, por isso a semelhança. Assim, quando um dado está ligado ao outro significa que se trata de uma informação associada a ele. Pode-se dizer que esse modelo trabalha com a forma de uma árvore. Também é característica do modelo de que cada registro é uma coleção de atributos, sendo que cada um contém apenas um valor.
- M. em rede
- Modelo em Rede: é constituído de vários registros conectados uns aos outros por meio de ligações (ponteiros). As ligações consistem em relações entre os registros, esse modelo oferece maior segurança do que o modelo hierárquico uma vez que o acesso não passa por um nó raiz
- M. relacional
- Modelo Relacional: o modelo relacional foi introduzido por Edgar Frank Codd em 1970. Representa os dados em um banco de dados como uma coleção de relações (tabelas). Sua teoria baseia-se na teoria dos conjuntos e álgebra relacional
- L. SQL
- O que é SQL? A Linguagem de consulta estruturada (SQL) é uma linguagem de programação para armazenar e processar informações em um banco de dados relacional. Um banco de dados relacional armazena informações em formato tabular, com linhas e colunas representando diferentes atributos de dados e as várias relações entre os valores dos dados. Você pode usar instruções SQL para armazenar, atualizar, remover, pesquisar e recuperar informações do banco de dados. Também pode usar SQL para manter e otimizar a performance do banco de dados.
- ddl
- - linguagem de definição de dados (ddl) Esse subconjunto possui comandos que possibilitam a criação, a modificação e também a exclusão de tabelas - Criação ( create table )- modificação ( alter table )- Exclusão Drop table
- dml
- - Linguagem de manipulação de dados (DML) Esse subconjunto possui comandos que possibilitam a inserção, a atualização e exclusão de registros em uma tabela. - Insert- Delete- Uptade- Select (consultas - pode estar em outro subconjunto, no DQL)
- dcl
- DCL (data control language – linguagem de controle de dados) Os comandos DCL definem as permissões dos usuários
- dtl
- DTL (data transaction language – linguagem de controle de transações) (data transaction language – linguagem de controle de transações) Como sempre, é importante lembrar das propriedades essenciais nas transações de um BD conhecidas como ACID (Atomicidade, Consistência, Isolamento e Durabilidade), deste modo, para que sejam garantidas são definidos mecanismos para controlar estas transações. Os principais comandos do conjunto DTL são: • BEGIN TRANSACTION • COMMIT • ROLLBACK
- ATOMICIDADE: Todas as ações que compõem a unidade de trabalho da transação devem ser concluídas com sucesso, para que seja efetivada. Se durante a transação qualquer ação que constitui unidade de trabalho falhar, a transação inteira deve ser desfeita (rollback). Quando todas as ações são efetuadas com sucesso, a transação pode ser efetivada e persistida em banco (commit).
- CONSISTÊNCIA: Todas as regras e restrições definidas no banco de dados devem ser obedecidas. Relacionamentos por chaves estrangeiras, checagem de valores para campos restritos ou únicos devem ser obedecidos para que uma transação possa ser completada com sucesso.
- ISOLAMENTO: cada transação funciona completamente à parte de outras transações. Todas as operações são parte de uma transação única. O princípio é que nenhuma outra transação, operando no mesmo sistema, possa interferir no funcionamento da transação corrente (é um mecanismo de controle). Outras transações não podem visualizar os resultados parciais das operações de uma transação em andamento (ainda em respeito à propriedade da atomicidade).
- DURABILIDADE: significa que os resultados de uma transação são permanentes e podem ser desfeitos somente por uma transação subsequente. Por exemplo: todos os dados e status relativos a uma transação devem ser armazenados num repositório permanente, não sendo passíveis de falha por uma falha de hardware.
- M. O. objeto
- Modelo Orientado a Objeto: são bancos criados baseados no modo de programação orientada a objetos, em que são criadas classes que descrevem o objeto, ou seja, uma classe é um conjunto de informações, características, relações, ações e atributos que definem o objeto.
- VELOCIDADES DOS BANCO DE DADOS
- Os multidimensionais são mais rápidos e eficazes, haja vista que é mais voltado para o processamento de consultas, ao passo que o modelo Relacional é mais voltado para o processamento de transações, embora mais eficientes, não são tão rápido se comparado com os multidimensionais. A consulta em bancos multidimensionais é mais rápida devido à redução de joins (um meio de combinar colunas de uma (autojunção) ou mais tabelas, usando valores comuns a cada uma delas.) Entre as tabelas.
- FÍSICO
- Mais baixo nível de abstração, mais próximo da linguagem do computador, > nível de detalhamento. Os modelos de dados de baixo nível, também chamados de modelos físicos, oferecem conceitos que descrevem os detalhes de como os dados são armazenados no computador, ou seja, são definidas as estruturas de armazenamento interno, organizações de arquivos, índices, caminhos de acesso e parâmetros físicos do projeto. Esse modelo é dependente do SGBD, em que será implementado
- Mais baixo nível, linguagem SQL
- - descrevem os detalhes de como os dados são armazenados no computador, ou seja, são definidas as estruturas de armazenamento interno, organizações de arquivos, índices, caminhos de acesso e parâmetros físicos do projeto. Esse modelo é dependente do SGBD,
- Tem que ter um SGBD específico
- dependência
- DIFERENTES
- SISTEMA DA INFORMAÇÃO
- INTERNET E INTRANET
- Internet rede das redes
- A Internet consiste em várias redes separadas que estão interconectadas por roteadores. A finalidade da Internet, naturalmente, é interconectar sistemas finais, chamados hosts; estes incluem PCs, estações de trabalho, servidores, mainframes e assim por diante. A maioria dos hosts que utilizam a Internet está conectada a uma rede, como uma rede local (LAN) ou uma rede remota (WAN). Essas redes, por sua vez, são conectadas por roteadores a um ISP (Internet Service Provider). ISP é a designação dada a uma operadora de comunicações que esteja integrada à Internet e que proporcione acesso a outros ISPs ou a usuários finais. A comunicação entre os ISPs é realizada por meio de backbones (espinha dorsal). O funcionamento da Internet é baseado na família de protocolos TCP/IP, um conjunto de protocolos que assegura a padronização das comunicações entre dispositivos de diferentes países, idiomas, sistemas operacionais e programas.
- CLOUD COMPUTING ( nuvem )
- é a entrega de TI sob demanda por meio da internet com definição de preço de pagamento conforme o uso
- "Computação em nuvem é um modelo para permitir acesso ubíquo, conveniente e sob demanda há um conjunto compartilhado de recursos de computação configuráveis (por exemplo, redes, servidores, equipamentos de arma-zenamento, aplicações e serviços), que podem ser rapidamente alocados e liberados com o mínimo de esforço de gerenciamento ou interação com prestador de serviço”
- NIST: Instituto Nacional de Padrões e Tecnologia do Departamento de Comércio Norte-americano
- CLASSIFICAÇÃO
- Cloud incompatible
- Cloud compatible
- Embora não tenha sido desenvolvido pra a nuvem, pode ser implantado e executado na infraestrutura de computação em nuvem sem grandes modificações.
- Cloud ready
- foi projetado e desenvolvido com a intenção de ser implantado na nuvem
- Optimized for the cloud
- foram ajustados e configurados especificamente para funcionar de maneira ideal na infraestrutura de computação em nuvem
- Aligned with the cloud
- em conformidade com os princípios e padrões de segurança, escalabilidade e flexibilidade associados à computação em nuvem.
- alinhado com a nuvem
- CARACTERÍSTICA
- amplo acesso à rede
- os recursos computacionais devem estar disponíveis para serem acessados via internet e de uma forma padronizada, garantindo assim a possibilidade de uso através dos mais diversos tipos de dispositivos (smartphones, tablets, computadores etc.).
- rápida elastividade
- as funcionalidades computacionais devem ser fornecidas de maneira rápida e elástica, ou seja, podem crescer ou diminuir rapidamente. O usuário precisa ter a percepção da existência ilimitada de recursos e que eles podem ser adquiridos quando ele quiser e na quantidade desejada
- serviços mensuráveis
- deve haver controle e monitoramento automático dos recursos utilizados por cada serviço oferecido. Esse monitoramento deve acontecer de forma transparente, tanto para o provedor quanto para o usuário do serviço.
- autosserviço sob demanda
- capacidade de prover funcionalidades computacionais de maneira automática, sem que haja necessidade do usuário interagir com o provedor de serviço.
- agrupamento de recurso
- múltiplos usuários podem fazer uso, concomitantemente, dos recursos computacionais (físicos ou virtuais) oferecidos pelo provedor. Esses recursos devem ser alocados e realocados de forma dinâmica de acordo com a necessidade de cada usuário. Nesse caso, há uma certa independência de localização geográfica, uma vez que o consumidor em geral não controla ou conhece a localização exata dos recursos fornecidos (como armazenamento, processamento, memória e comunicação de rede), mas pode ser capaz de especificar a localização em um nível de abstração mais alto (como país, estado ou datacenter).
- amplo acesso à rede
- BENEFÍCIOS
- 1 - custo 2 - Velocidade 3 - Escala global 4 - Produtividade 5 - Confiabilidade 6 - Segurança
- RESOURCE CLOUD COMPUTING
- Virtual Machine
- costumam ser consideradas como computadores virtuais ou computadores definidos por software em servidores físicos, existindo apenas como código
- - Chamado de imagem
- -Independentes umas das outras
- Diversas VM podem ser executadas ao mesmo tempo no mesmo computador físico.
- flexível
- executa um sistema operacional completo, incluindo o Kernel
- Hipervisor
- É um software que integra o hardware físico e o hardware virtual da VM. Ele garante que cada VM obtenha os recursos necessários do servidor físico de maneira ordenada e oportuna.
- Pode mover um VM de um hipervisor para outro sem dificuldades.
- vantagens
- 1 - Economia de custos 2 - Agilidade e velocidade 3 - Tempo de inatividade reduzido 4 - Escalabilidade 5 - Benefícios de segurança
- 1 - Economia de custos: a execução de vários ambientes virtuais por meio de uma única infraestrutura significa que você pode reduzir drasticamente o volume ocupado pela infraestrutura física. Isso aumenta seus resultados, diminuindo a necessidade de manter tantos servidores e economizando em custos de manutenção e eletricidade.
- 2 - Agilidade e velocidade: ativar uma VM é relativamente fácil e rápido, e muito mais simples do que provisionar um ambiente totalmente novo para seus desenvolvedores. A virtualização torna o processo de execução de cenários de desenvolvimento e teste muito mais rápido.
- 3 - Tempo de inatividade reduzido: as VMs são muito portáteis e fáceis de passar de um hipervisor para outro em um computador diferente, o que significa que são uma ótima solução para backup, caso o host fique inativo inesperadamente.
- 4 - Escalabilidade: as VMs permitem que você escale seus aplicativos mais facilmente, adicionando mais servidores físicos ou virtuais para distribuir a carga de trabalho entre várias VMs. Como resultado, você pode aumentar a disponibilidade e o desempenho de seus aplicativos.
- 5 - Benefícios de segurança: como as máquinas virtuais são executadas em vários sistemas operacionais, o uso de um sistema operacional convidado em uma VM permite que você execute aplicativos de segurança questionável, protegendo o sistema operacional do host. As VMs também permitem melhor análise forense de segurança e costumam ser usadas para estudar vírus de computador de maneira segura, isolando-os para evitar o risco de seu computador host.
- CONTÊINER
- Ao contrário de um contêiner, uma máquina virtual (VM) executa um sistema operacional completo, incluindo seu próprio kernel. Os contêineres fornecem um ambiente leve e isolado que torna os aplicativos mais fáceis de desenvolver, implantar e gerenciar. Os contêineres iniciam e param rapidamente, tornando-os ideais para aplicativos que precisam se adaptar rapidamente a demandas que se alteram. A natureza leve dos contêineres também os torna uma ferramenta útil para aumentar a densidade e a utilização de sua infraestrutura.
- Diferença é que VM executam um sistema operacional completo, incluindo seu kernel
- SERVERLESS COMPUTING
- Computação sem servidor permite executar o código do aplicativo sem a criação, configuração ou a manutenção de um servidor
- funções separadas que são executadas quando disparadas por alguma ação. Ex. SMS de confirmação após uma compra on-line.
- Paga apenas o tempo de processamento
- Nessa arquitetura não funciona todos os aplicativos.
- Algo executado por evento
- pode separar um código como script e executar ele por um estimulo.
- Virtual Machine
- MODELOS
- PÚBLICA
- Mais comum. Os recursos pertencem e são gerenciadas pelo provedor, o terceirizado. eles operam e são entregues pela internet. Você opera usando um navegador. Ex. e-mail web, aplicativos de escritório on-line, armazenamento e ambientes de desenvolvimentos e testes.
- PRIVADA
- - Exclusivo para uma única organização que é responsável por seu gerenciamento e operação ( e ou por terceiros ). - Controle sobre sua localização geográfica. - Sistema de restrição de acesso ou de missão crítica. - Elasticidade reduzida. - Custos associadas também é menor do que cloud public. - Poder mitigar (suavizar) alguns riscos de segurança.
- HIBRIDA
- é a combinação de duas ou mais infraestruturas de nuvem ( privada, comunitária ou pública), interligadas por tecnologias padronizadas ou proprietárias que permitem portabilidade de aplicações e de dados entre as nuvens.
- alguns aplicativos podem ser executados em infraestruturas diferentes.
- Pode ser usada para segmentar o trabalho, ou seja, conectar os dois ambientes com uma rede segura e privada para trocar dados, assim parte dos dados é processado em sua infraestrutura local e privada e a outra parte na nuvem.
- Para intermitência de nuvem, para serviços que precisam ser intermitentes, Quando um datacenter interno atingir o limite máximo de carga de trabalho, dimensiona-se para a rede pública, quando a rede privado normalizar, retorna os recursos para ela.
- COMUNITÁRIA
- Disponível para uso exclusivo de uma comunidade específica formada por organizações que possuem interesses e preocupações em comum. Ex. Requisitos de segurança e conformidade.
- A sua propriedade, gerenciamento e operação podem ser de uma ou mais organizações da comunidade, de terceiros ou de uma combinação mista, e pode estar dentro ou fora das instalações das organizações participantes.
- PÚBLICA
- TIPOS
- iaas
- (INFRAESTRUTURA COMO SERVIÇO) Em vez de comprar o hardware diretamente, as empresas pagam por IaaS sob demanda.O IaaS contém os componentes básicos da TI na nuvem. Normalmente, o IaaS oferece acesso a recursos de rede, computadores (virtuais ou em hardware dedicado) e espaço de armazenamento de dados.
- A infraestrutura é escalável dependendo das necessidades de processamento e armazenamento
- As empresas economizam com os custos de compra e manutenção de seu próprio hardware
- Mais alto nível de flexibilidade
- - as empresas economizam com os custos de compra e manutenção de seu próprio hardware. - a infraestrutura é escalável dependendo das necessidades de processamento e armazenamento. - em vez de comprar o hardware diretamente, as empresas pagam por IaaS sob demanda
- paas
- ( PLATAFORMA COMO SERVIÇO ) Os recursos fornecidos ao consumidor são linguagens de programação, bibliotecas, serviços e ferramentas de suporte ao desenvolvimento de aplicações, para que o consumidor possa implantar, na infraestrutura da nuvem, aplicativos criados ou adquiridos por ele. O consumidor não gerencia nem controla a infraestrutura subjacente da nuvem (rede, servidores, sistema operacional, banco de dados ou armazenamento), mas tem controle sobre as aplicações implantadas e possivelmente sobre as configurações do ambiente que hospeda as aplicações
- ( PRINCIPAIS CARACTERÍSTICAS) - Fornece uma plataforma com ferramentas para testar, desenvolver e hospedar aplicativos no mesmo ambiente - Permite que as organizações se concentrem no desenvolvimento sem precisar se preocupar com a infraestrutura subjacente; - Os provedores gerenciam a segurança, os sistemas operacionais, o software de servidor e os backups; - Facilita o trabalho colaborativo mesmo que as equipes trabalhem remotamente.
- saas
- ( SOFTWARE COMO SERVIÇO ) São as aplicações do fornecedor executadas em uma infraestrutura de nuvem (conforme as cinco características de computação em nuvem), disponíveis ao consumidor. As aplicações podem ser acessadas por vários dispositivos clientes, tais como navegador web ou um software cliente. O consumidor não gerencia nem controla a infraestrutura da nuvem associada ao serviço, incluindo rede, servidores, sistemas operacionais, armazenamento ou mesmo recursos individuais da aplicação. Portanto, o SaaS oferece um produto completo, executado e gerenciado pelo provedor de serviços.
- Ex. Webmail
- PRINCIPAIS CARACTERÍSTICAS - Os fornecedores SaaS oferecem aos usuários aplicativos em um modelo de assinatura. - Os usuários não precisam gerenciar, instalar ou atualizar o software, os provedores SaaS gerenciam isso. - Possibilita que o usuário acesse aplicativos e serviços de qualquer local usando um computador conectado à Internet.
- iaas
- GOOGLE
- OR
- Resultados de uma palavra ou de outr
- " "
- " Conteúdo exata"
- - (menos)
- Colocado na frente da palavra, a elimina na pesquisa
- + (mais)
- tecnologia +celular apresenta resultados para tecnologia que contenha celular junto
- ~
- ~sinômino da palavra
- allinanchor
- allinanchor: tecnologia
- Usa-se esta palavra para buscar a palavra pesquisada nos links das páginas
- Aparecerá todos os links de páginas que possuam a palavra "tecnologia";
- inanchor
- As buscas trarão resultados nos quais os termos aparecerão em textos âncoras de links para as páginas.
- tecnologia inanchor: celular Aparecerá em todas as buscas sobre "tecnologia" somente as que tiverem no link páginas que possuam a palavra "celular";
- allintext
- Todos os termos pesquisados aparecerão nos textos das páginas localizadas
- Ex.: allintext: tecnologia celular smartphone
- Aparecerá todos os resultados cuja descrição contenham as palavras "tecnologia", "celular" e "smartphone"
- intitle
- Ex.: tecnologia intitle: celular
- Busca por "tecnologia" cujo título da página tenha o termo "celular";
- allinurl
- allinurl: tecnologia Todos os links de páginas que possuam a palavra "tecnologia";
- Resultados trazem as palavras na URL da págin
- inurl
- Termos que aparecem na URL de determinado site
- inurl:tecnologia site:techtudo.com.br
- Todas as páginas do TechTudo que contenham a palavra "tecnologia"
- allintitle
- As buscas reportarão resultados que aparecerão nos títulos das páginas
- Ex.: allintitle: tecnologia celular
- Todas as buscas cujo título da página contenha as palavras "tecnologia" e "celular";
- intext
- Termos que aparecem no texto da página
- Ex.: tecnologia intext: celular
- Busca pelo termo "tecnologia", mas apenas os que contenham "celular" no texto descritivo;
- CRTL + SHIFT + T
- Recuperar aba fechado erroneamente.
- mudar de aba
- Ctrl+Tab ou Ctrl+PgDown Alterna para a próxima guia. Ctrl+Shift+Tab ou Ctrl+PgUp Alterna para a guia anterior
- navegação segura
- Rastreia e analisa a Web para descobrir sites potencialmente nocivos e adicioná-los às listas de proteção. Sempre que você acessa um site ou tenta fazer um download, o Chrome faz uma verificação usando a Navegação segura com base no nível de proteção selecionado. Tipos de proteção: - Proteção reforçada: a experiência de navegação mais segura do Google, a proteção reforçada oferece proteção contra novas ameaças em potencial e já conhecidas. - Proteção padrão: oferece segurança contra ameaças conhecidas. - Sem proteção (não recomendado): também é possível desativar a Navegação segura, mas você não terá proteção contra sites, extensões e downloads potencialmente perigosos. Sua configuração da Navegação segura em outros produtos do Google não será afetada.
- OR
- protocolo
- É um conjunto de regras que define o formato e a ordem das mensagens trocadas entre duas ou mais entidades comunicantes, bem como as ações realizadas na transmissão e/ou no recebimento de uma mensagem ou outro evento. Basicamente, a Internet opera da seguinte maneira: um host pode enviar dados para outro host em qualquer lugar na Internet. O host de origem divide os dados a serem enviados em uma sequência de pacotes, chamados datagramas IP, ou pacotes IP. Cada pacote inclui um endereço numérico exclusivo para o host de destino. Esse endereço é denominado endereço IP. Com base nesse endereço de destino, cada pacote atravessa uma série de roteadores e redes da origem ao destino. Cada roteador, quando recebe um pacote, toma uma decisão de roteamento e direciona o pacote pelo seu caminho até o destino. Cada roteador se conecta a duas ou mais redes.
- intranet
- 2. Intranet Intranet é um termo que se refere à implementação de tecnologias de Internet dentro de uma organização corporativa. Portanto, a Intranet é uma rede privada, ou seja, seu acesso é restrito a um grupo específico de usuários. Sendo assim, haverá um processo de autenticação dos usuários para que o acesso seja liberado à Intranet. Normalmente, esse processo de autenticação é realizado por meio de login e senha. O funcionamento da Intranet também é baseado na família de protocolos TCP/IP.
- conteúdo web
- 2.1 Conteúdo web Uma organização pode utilizar a Intranet web para melhorar a comunicação gerência-empregado e fornecer informações relacionadas ao trabalho de modo fácil e rápido. Normalmente, existe uma página inicial (home page) corporativa interna que serve como um ponto de entrada para os funcionários na Intranet. A partir dessa página inicial, existem links para áreas de interesse da empresa ou de grandes grupos de empregados, incluindo recursos humanos, finanças e serviços de sistemas de informação. Outros links são para áreas de interesse dos grupos de empregados, como vendas e manufatura. Esse acesso é realizado por meio de navegadores web, como, por exemplo, o Internet Explorer e o Mozilla Firefox.
- extranet
- Um conceito semelhante ao da Intranet é a Extranet. Assim como a Intranet, a Extranet utiliza protocolos e aplicações TCP/IP, especialmente a Web. O recurso distinto da Extranet é que ela dá acesso a recursos corporativos a clientes externos, normalmente fornecedores e clientes da organização. Esse acesso externo pode ser pela Internet ou por outras redes de comunicação de dados. Uma Extranet proporciona mais do que o simples acesso à Web para o público, que praticamente todas as empresas agora oferecem. Em vez disso, a Extranet dá acesso mais extenso a recursos corporativos, normalmente em um modelo que impõe uma política de segurança. Assim como na Intranet, o modelo típico de operação para a Extranet é cliente/ servidor. A Extranet permite o compartilhamento de informações entre empresas. Uma observação importante com Extranets é a segurança. Como os recursos Web corporativos e os recursos de banco de dados se tornam disponíveis para os de fora e são permitidas transações contra esses recursos, aspectos de privacidade e autenticação precisam ser resolvidos. Esse acesso geralmente é realizado por meio de uma VPN (Rede Privada Virtual).
- VPN
- 4. VPN (virtual private network)São redes sobrepostas às redes públicas, mas com a maioria das propriedades das redes privadas. A rede privada virtual pode ser criada com o objetivo de substituir links de comunicação dedicados.Muitas empresas têm escritórios e fábricas espalhados por muitas cidades, às vezes por vários países. A conexão entre esses escritórios e fábricas pode ser realizada por meio de links dedicados, o que torna o custo de implementação e manutenção muito alto. Sendo assim, uma VPN pode ser criada para permitir a conexão entre os escritórios e fábricas utilizando a Internet, o que torna o custo bem mais baixo.4.1 VPN é segura?O uso de uma rede pública expõe o tráfego da empresa à espionagem e oferece um ponto de entrada em potencial para usuários não autorizados. Diante desse cenário, a rede privada virtual foi criada para combinar tecnologias de criptografia, de autenticação e de tunelamento, permitindo, assim, que a conexão realizada por meio de uma VPN seja considerada segura.
- VPN é segura? O uso de uma rede pública expõe o tráfego da empresa à espionagem e oferece um ponto de entrada em potencial para usuários não autorizados. Diante desse cenário, a rede privada virtual foi criada para combinar tecnologias de criptografia, de autenticação e de tunelamento, permitindo, assim, que a conexão realizada por meio de uma VPN seja considerada segura
- INFORMAÇÃO
- Peter Drucker definiu informação como "dados dotados de relevância e propósito".
- Podemos definir informação como sendo um conjunto de dados ordenados e organizados de forma a transmitir significado e compreensão dentro de um determinado contexto, ou seja, dados brutos não podem ser definidos como informação. Dessa forma, informação deve ser aquilo que reduz a incerteza. Além disso, a informação deve ser utilizada de forma a fundamentar o conhecimento. Peter Drucker definiu informação como "dados dotados de relevância e propósito". Quem os dota de tais atributos? Os seres humanos, é claro. Pessoas transformam dados em informação. Ao contrário dos dados, a informação exige análise. A clara percepção da informação é o primeiro requisito para que ela possa ser compreendida, e a compreensão de uma informação é o primeiro passo para que ela se torne um conhecimento.
- bit
- bit é a menor unidade de informação que pode ser armazenada, transmitida ou processada por um sistema computacional.
- De acordo com a teoria da Informação, a forma de representação mais simples de uma informação é dada por um par de possibilidades/opções, que indicam situações opostas, tais como: sim/não, ligado/desligado, verdadeiro/falso etc. Em computação, essas opções podem ser representadas por um dígito binário, o famoso bit (binary digit), da seguinte maneira: BIT SIGNIFICADO 0 Não, desligado, falso. 1 Sim, ligado, verdadeiro.
- CONHECIMENTO
- É a capacidade, adquirida por alguém, de interpretar e operar sobre um conjunto de informações. Essa capacidade é construída a partir de experiências, impressões, valores, crenças etc. O conhecimento é dinâmico, ou seja, quem conhece pode estabelecer novas relações, tirar novas conclusões, fazer novas inferências, agregar novas informações, reformular significados. Ao exercitar o conhecimento, ele se consolida e cresce. Portanto, conhecimento é uma propriedade subjetiva, inerente a quem analisa as informações. Sendo assim, conhecer é o processo de compreender e interiorizar as informações recebidas, possivelmente combinandoas de forma a gerar mais conhecimento.
- TÁCITO
- 1. Conhecimento Tácito: ➢ A palavra tácito vem do latim tacitus que significa “silencioso, não expresso por palavras”. ➢ É o conhecimento que existe na mente das pessoas, formulado a partir de experiências que cada um adquiriu ao longo de sua vida. ➢ É altamente pessoal, ou seja, difícil de ser formalizado ou explicado a outra pessoa, pois é subjetivo e inerente às habilidades de um indivíduo, como “know-how”.
- EXPLIÍCITO
- 2. Conhecimento Explícito: ➢ A palavra explícito vem do latim explicitus que significa “formal, explicado, claro, declarado”. ➢ É o conhecimento formal, claro, regrado, fácil de ser descrito e comunicado a outras pessoas. ➢ É o conhecimento que está registrado em livros, revistas, artigos, diagramas, desenhos, figuras e documentos, dentre outros. ➢ Esse conhecimento é de fácil articulação, manipulação e transmissão.
- ESPIRAL DE CONHECIMENTO
- MODOS DE CONVERSÃO DO CONHECIMENTO: 1. DE TÁCITO PARA TÁCITO: Socialização – processo de criar conhecimento tácito comum a partir da troca de experiência. 2. DE TÁCITO PARA EXPLÍCITO: Externalização – processo de articular conhecimento tácito em conceitos explícitos. Geralmente essa articulação é efetuada através de metáforas, analogias, conceitos, hipóteses ou modelos. 3. DE EXPLÍCITO PARA EXPLÍCITO: Combinação – processo de agregar conhecimentos explícitos, novos ou já existentes, num sistema de conhecimento como um conjunto de especificações para um novo produto ou serviço. 4. DE EXPLÍCITO PARA TÁCITO: Internalização – processo de incorporar conhecimento explícito em tácito. Está geralmente relacionado com aprender fazendo.
- INTELIGÊNCIA
- Inteligência no nosso contexto diz respeito à sabedoria, ou seja, quando alguém utiliza o seu conhecimento para algum propósito. Sendo assim, é uma habilidade essencialmente humana. Nessa etapa, os gestores aplicam ao conhecimento gerado, suas habilidades, suas competências de negócio e vivência na organização, para identificar direções estratégicas, tais como: ➢ Novos projetos de pesquisa; ➢ Acordos de cooperação; ➢ Transferência de tecnologia; ➢ Ações e reações da concorrência.
- INTERNET E INTRANET
- TIPOS
- Os dados podem ser classificados como: Estruturados Semiestruturados Não estruturados
- ESTRUTURADOS
- Dados estruturados são aqueles organizados e representados com uma estrutura rígida, a qual foi previamente planejada para armazená-los. Sendo assim, os dados armazenados e mantidos por um SGBD (sistema gerenciador de banco de dados) são exemplos de dados estruturados.
- CARACTERÍSTICAS
- Principais características: Dados organizados em blocos semânticos (relações); Dados de um mesmo grupo possuem as mesmas descrições (atributos); compartilham o mesmo formato (esquema).
- SEMIESTRUTURADOS
- Dados semiestruturados apresentam uma representação estrutural heterogênea, não sendo nem completamente não estruturados nem estritamente tipados. A principal diferença entre dados estruturados e semiestruturados diz respeito a como as construções do esquema (como os nomes de atributos, relacionamentos e tipos de entidade) são tratadas. Nos dados semiestruturados, a informação do esquema é misturada com os valores dos dados, já que cada objeto de dado pode ter atributos diferentes que não são conhecidos antecipadamente. Logo, esse tipo de dado às vezes é chamado de dado autodescritivo. Podemos citar como exemplo de dados semiestruturados os arquivos em formato XML (eXtensible Markup Language).
- CARACTERISTICAS
- Definição a posteriori: esquemas para dados semiestruturados são usualmente definidos após a existência dos dados, com base em uma investigação de suas estruturas particulares e da análise de similaridades e diferenças. Isso não significa que sempre existe um esquema associado a um dado semiestruturado; Estrutura irregular: coleções extensas de dados semanticamente similares estão organizados de maneiras diferentes, podendo algumas ocorrências terem informações incompletas ou adicionais em relação a outras. Em suma, não existe um esquema padrão para esses dados; Estrutura implícita: muitas vezes existe uma estrutura básica para os dados, porém, essa estrutura está implícita na forma como os dados são apresentados; Estrutura parcial: apenas parte dos dados disponíveis pode ter alguma estrutura, seja implícita ou explícita. Estrutura evolutiva: a estrutura dos dados modifica-se tão frequentemente quanto os seus valores. Dados Web apresentam este comportamento, uma vez que existe o interesse em manter dados sempre atualizados; Distinção entre estrutura e dados não é clara: como a estrutura está embutida na descrição dos dados, muitas vezes a distinção lógica entre estrutura e valor não é clara.
- NÃO ESTRUTURADOS
- Além de dados estruturados e semiestruturados, existe uma terceira categoria, conhecida como dados não estruturados. Nesse caso, os dados não estruturados não possuem uma estrutura definida. Documentos, imagens e vídeos são exemplos típicos de dados não estruturados. É importante destacar que as estruturas dos dados não estruturados não são descritas nem implicitamente. Assim, é fácil concluir que as redes sociais, as quais possuem um enorme volume de dados, como textos, imagens e vídeos criados diariamente por usuários, representam outro exemplo de dados não estruturados. Atualmente, mais de 80% do conteúdo digital gerado no mundo é do tipo não estruturado
- DATA MINING
- METADADOS
- Contem dados sobre dados, que explicam os outros dados. “Dados estruturados e codificados, que descrevem e permitem acessar, gerenciar, compreender e/ou preservar outros dados ao longo do tempo.”
- BIG DADOS
- Big Data refere-se a conjuntos de dados que são tão volumosos, rápidos ou complexos que é difícil processá-los usando métodos de banco de dados tradicionais. O termo não se aplica apenas ao tamanho dos dados, mas também à variedade de tipos de dados e à velocidade com que esses dados devem ser processados e analisados
- EVOLUÇÃO
- A história do Big Data pode ser vista como uma evolução dos métodos de armazenamento e análise de informações:
- • Década de 1960 e 1970: Os conceitos iniciais de grandes bases de dados emergiram com a necessidade de armazenar informações governamentais e de pesquisa.
- • Década de 1980 e 1990: A popularização dos computadores pessoais e a expansão da internet aumentaram exponencialmente a geração de dados.
- • Anos 2000: O termo “Big Data” começa a ser usado para descrever a explosão de dados digitais e a necessidade de novas ferramentas para lidar com essa vasta quantidade de informações
- • Última década: Desenvolvimento de tecnologias como Hadoop e soluções de armazenamento em nuvem que permitem às empresas e organizações gerenciar e analisar grandes volumes de dados de forma mais eficiente.
- IMPORTÂNCIA NA ERA DIGITAL
- O Big Data tornou-se um recurso crucial para a tomada de decisões e a obtenção de insights competitivos em praticamente todos os setores: •. •
- Inovação e Competitividade
- • Inovação e Competitividade: Organizações usam Big Data para inovar, melhorar produtos e serviços, e personalizar a experiência do cliente, o que pode ser um diferencial competitivo significativo.
- Eficiência Operacional
- • Eficiência Operacional: A análise de Big Data permite a otimização de operações, reduzindo custos e melhorando a eficiência.
- Tomada de decisão Baseada em Evidência
- Tomada de Decisão Baseada em Evidências: Com o Big Data, as decisões podem ser mais informadas e baseadas em análises profundas de tendências de mercado e comportamentos de consumidores
- Previsão e Modelagem
- Previsão e Modelagem: Big Data é essencial para prever tendências futuras e comportamentos, permitindo que as empresas se preparem melhor para o que está por vir.
- COLETA E GERENCIAMENTO DE DADOS
- No contexto do Big Data, a coleta, limpeza, preparação e armazenamento de dados são etapas cruciais que determinam a qualidade e a utilidade das análises realizadas. Este módulo aborda métodos eficazes para coletar dados em grande escala, técnicas para limpar e preparar esses dados para análise, e estratégias para armazenar e gerenciar esses dados de forma eficiente
- CARACTERÍSTICAS
- • Volume: A quantidade de dados gerados por empresas, dispositivos, sensores e mais. • Velocidade: A rapidez com que os dados são produzidos e precisam ser processados. • Variedade: Os diferentes tipos de dados, desde dados estruturados até dados não estruturados como e-mails, vídeos e fotos. • Veracidade: Refere-se à qualidade e à precisão dos dados. Dados imprecisos podem levar a conclusões errôneas, portanto, a veracidade é crucial para garantir a confiabilidade na tomada de decisões. • Valor: O potencial de valor dos dados. Big Data por si só não é útil a menos que possa ser transformado em insights valiosos que podem levar a uma vantagem competitiva ou resolver problemas específicos. Com a evolução do campo, outros Vs foram adicionados para refletir mais desafios e características do Big Data:• Visibilidade: A habilidade de visualizar dados de maneira que seja compreensível e acionável.• Variabilidade: A inconsistência dos dados que pode aparecer devido à diversidade de fontes de dados e ao contexto dinâmico em que são gerados.• Volatilidade: O tempo durante o qual os dados permanecem relevantes e o quão rápido eles precisam ser processados antes de perderem seu valor.• Os 3 Vs que levaram à criação da tecnologia para lidar com aquilo que os SGBDs tradicionais não davam conta
- 3 Vs
- 5 Vs
- 8 Vs
- visibilidade
- Visibilidade: A habilidade de visualizar dados de maneira que seja compreensível e acionável.
- Ferramentas de visualização de dados ajudam as organizações a entender grandes volumes de informações através de dashboards e gráficos
- variabilidade
- Variabilidade: A inconsistência dos dados que pode aparecer devido à diversidade de fontes de dados e ao contexto dinâmico em que são gerados
- Em análises de sentimentos, a variabilidade pode ser vista na forma como as pessoas expressam sentimentos semelhantes de maneiras diferentes.
- volatilidade
- Volatilidade: O tempo durante o qual os dados permanecem relevantes e o quão rápido eles precisam ser processados antes de perderem seu valor
- Em mercados financeiros, dados de preços de ações precisam ser processados rapidamente pois seu valor pode mudar em questão de segundos
- VISCOSIDADE
- se refere à resistência ao fluxo de dados dentro de um sistema, impactando como os dados são capturados, processados e analisados.
- Embora “viscosidade” não seja um dos “Vs” mais frequentemente citados ao lado de Volume, Velocidade, Variedade, Veracidade e Valor, ele oferece uma perspectiva valiosa sobre as características físicas e técnicas do gerenciamento de dados. Este conceito ajuda a destacar os desafios práticos enfrentados ao lidar com grandes volumes de dados em ambientes dinâmicos e multifacetados.
- pegajosidade
- A “pegajosidade” ou consistência dos dados, influenciando como os dados se movem ou são transferidos de um sistema para outro. Como a inércia dos dados afeta sua capacidade de serem atualizados, movimentados ou processados eficientemente. A velocidade com que os dados mudam ou a frequência com que precisam ser atualizados para manter sua relevância.
- Impacto da viscosidade
- desempenho do sistema
- Alta viscosidade pode levar a atrasos na análise de dados e na tomada de decisão, especialmente em cenários que exigem respostas rápidas baseadas em dados atualizados
- custo de processamento
- Sistemas com dados de alta viscosidade podem exigir mais recursos computacionais ou soluções mais complexas para garantir que os dados fluam suavemente e estejam prontos para análise quando necessário.
- desempenho do sistema
- Exemplos práticos de viscosidade
- transmissão de dados em tempo real
- Em sistemas que dependem de streaming de dados em tempo real, como monitoramento de tráfego ou análise de mídias sociais, a viscosidade pode se referir à latência na transmissão de dados. Uma alta viscosidade significa maior latência, o que pode retardar o processamento e a análise
- integração de dados de fontes múltiplas
- Em ambientes empresariais, onde os dados precisam ser integrados de várias fontes diferentes (ERP, CRM, bancos de dados online, etc.), a viscosidade pode descrever as dificuldades técnicas e logísticas de harmonizar dados que estão em formatos diferentes ou que têm diferentes requisitos de tempo real.
- transmissão de dados em tempo real
- Infraestrutura para processamento
- Hardware especializado
- Hardware Especializado: Servidores de alto desempenho, armazenamento escalável e redes de alta velocidade são cruciais para lidar com as demandas de processamento e armazenamento do Big Data
- Frameworks de processamento distribuído
- Frameworks de Processamento Distribuído: Tecnologias como Hadoop e Spark permitem o processamento de dados distribuído em clusters de computadores, utilizando eficientemente seus recursos para processar e analisar grandes volumes de dados
- Data Lakes
- Uma arquitetura de data lake armazena grandes quantidades de dados brutos em seu formato nativo até que seja necessário. Essa estrutura é altamente escalável e suporta o armazenamento de dados não estruturados, como logs, imagens e vídeos.
- Plataforma e ferramentas populares
- Diversas plataformas e ferramentas foram desenvolvidas para auxiliar na manipulação e análise de Big Data:
- Hadoop
- Plataforma de código aberto, utiliza cluster, fornece armazenamento, processamento, acesso, governança, segurança e operações de dados
- Um framework de software que suporta o processamento distribuído de grandes conjuntos de dados em clusters de computadores usando modelos de programação simples.
- É composto por: • HDFS (Hadoop Distributed File System): Para armazenamento de dados. • MapReduce: Um modelo de processamento para grandes volumes de dados. • YARN (Yet Another Resource Negotiator): Para gerenciamento de recursos do cluster. • Apache Spark: Uma plataforma de computação em cluster que fornece uma API para programação distribuída. É notável por realizar processamento em memória, o que o torna mais rápido que o Hadoop para certas aplicações
- cluster
- arquitetura que aglomera vários computadores para trabalharem em conjunto
- HDFS
- Armazenamento escalável e tolerante a falhas, custo eficiente, grande quantidade de cluster, escalável
- O Hadoop Distributed File System (HDFS) fornece armazenamento escalável e tolerante a falhas, o custo-eficiente para o seu lago de dados grande. Ele foi projetado para abranger grandes clusters de servidores de commodities escalar até centenas de petabytes e milhares de servidores. Ao distribuir o armazenamento através de muitos servidores, o recurso de armazenamento combinado pode crescer linearmente com a demanda permanecendo econômica em cada quantidade de armazenamento.
- NameNode
- NameNode é o componente central do HDFS e é responsável por gerenciar o sistema de arquivos distribuído. Ele mantém um registro completo dos metadados, como nomes de arquivos, localização dos blocos de dados e permissões de acesso.
- alta disponibilidade
- O objetivo da alta disponibilidade HDFS (Hadoop Distributed File System) é reduzir o tempo de ciclo necessário para trazer de volta um novo NameNode primário após a falha do primário existente.
- NoSQL Databases
- Bancos de dados NoSQL, como MongoDB, Cassandra e Couchbase, são projetados para escalar horizontalmente e são ideais para armazenar e recuperar dados não estruturados ou semi-estruturados
- TRABALHA COM DADOS ESTRUTURADOS E NÃO ESTRUTURADOS
- Apache Spark
- * Suporta mais do que apenas as funções de Map e Reduce; * Otimiza o uso de operadores de grafos arbitrários; *Avaliação sob demanda de consultas de Big Data contribui com a otimização do fluxo global do processamento de dados; * Fornece APIs concisas e consistentes em Scala, Java e Python; * Oferece shell interativo para Scala e Python. * O shell ainda não está disponível em Java
- Banco de dados para BIG Data
- NoSQL Database
- Flexibilidade: Não requerem um esquema fixo, o que permite armazenar diferentes tipos de dados. • Escalabilidade: Projetados para escalar horizontalmente, e são capazes de lidar com volumes muito grandes de dados. • Tipos: Chave-valor, documentos, colunas largas, grafos. • Exemplos: MongoDB (documentos), Cassandra (colunas largas), Neo4j (grafos).
- NoSQL
- O PostgreSQL é um SGBD ou Sistema de Gerenciamento de Bancos de Dados objeto-relacional de uso geral, um dos mais avançado sistema de banco de dados de código aberto existente do mercado. Já o sistema NoSQL, se refere a tipos não relacionais de bancos de dados, e esses bancos de dados armazenam dados em um formato diferente das tabelas relacionais. No entanto, os bancos de dados NoSQL podem ser consultados usando APIs de linguagem idiomática, linguagens de consulta estruturadas declarativas e linguagens de consulta, por exemplo, razão pela qual também são chamados de bancos de dados "não apenas SQL
- API's
- SQL Databases
- Estruturados: Adequados para dados que se encaixam bem em modelos tabulares rígidos. • Transações: Suportam operações de transação complexas com integridade de dados e consistência. • Exemplos: PostgreSQL, MySQL, Oracle Database
- NoSQL Database
- APLICAÇÃO DE BIG DATA
- 6. Aplicações de Big Data Big Data tem um vasto leque de aplicações em diversos setores, revolucionando a maneira como as organizações operam, tomam decisões e inovam. Este módulo explora como o Big Data está sendo utilizado em diferentes indústrias, no governo e em conjunto com a Internet das Coisas (IoT). 6.1 Big Data na Indústria: Saúde, Finanças, Varejo e Mais O impacto do Big Data se estende por várias indústrias, cada uma utilizando esses vastos conjuntos de dados de maneiras que melhoram a eficiência e a inovação. • Saúde: Big Data está transformando o setor de saúde ao melhorar o diagnóstico de doenças, personalizar tratamentos e otimizar a gestão hospitalar. Análise de grandes volumes de dados médicos ajuda na pesquisa e desenvolvimento de novos tratamentos e na prevenção de doenças através da identificação de padrões e riscos de saúde. • Finanças: Na indústria financeira, Big Data é usado para análise de riscos, detecção de fraudes, e personalização de serviços financeiros. Bancos e seguradoras utilizam algoritmos avançados para analisar o comportamento de compra dos clientes e ajustar suas ofertas de produtos. • Varejo: Comerciantes utilizam Big Data para entender melhor as preferências dos consumidores, otimizar a logística e gerir os estoques de maneira mais eficiente. Análises preditivas ajudam a prever tendências de mercado, otimizar preços e melhorar a experiência do cliente. 6.2 Big Data no Governo e Políticas Públicas Big Data oferece ferramentas poderosas para governos na formulação de políticas públicas, gestão urbana e segurança pública. • Formulação de Políticas: Análise de Big Data ajuda governos a criar políticas mais eficazes, baseadas em evidências reais. Isso inclui tudo desde políticas de saúde pública até estratégias econômicas. Big Data 12 ALFACON • Gestão Urbana: Cidades inteligentes utilizam Big Data para melhorar a infraestrutura urbana, como tráfego, serviços públicos e planejamento urbano, resultando em cidades mais eficientes e habitáveis. • Segurança Pública: Big Data é usado para melhorar a resposta a emergências, prevenção de crimes e monitoramento de áreas públicas, aumentando assim a segurança e bem-estar dos cidadãos. 6.3 Big Data e a Internet das Coisas (IoT) A combinação de Big Data com IoT está abrindo novas fronteiras para a análise de dados em tempo real e a automação. • Dispositivos Conectados: IoT envolve a conexão de dispositivos físicos à internet, que geram continuamente grandes quantidades de dados. Esses dados, quando analisados, podem melhorar significativamente a eficiência operacional e oferecer novos insights. • Automatização e Monitoramento: Em indústrias como manufatura e agricultura, IoT e Big Data são usados para monitorar e automatizar processos, melhorar a qualidade e a produção, e reduzir custos operacionais. • Análise Predominante: A integração de Big Data com IoT facilita a manutenção preditiva, que usa dados históricos e em tempo real para prever falhas em equipamentos antes que elas ocorram.
- TENDENCIAS FUTURAS EM BIG DATA
- 7. Tendências Futuras em Big Data À medida que a tecnologia continua avançando, o campo do Big Data também evolui, apresentando novos desenvolvimentos e influenciando diversas áreas da sociedade e da economia. Este módulo explora as principais tendências que moldarão o futuro do Big Data, incluindo inovações tecnológicas, o papel crescente da inteligência artificial e as mudanças no mercado de trabalho. 7.1 Desenvolvimentos Emergentes em Tecnologias de Big Data O futuro do Big Data será marcado por avanços significativos em tecnologia, que facilitarão a coleta, o processamento e a análise de dados em escalas anteriormente inimagináveis. • Edge Computing: Para lidar com a latência e os custos de transferência de grandes volumes de dados, a computação em borda (edge computing) processa dados mais perto de onde são gerados. Isso é especialmente relevante para aplicações IoT, onde dispositivos geram grandes quantidades de dados em tempo real. • Data Fabric e Data Mesh: Conceitos emergentes como data fabric e data mesh estão ganhando tração para oferecer uma arquitetura de dados mais flexível e descentralizada, facilitando o acesso e a compartilhamento de dados em grandes organizações. • Blockchain e Segurança de Dados: A aplicação de tecnologias blockchain para gerenciar grandes conjuntos de dados promete melhorar a segurança, a transparência e a integridade dos dados. 7.2 O Impacto da Inteligência Artificial e Aprendizado de Máquina A inteligência artificial (IA) e o aprendizado de máquina (ML) estão no coração da próxima onda de inovações em Big Data, transformando a forma como os dados são analisados e utilizados. • Automação de Análise de Dados: Algoritmos de ML estão permitindo a automação de complexas análises de dados, reduzindo a necessidade de intervenção humana e aumentando a eficiência. • IA Explicativa: À medida que a IA se torna mais integrada às decisões de negócios, surge uma demanda crescente por sistemas de IA explicativa, que podem detalhar como as decisões são feitas, aumentando a confiança nas análises baseadas em IA. • Personalização em Massa: A IA permite a personalização de produtos e serviços em escala, oferecendo experiências altamente adaptadas às necessidades e preferências individuais dos usuários. 7.3 O Futuro do Trabalho com Big Data As mudanças trazidas pelo Big Data também estão redefinindo o mercado de trabalho, criando novas oportunidades e desafios. • Crescente Demanda por Profissionais de Dados: Há uma necessidade crescente de profissionais especializados em dados, incluindo cientistas de dados, engenheiros de dados e analistas de dados, que possuem as habilidades para gerenciar e interpretar grandes volumes de informações. • Educação e Treinamento: À medida que o Big Data se torna mais central para as operações de negócios, a educação e o treinamento em análise de dados e ferramentas relacionadas se tornam essenciais para uma ampla gama de profissões. • Mudanças nas Habilidades Profissionais: As habilidades necessárias para trabalhar eficazmente com Big Data estão evoluindo, incluindo capacidades em estatística, programação, análise crítica e pensamento estratégico
- PROCESSAMENTO E ANÁLISE DE BIG DATA
- 5. Processamento e Análise de Big Data Para transformar grandes volumes de dados brutos em insights úteis e acionáveis, é essencial compreender e aplicar técnicas de processamento e análise de dados adequadas. Este módulo aborda o processamento paralelo e distribuído, explora métodos avançados de análise de dados, como machine learning e data mining, e discute a importância da visualização de dados no contexto do Big Data. 5.1 Introdução ao Processamento Paralelo e Distribuído O processamento paralelo e distribuído é fundamental para lidar com o Big Data, permitindo que grandes volumes de dados sejam processados de maneira eficiente e em tempo hábil. Processamento Paralelo: Envolve a execução de múltiplas operações ao mesmo tempo, dividindo tarefas grandes em partes menores que são processadas simultaneamente em múltiplos processadores. Processamento Distribuído: Consiste na distribuição de dados e tarefas de processamento através de múltiplos sistemas interconectados ou nodos, o que ajuda a aumentar a velocidade de processamento e a resiliência do sistema. Tecnologias-chave: • Apache Hadoop: Um framework que permite o processamento distribuído de grandes conjuntos de dados em clusters de computadores usando modelos de programação simples. • Apache Spark: Uma plataforma de computação em cluster que oferece uma API para programação distribuída, famosa por seu desempenho superior em processamento em memória. 5.2 Análise Avançada de Dados: Machine Learning e Data Mining A análise avançada de dados no Big Data envolve técnicas sofisticadas que permitem extrair padrões, detectar tendências e fazer previsões. Machine Learning: Algoritmos de aprendizado de máquina são usados para modelar e prever comportamentos, identificar padrões e tomar decisões com mínima intervenção humana. Inclui métodos como aprendizado supervisionado, não supervisionado e reforçado. Data Mining: O processo de descobrir padrões e relacionamentos ocultos em grandes volumes de dados. Utiliza técnicas estatísticas, de mineração de associação, de clustering e de detecção de anomalias. Aplicações: • Previsão de Comportamento do Consumidor: Usando machine learning para analisar dados de compra e personalizar ofertas. • Detecção de Fraude: Aplicação de algoritmos para identificar atividades suspeitas em transações financeiras. 5.3 Visualização de Dados em Big Data A visualização de dados é uma ferramenta crucial para a interpretação eficaz de resultados complexos de Big Data, permitindo que os usuários vejam padrões e insights de forma intuitiva. Ferramentas de Visualização: • Tableau: Uma plataforma poderosa que permite criar visualizações interativas e compartilháveis. • Power BI da Microsoft: Oferece uma gama de opções de visualização e integração de dados para visualizar e analisar informações em tempo real. • Dashboards de Dados: Usados para monitorar KPIs (Indicadores Chave de Performance) e outras métricas importantes em tempo real. Benefícios: • Compreensão Rápida: Permite que stakeholders compreendam tendências e resultados complexos rapidamente. • Tomada de Decisão Informada: Facilita a tomada de decisões baseada em dados visualizados de forma clara e compreensível.
- Hardware especializado
- visibilidade
- veracidade
- Veracidade: Refere-se à qualidade e à precisão dos dados. Dados imprecisos podem levar a conclusões errôneas, portanto, a veracidade é crucial para garantir a confiabilidade na tomada de decisões
- No setor financeiro, a veracidade dos dados de transações é essencial para detectar e prevenir fraudes
- valor
- Valor: O potencial de valor dos dados. Big Data por si só não é útil a menos que possa ser transformado em insights valiosos que podem levar a uma vantagem competitiva ou resolver problemas específicos.
- Empresas de e-commerce analisam padrões de compra e feedback para oferecer recomendações personalizadas e melhorar as vendas
- 8 Vs
- Volume
- • Volume: Refere-se à quantidade massiva de dados gerados a cada segundo. O volume de dados excede a capacidade dos sistemas de gerenciamento de banco de dados tradicionais em termos de armazenamento e processamento
- Empresas de mídia social como Facebook e Twitter geram petabytes de dados todos os dias a partir de postagens e interações dos usuários.
- velocidade
- • Velocidade: A velocidade com que os dados são gerados e precisam ser processados é extremamente alta. Isso inclui a necessidade de processamento em tempo real para aplicações como monitoramento de mídia social, análise de transações financeiras e sensores IoT
- Sistemas de monitoramento de tráfego usam dados de sensores em tempo real para ajustar sinais de trânsito e rotas
- variedade
- Variedade: Os dados vêm em uma ampla gama de formatos – desde dados estruturados, como números e datas, até dados não estruturados, como texto, vídeo, e imagens.
- : Empresas de varejo processam dados de transações (estruturados), feedback de clientes (não estruturados), e dados de mídia social (não estruturados)
- 5 Vs
- Métodos de coleta de dados em grande escala
- A coleta de dados em grande escala pode ser desafiadora devido ao volume, à velocidade e à variedade dos dados. Algumas abordagens comuns incluem: • Sensores e IoT (Internet das Coisas): Dispositivos conectados, como sensores em máquinas industriais ou wearables, que geram contínuas correntes de dados. • APIs (Interfaces de Programação de Aplicações): Utilização de APIs para coletar dados de serviços de terceiros, como redes sociais, serviços financeiros ou meteorológicos. • Web Scraping: Técnica usada para extrair dados de websites de forma automatizada. É útil para coletar informações públicas como preços de produtos, notícias ou dados de mercado. • Transações e Logs de Servidores: Dados gerados a partir de transações comerciais ou logs de atividades em sistemas e servidores.
- Técnicas de limpeza e Preparação de dados
- A limpeza e preparação de dados são essenciais para garantir a precisão das análises. Algumas técnicas fundamentais incluem: :
- dentificação e Tratamento de Valores Faltantes
- • Identificação e Tratamento de Valores Faltantes: Utilizar métodos para preencher ou excluir dados faltantes, dependendo do contexto e da quantidade de dados ausentes.
- Normalização e Padronização
- Converter dados para um formato comum para facilitar análise, como padronizar datas, categorias e textos.
- Correção de Inconsistências e Erros:
- Correção de Inconsistências e Erros: Revisar e corrigir dados que são digitados incorretamente, duplicados ou que não seguem um formato padrão.
- Redução de Dimensionalidade
- Técnicas como análise de componentes principais (PCA) para reduzir o número de variáveis, mantendo as informações mais importantes.
- Armazenamento e Gerenciamento eficiente de dados
- O armazenamento e o gerenciamento eficientes de dados são críticos para lidar com o volume e a complexidade do Big Data: Data Warehouses e Data Lakes: • Data Warehouse: Estruturado para consultas e análise de dados. Ideal para dados que requerem processamento intensivo de transações. • Data Lake: Armazena grandes volumes de dados brutos em seu formato original. Mais adequado para dados não estruturados e para situações onde o esquema dos dados não é definido antecipadamente. Tecnologias de Armazenamento: • Soluções Baseadas em Nuvem: Plataformas como Amazon S3, Google Cloud Storage e Azure Data Lake oferecem escalabilidade, durabilidade e flexibilidade. • Bancos de Dados NoSQL: Como MongoDB, Cassandra e HBase, que são projetados para escalar horizontalmente e são ótimos para lidar com dados semi-estruturados e não estruturados. Segurança e Governança de Dados: Big Data 10 ALFACON Implementação de políticas de segurança rigorosas e ferramentas de governança para proteger os dados contra acessos não autorizados e garantir conformidade com as regulamentações de dados
- DEFINIÇÃO
- 1 - Data mining é uma disciplina crucial dentro da ciência de dados que envolve o processo de descobrir padrões e extrair informações úteis de grandes conjuntos de dados.
- 2 - Data mining é o processo de usar algoritmos, métodos estatísticos e técnicas de inteligência artificial para explorar e analisar grandes conjuntos de dados a fim de encontrar padrões e relações ocultas que possam ser úteis para a tomada de decisão.
- PROPÓSITO
- Descoberta de padrôes
- Identificar padrões e tendências que não são aparentes em análises superficiais
- Predição de futuras tendências
- Utilizar os dados históricos para prever eventos futuros, o que pode ser crucial para planejamento e otimização de negócios.
- Apoio à decisão
- Fornecer informações baseadas em dados que ajudem as empresas a tomar decisões mais informadas e baseadas em evidências
- IMPORTÂNCIA NA ERA BIG DATA
- Negócios
- mpresas usam data mining para entender melhor o comportamento do consumidor, otimizar operações e estratégias de marketing, e aumentar a vantagem competitiva
- Saúde
- : No setor de saúde, data mining ajuda na previsão de epidemias, na personalização de tratamentos para pacientes e na otimização da gestão hospitalar.
- Governo
- Governos aplicam técnicas de data mining para aprimorar serviços públicos, segurança e monitorar eficácia de políticas públicas.
- MÉTODOS E TÉCNICAS
- Classificação e Previsão
- * Classificação: Envolve a identificação de qual categoria uma novo observação pertence, baseando-se em um treinamento previamente realizado com um conjunto de dados onde as categorias são conhecidas. Algoritmos populares incluem árvores de decisão, redes neurais e máquinas de vetores de suporte (SVM).
- * Previsão: Foca em prever um resultado contínuo. Métodos comuns envolvem regressão linear e regressão logística, além de técnicas mais avançadas como florestas aleatórias e boosting.
- Agrupamento clustering
- Agrupamento, ou Clustering, é uma técnica de data mining que organiza objetos em grupos cujos membros são similares entre si mais do que com membros de outros grupos.
- exemplos
- • Exemplos de Algoritmos de Clustering: K-means, clustering hierárquico, e DBSCAN.
- aplicações
- • Aplicações: Desde segmentação de mercado, análise de redes sociais, organização de clusters computacionais, até a identificação de áreas com características similares em dados geográficos.
- Associação e Sequenciamento
- Regras de Associação são utilizadas para encontrar padrões interessantes, associações, correlações ou estruturas frequentes entre conjuntos de itens ou objetos em transações de dados ou outros sistemas de armazenamento. • Exemplo Famoso: Análise de cesta de compras, onde se verifica quais produtos tendem a ser comprados juntos.
- • Sequenciamento: Involucra a análise de sequências ou padrões de eventos que ocorrem frequentemente em ordem específica. Um exemplo comum é a análise de padrões de navegação em websites.
- Detecção de anomalias
- Detecção de Anomalias, também conhecida como detecção de outliers, busca identificar casos raros que se desviam significativamente do comportamento esperado.
- Utilização
- Amplamente usado em fraude bancária, defeitos de fabricação, monitoramento de condições em equipamentos e detecção de atividades suspeitas em redes de computadores.
- Técnicas
- Incluem métodos estatísticos, redes neurais, e sistemas baseados em proximidade, como k-nearest neighbors (k-NN).
- k-nearest neighbors (k-NN).
- k-nearest neighbors (k-NN) = faz previsões com base na proximidade de dados
- FERRAMENTAS E TECNOLOGIAS
- software e ferramentas
- Ajudam os analistas a extrair insights valiosos de grande volumes de dados. - WEKA (interface gráfica, adequada para desenvolvimento de novos sistemas de machine learning) - RapidMiner (ambiente integrado) - SAS data Mining (ideal para empresas, para solução robusta) - Python (SciKit-Learn, TensorFlow, PyTorch, codigo aberto, implementar modelos complexos)
- Aplicações em big Data e
- * Hadoop ( um framework que permite o processamento em conjuntos de dados em clusters de computadores usando modelos de programação simples). * Apache Spark ( Conhecido por sua capacidade de processar grandes volumes de dados de forma rápida e eficiente, Spark é ideal para trabalhos que exigem análises iterativas * Plataformas de Cloud (
- Cloud Computing
- Serviços como Amazon Web Services, Microsoft Azure e Google Cloud Platform oferecem poderosas capacidades de computação e armazenamento que permitem às empresas implementar e escalar suas operações de data mining sem a necessidade de infraestrutura física
- Integração com sistemas de Business Inteligence
- : Essas ferramentas de BI podem ser usadas para visualizar e comunicar os resultados do data mining, permitindo que os usuários finais explorem visualmente os padrões e as previsões produzidas pelos modelos de data mining. Automatização de Fluxos de Trabalho: A integração entre plataformas de data mining e sistemas de BI pode automatizar o fluxo de dados desde a coleta e análise até a geração de relatórios, aumentando a eficiência operacional.
- Tableau
- Power BI
- Qlik
- APLICAÇÕES PRÁTICAS
- Marketing e Vendas
- Finanças e Bancos
- Saúde e Medicina
- Governança e Adm Pública
- Tendências Futuras
- Avanços em Inteligência Artificial e Machine Learning
- Data Mining e IoT
- A expansão da IoT está criando novas oportunidades para o data mining, à medida que dispositivos conectados geram quantidades massivas de dados em tempo real.
- Edge Analytics
- • Edge Analytics: Com o aumento dos dispositivos IoT, a análise de dados está se movendo para a “borda” da rede, onde os dados são gerados e coletados, permitindo respostas mais rápidas e redução na necessidade de transmissão de grandes volumes de dados.
- Segurança e Monitoramento
- Segurança e Monitoramento: O data mining é aplicado para monitorar a integridade e o desempenho dos dispositivos IoT, além de identificar potenciais ameaças à segurança em tempo real.
- INOVAÇÕES EM ANÁLISE PREDITIVA E PRESCRITIVA
- modelos preditivos avançados
- : Os modelos estão se tornando mais sofisticados, utilizando dados históricos e em tempo real para prever eventos futuros com maior precisão.
- Análise prescritiva
- Esta forma avançada de análise não apenas prevê o que vai acontecer, mas também sugere ações que podem ser tomadas para aproveitar as previsões ou mitigar os riscos, integrando-se perfeitamente com sistemas de tomada de decisão automatizada.
- modelos preditivos avançados
- software e ferramentas
- Classificação e Previsão
- Negócios
- Descoberta de padrôes
- METADADOS
REDES DE COMPUTADORES
- Conjunto de módulos processadores capazes de trocar informações e também compartilhar recursos.
- ENDEREÇAMENTO IP
- Endereçamento IP não é atribuído à maquina, mas sim a interface de rede (pode ser atribuído + 1 IP se esse estiver conectado a +1 rede)
- Cada host (computador) e roteador na Internet tem um endereço IP que pode ser usado nos campos endereço de origem e endereço de destino dos pacotes IP, permitindo assim que os computadores (hosts) possam ser localizados na rede. É importante ressaltar que um endereço IP não se refere realmente a um host. Na verdade, ele se refere a uma interface de rede; assim, se um host estiver em duas redes, ele precisará ter dois endereços IP. Porém, na prática, a maioria dos hosts está conectada apenas a uma rede e, portanto, só tem um endereço IP. Ao contrário, os roteadores têm várias interfaces e, portanto, vários endereços IP.
- IPV4
- 32 bits
- CLASSE DE IP
- ISP é a sigla para Internet Service Provider, que em português significa Provedor de Serviços de Internet.
- IPV6
- 128 bits
- ARQUITETURA DE PROTOCOLOS
- TCP/IP
- Camadas do TCP/IPNão há um modelo de protocolo TCP/IP oficial, assim como no caso da OSI. Portanto, o TCP/IP pode ser descrito com 4 ou 5 camadas.Modelo organizado em 5 camadas: Camada de Aplicação• Camada de Transporte• Camada de rede (internet)• Camada de Enlace (acesso à rede)• Camada Física
- TCP é a sigla para Transmission Control Protocol, ou Protocolo de Controle de Transmissão, que é um padrão de comunicação que permite a troca de mensagens entre dispositivos e aplicativos de computação em uma rede
- APLICAÇÃO
- Todos protocolos da camada de aplicação precisam de um protocolo na camada de transporte.
- HTTP HTTPS
- HTTP
- HTTP -> TCP ( porta 80 ) Transferir páginas de internet servidor -> cliente Cliente->Servidor Navegador -Mozilla Firefox -Google Chrome -Microsolft Edge -Internet Explore
- HTTPS TCP
- HTTPS-> TCP (porta 443) transferir páginas de internet de forma segura (criptografia -certificação digital no site) CADEADO NO ENDEREÇO URL OU BARRA DE ENDEREÇO VERTE Certificados digitais SSL TLS (AUTENTICAÇÃO, CRIPTOGRAFIA, INTEGRIDADE)
- HTTPS FTP
- HTTP
- TFTP
- Bem mais simples que o FTP adequado para diretórios de arquivos públicos UDP PORTA 69
- O protocolo TFTP é bem mais simples que o FTP. Não existem provisões para controle de acesso ou identificação do usuário, de modo que o TFTP só é adequado para diretórios de arquivos de acesso público. Devido à sua simplicidade, o TFTP é implementado de modo fácil e compacto. O TFTP roda em cima do UDP na porta 69.
- POP3
- POP3 (POST OFFICE PROTOCOL, VERSÃO 3) - Recebimento de e-mail - Simples ( baixa mensagem-> Armazena no computador -> Apaga mensagem original) Fases 1) Autorização ( USER e PASS ) 2) Transação ( recupera mensagem, marcação ) 3) Atualização ( após comando quit ) TCP PORTA 110 ^ PORTA 995 (conexões criptografadas SSL ou TSL)
- O POP3 é um protocolo de recebimento de e-mail, ou seja, sua função é buscar as mensagens de um servidor. Por ser muito simples, geralmente era utilizado para baixar as mensagens do servidor, armazená-las no computador do usuário e então excluir a mensagem original do servidor. Esse protocolo não provê nenhum meio para um usuário criar pastas remotas e designar mensagens a pastas. O funcionamento do protocolo POP3 passa por três fases: autorização (a fase de autorização tem dois comandos principais: user e pass ), transação e atualização. Durante a primeira fase, autorização, o agente de usuário envia um nome de usuário e uma senha para autenticar o usuário. Na segunda fase, transação, recupera mensagens; é também nessa fase que o agente de usuário pode marcar mensagens que devem ser apagadas, remover essas marcas e obter estatísticas de correio. A terceira fase, atualização, ocorre após o cliente ter dado o comando quit que encerra a sessão POP3. Nesse momento, o servidor de correio apaga as mensagens que foram marcadas. O protocolo POP3 trabalha sobre o TCP na porta 110. No entanto, deve-se usar a porta 995 em conexões criptografadas via SSL (Secure Sockets Layer) ou TSL (Transport Layer Security).
- IMAP
- IMAP (INTERNET MESSAGE ACCESS PROTOCOL) - Acesso a mensagem eletrônica- Mantém no servidor -> Acesso por diferentes dispositivos- Mensagem em software cliente-visualização - online e offline. -exclusão/alteração - somente onlineTCP PORTA 143^ PORTA 993 ( CONEXÕES CRIPTOGRAFADAS SSL OU TSL)
- É um protocolo de acesso a mensagens eletrônicas. Tem como característica manter as mensagens no servidor, de modo que elas possam ser acessadas em diferentes dispositivos. O protocolo IMAP provê comandos que permitem que os usuários criem pastas e transfiram mensagens de uma para outra. O protocolo também provê comandos que os usuários podem usar para pesquisar pastas remotas em busca de mensagens que respeitem critérios específicos. É importante ressaltar que, ao acessar as contas de e-mail por um software cliente, as mensagens são armazenadas em cache na máquina local, o que permite visualizá-las no modo offline ou desconectado. No entanto, as alterações feitas nesse momento não são refletidas no servidor, ou seja, para excluí-las ou alterá-las, é preciso sempre estar online. Trabalha sobre o TCP na porta 143. Já em conexões seguras SSL/TLS, a porta de comunicação utilizada é a 993.
- SMTP
- SMTP (SIMPLE MAIL TRANSFER PROTOCOL) Transferir mensagem Servidor remetente -> Servidor destinatário TCP porta 25 substituída pela porta 587 Porta 465 (conexão segura SSL)
- Conforme já mencionado anteriormente, o protocolo SMTP é utilizado para transferir mensagens de correio eletrônico do servidor de correio do remetente para o servidor de correio do destinatário, ou seja, é o protocolo padrão para o envio de e-mails. Trabalha sobre o TCP na porta 25. Porém, seguindo uma recomendação do Comitê Gestor da Internet (CGI.br) que visa dificultar a disseminação de spams na internet, a porta 587 passou a substituir a porta 25 nos programas cliente de e-mails. Além disso, o protocolo SMTP ainda pode utilizar a porta 465 fazendo uso de uma conexão segura SSL (Secure Sockets Layer).
- DNS
- DNS (DOMAIN NAME SYSTEM) - Permitem que hospedeiros consultem banco de dados distribuído finalidade de traduzir para endereço IP. -UDP porta 53- Pode em casos específicos TCP
- É um protocolo de camada de aplicação que permite que hospedeiros consultem o banco de dados distribuído com a finalidade de traduzir nomes de hospedeiro para endereços IP. O DNS trabalha tipicamente com o protocolo UDP na porta 53, no entanto, em casos específicos, pode utilizar TCP na mesma porta (53). Aplicação WEB Você já parou para pensar o que acontece quando um usuário digita um endereço URL, como, por exemplo, http://www.alfaconcursos.com.br no navegador? Vamos lá: A máquina do usuário executa o lado cliente da aplicação DNS. Sendo assim, o navegador extrai o nome do hospedeiro, http://www.alfaconcursos.com.br, do URL e, em seguida, o cliente DNS envia uma consulta contendo o nome do hospedeiro para um servidor DNS. Realizada a consulta, o cliente DNS finalmente recebe uma resposta do servidor DNS, que inclui o endereço IP correspondente ao nome de hospedeiro, permitindo assim que o navegador possa abrir uma conexão com o servidor Web que hospeda a página desejada. Portanto, baseado na utilização do protocolo DNS e no funcionamento de um banco de dados distribuído implementando uma hierarquia de servidores de nomes (servidores DNS), é possível acessar conteúdos na Internet conhecendo apenas nomes em vez de números (endereços IP).
- TELNET
- Permite logon remoto TCP porta 23
- É um protocolo que oferece uma capacidade de logon remoto, que permite que um usuário em um terminal ou computador pessoal efetue logon com um computador remoto e funcione como se estivesse conectado a esse computador. O protocolo Telnet trabalha sobre o TCP na porta 23.
- SSH
- Estabelece conexões de acesso remoto criptografadas. TCP PORTA 22
- Diferentemente do protocolo Telnet, o protocolo SSH estabelece conexões de acesso remoto criptografadas. Trabalha sobre o TCP na porta 22.
- A. S. EMAIL
- WEBMAIL (E-MAIL PELA WEB) Arquitetura do sistema de e-mail
- Atualmente, um número cada vez maior de usuários está enviando e acessando e-mails por meio de seus browsers (navegadores). Esse serviço é conhecido como Webmail. Com esse serviço, o agente de usuário é um browser comum e o usuário se comunica com a sua caixa postal remota via HTTP ou HTTPS. Sendo assim, quando um destinatário de um e-mail quer acessar uma mensagem em sua caixa postal, o protocolo que será utilizado para transferir a mensagem do servidor para o browser do usuário será o HTTP/HTTPS, ou seja, acessando e-mails via browsers os protocolos POP3 e IMAP não serão utilizados pelo agente de usuário. E o SMTP será utilizado pelo browser para enviar e-mails? Não. O envio da mensagem do browser para o servidor de correio será realizado pelo HTTP/HTTPS. Contudo, os servidores continuarão trocando mensagens com outros servidores por meio do protocolo SMTP.
- MUA
- MUA (Agente de mensagem do usuário) Programa utilizado ENVIA/LER MENSAGEM POP3 e IMAP Mozilla Thunderbird e Microsolft outlook
- MTA
- MTA (agente de transferência de mensagem) - Responsável por enviar/receber e-mail - Correio eletrônico - SMTP
- webmail
- - Acesso a e-mail por meio de navegadores. - Agente de usuário (browser comum)-> Comunicação com caixa postal remota (http e https)
- SNMP
- SNMP (SIMPLE NETWORK MANAGEMENT PROTOCOL) PROTOCOLO DE GERENCIAMENTO DE REDE SIMPLES -CONFIGURAR- MONITORA O DESEMPENHO DA REDE UDP PORTA 161
- Protocolo de gerenciamento de rede simples (SNMP). É com o protocolo SNMP, que os administradores podem gerenciar e configurar elementos de rede de um servidor localizado centralmente em vez de ter que executar o software de gerenciamento de rede. Também é possível usar o SNMP para monitorar o desempenho da rede, detectar problemas de rede e acompanhar quem usa a rede e como ela é usada. O SNMP trabalha por padrão com o protocolo UDP na porta 161.
- TRANSPOTE
- CAMADA DE TRANSPORTEAcamada de transporte reúne os protocolos que realizam as funções de transporte de dados fima fim, ou seja, considerando apenas a origem e o destino da comunicação, sem se preocupar com os elementos intermediários. Um pacote de camada de transporte será denominado segmento.Os protocolos de transporte são executados nos sistemas finais: Lado emissor: quebra as mensagens da aplicação em segmentos e envia para a camada de rede; Lado receptor: remonta os segmentos em mensagens e passa para a camada de aplicação.Na camada de transporte encontramos os protocolos UDP(User Datagram Protocol) e TCP(Transmission Control Protocol).
- - Reúne os protocolos que realizam as funções de transporte de dados ( origem <-> destino ) Pacote -> segmento - Protocolos -> Executados nos sistemas finais * Lado emissor -> quebra mensagem -> envia rede * Lado receptor -> remonta segmentos -> envia aplicação. DADOS -> Receptor-> recebe ordenados ou não, mas a camada de transporte entrega para a camada de aplicação ordenados
- Dados
- TCP
- protocolo TCP, ao contrário do UDP, é um protocolo orientado à conexão. Quando um processo no local A quer enviar e receber dados de outro processo no local B, as três fases seguintes ocorrem: 1.As duas camadas TCP estabelecem uma conexão lógica entre elas; 2.Os dados são trocados em ambas as direções; 3.A conexão é finalizada. Perceba que essa é uma conexão lógica, não física. O segmento TCP é encapsulado em um datagrama IP e pode ser enviado fora de ordem, perdido ou corrompido e depois reenviado. Cada segmento pode ser encaminhado por um caminho diferente até chegar ao destino. Não há uma conexão física.
- CONEXÃO TCP é orientado à conexão. Conforme discutido anteriormente, um protocolo de transporte orientado à conexão estabelece um caminho lógico entre a origem e o destino. Todos os segmentos pertencentes a uma mensagem são, então, enviados por meio desse caminho lógico. O uso de um único caminho lógico para toda a mensagem facilita o processo de confirmação, bem como a retransmissão de quadros danificados ou perdidos
- CONTROLE DE ERROS O TCP é um protocolo confiável da camada de transporte. Isso significa que um aplicativo que entrega um fluxo de dados para o TCP confia no TCP para entregar todo o fluxo para o aplicativo na outra extremidade de modo ordenado, sem erros e sem qualquer parte perdida ou duplicada. O TCP fornece confiabilidade usando controle de erros, que inclui mecanismos para detectar e reenviar segmentos corrompidos, reenviar segmentos perdidos, armazenar segmentos fora de ordem até que os segmentos faltantes cheguem e detectar/descartar segmentos duplicados. O controle de erros no TCP é conseguido por meio do uso de três ferramentas: soma de verificação (checksum), confirmação e tempo-limite.
- SEGMENTOS FORA DE ORDEM As implementações atuais do TCP não descartam segmentos fora de ordem. Elas os armazenam temporariamente e os marcam como segmentos fora da ordem até que os faltantes cheguem. Note, no entanto, que os segmentos fora de ordem nunca são entregues ao processo da camada de aplicação. O TCP garante que os dados sejam enviados ordenadamente para o processo. IMPORTANTE - Os dados podem chegar fora de ordem no receptor TCP, mas o TCP garante que nenhum dado fora de ordem seja entregue ao processo.
- * CONFIÁVEL * MAIS DEMORADO
- UDP
- O protocolo UDP oferece um serviço não orientado à conexão. Portanto, cada datagrama enviado pelo usuário é um datagrama UDP independente. Os datagramas de usuário não são numerados. Além disso, ao contrário do TCP, não há estabelecimento de conexão e não há finalização da conexão, ou seja, cada datagrama de usuário pode viajar por um caminho diferente.O UDP é um protocolo muito simples. Não há controle de fluxo. Sendo assim, o receptor pode ficar sobrecarregado com as mensagens recebidas. Outra característica do UDP é o fato de não existir um mecanismo de controle de erros fazendo com que o emissor fique sem saber se o pacote foi perdido, por exemplo
- * NÃO CONFIÁVEL * MAIS RÁPIDO
- REDE
- A camada de rede da Internet é responsável pela movimentação, de uma máquina para outra, de pacotes de camada de rede conhecidos como datagramas. A camada de rede realiza a função de roteamento que consiste no transporte de datagramas entre redes e na decisão de qual rota um datagrama deve seguir através da estrutura de rede para chegar ao destino. O principal protocolo dessa camada é o protocolo IP(Internet Protocol)
- - Responsável pela movimentação dos pacotes ( datagramas )da camada de rede - Roteamento ( rota do datagrama origem->destino, protocolo->Ip.
- ENLANCE
- - Como enviar mensagem (confiabilidade) - A camada de rede depende dos serviços da camada de enlance - passa de nó para nó os pacotes na rede - pacote quadros * via ethernet (802.3) cabeado * WI-FI (802.11)
- A camada de enlace trata de como enviar mensagens de tamanho definido entre computadores diretamente conectados, com níveis de confiabilidade especificados. De acordo com ofuncionamento da hierarquia em camadas, a camada de rede depende dos serviços da camada de enlace. Sendo assim, em cada nó, a camada de rede passa o pacote para a camada de enlace, que o entrega, ao longo da rota, ao nó seguinte, no qual o pacote é passado da camada de enlace para a de rede. Os pacotes de camada de enlacesão denominados quadros. Ethernet(802.3)e 802.11(WI-FI)são exemplos de padrões da camada de enlace
- ENLANCE = INTERFACE DE REDE OU ACESSO À REDE
- FÍSICA
- Como transmite os bits - sinais elétricos, luminosos ( características do meio de transmissão)
- A camada física especifica como transmitir os bits por diferentes tipos de mídia como sinais elétricos ou sinais luminosos, por exemplo. Sendo assim, a camada física trata da especificação das características do meio de transmissão, da natureza dos sinais, da taxa de dados e de questões relacionadas.
- OSI
- 2.1 Camada físicaEssa camada trata da transmissão do fluxo de bits não estruturado pelo meio físico; lida com características mecânicas, elétricas, funcionais e de procedimento para acessar o meio físico.2.2 Camada de enlace de dadosOferece a transferência confiável de informações pelo enlace físico; envia blocos (quadros) com sincronismo, controle de erro e controle de fluxo necessários.2.3 Camada de redeOpera basicamente com endereços de rede, que são globais por natureza, como o endereço IP. Essa camada é a respon-sável pelo roteamento dos dados, ou seja, o encaminhamento dos pacotes pela rede e é completamente independente do meio de transmissão, garantindo assim o roteamento dos pacotes por redes heterogêneas.2.4 Camada de transporteA função básica da camada de transporte é aceitar dados da camada acima dela, dividi-los em unidades menores, se for preciso, repassar essas unidades à camada de rede e garantir que todos os fragmentos chegarão corretamente à outra extremidade, ou seja, é responsável por realizar a troca de pacotes entre sistemas que estão se comunicando, sem se preocupar com o roteamento, que é executado pela camada de rede. 2.5 Camada de sessãoUma das principais funções da camada de sessão é sincronizar o diálogo, ou seja, a recepção com a transmissão. Essa camada ainda tem a capacidade de recuperar conexões de transporte sem perder a conexão de sessão.2.6 Camada de apresentaçãoA função da camada de apresentação é traduzir formatos e sintaxes, para que possam ser compreendidos pelos dois subsistemas que estão se comunicando. Outra função executada nessa camada é a compressão e criptografia dos dados de forma transparente à camada de aplicação.2.7 Camada de aplicaçãoEssa camada disponibiliza às aplicações os meios para acessar o ambiente de comunicação realizando, portanto, a interface entre o protocolo de comunicação e o aplicativo utilizado na rede. Os serviços mais comuns incluem correio eletrônico, transferência de arquivos e transferência de páginas de internet.
- TCP/IP
- TIPOS DE REDES
- PAN
- - Personal area network Permite que dispositivos se comuniquem pelo alcance de uma pessoa. Ex. Bluetooth (sem fio e curto alcance) Para se conectar um mouse a uma computador sem fio
- WPAN
- WIRELLES
- LAN
- Lan (Local area network) É o tipo mais comum de rede. Rede de pequena proporção que eu tenho em casa, escritório. Ethernet (IEEE 802.3) rede cabeada
- WLAN
- - Wirelles local area network (área local de rede sem fio) WI-FI (IEEE 802.11)
- VLAN
- AREA DE REDE LOCAL VIRTUAL
- CAN
- CAMPOS AREA NETWORK Chamada de rede de campo, é uma rede maior que a rede local, é composta de pelo menos duas redes locais interligadas. Ex. redes de universidades, hospitais.
- MAN
- METROPOLITAN AREA NETWORK - Rede metropolitana, abrange uma cidade. - É possível ter computadores localizados em vários prédios distantes uns dos outros, em bairros diferentes, por exemplo.
- WAN
- WIDE AREA NETWORK abrange uma grande área geográfica, país ou continente. Ex:. rede de uma empresa com filiais em diferentes cidades. Conexão dessa rede pode ser feita por meio de linhas de transmissão alugadas ou VPN.
- VPN
- REDE PRIVADA VIRTUAL Usa uma rede pública para ligar dois pontos de uma rede privada fazendo uso de criptografia.
- MEIOS DE TRANSMISSÃO
- GUIADO
- Guiado -> Rede cabeada * Cabo coaxial * Cabo par trançado * cabo fibra óptica
- CABO COAXIAL FINO
- * Taxa máxima de transmissão: 10 Mbps * Comprimento máximo de 185 metros por segmento de rede e possui um limite de 30 máquinas conectadas por segmento de rede. * É possível a ligação de até 5 segmentos por rede (repetidor) * 925 metros de comprimentos e 150 máquinas. * conector utilizado: BNC
- fino
- 10 base 2
- grosso
- 10 base 5
- fino
- NÃO GUIADO
- WI-FI
- IEEE 802.11
- IEEE 802.11
- WI-FI
- PAR TRANÇADO
- PAR TRANÇADO * 4 pares de fios ( total 8 fios ) . * arrumados em um padrão espiral regular . * redes de 10 Mbps e 100 Mbps , apenas dois desses pares são usados. * em redes Gigabit Ethernet ( 1 Gbps - 1000 Mbps ) e 10G Ethernet ( 10 Gbps 10.000 Mbps ) os quatro pares são usados simultaneamente de forma a aumentar a taxa de transferência .
- DIAFONIA
- É a medida da interferência elétrica gerada em um par trançado pelo sinal que está trafegando em um par trançado adjacente dentro do mesmo cabo.
- tipos
- * ✗ = blindagem geral sobre os pares * Y = blindagem individual de cada par * TP = par trançado ( Twisted pair) → Blindagem geral* F ( Foil screened ) para folha metálica Ex: F / UTP * S ( Braid screened ) para malha metálicaE× : S / UTP * SF para blindagem com folha e malha metálicaEX: SF / UTP * U ( Unshielded) para os que não possuem a blindagem geralEx : U / UTP → Blindagem individual * F ( Foil ) para folha metálicaEx: F/ FTP e U / FTP * U ( Unshielded ) para os que não possuem blindagem individual .Ex : F / UTP
- UTP
- SEM BLINDAGEM
- sem blindagem
- Sem blindagem : também chamado UTP ( Unshielded Twisted Pair) .
- U/UTP
- U/UTP Sem blindagem
- STP
- COM BLINDAGEM
- com blindagem
- Com blindagem : também chamado STP ( Shielded Twisted Pair ) .
- geral
- F/UTP blindagem com folha metálica Blindagem de forma geram, não individual.
- F/UTP
- S/UTP Folha geral, mas com malha metálica
- S/UTP
- SF/UTL Blindagem geral de folha e malha metálica
- SF/UTP
- individual
- U/FTP
- dupla
- F/FTP
- F/FTP
- UTP
- de 10 Mb a 100 Mb
- redes de 10 Mbps e 100 Mbps , apenas dois desses pares são usados.
- de 1Gb
- em redes Gigabit Ethernet ( 1 Gbps - 1000 Mbps ) e 10G Ethernet ( 10 Gbps 10.000 Mbps)
- CATEGORIA CABOS
- ATENUAÇÃO ( ENFRAQUECIMENTO DO SINAL COM O AUMENTO DA DISTÂNCIA
- CONECTORES
- FIO BLINDADO, CONECTOR BLINDADO
- FIBRA ÓPTICA
- * Primeiro: Interferências eletromagnéticas não ocorrem no tráfego da luz, logo a fibra óptica é totalmente imune a ruídos. * Segundo: O sinal sofre menos o efeito da atenuação, logo conseguimos ter um cabo de fibra óptica muito mais longo sem a necessidade de repetidores. A distância máxima de um segmento do tipo de fibra óptica mais usado é de 2 km (compare com o limite de 185 metros do cabo coaxial fino e com o limite de 100 metros do par trançado). Há fibras ópticas que permitem um segmento maior, enquanto outros tipos de fibra óptica possuem um limite menor de distância.
- * Revestimento: O revestimento envolve o núcleo, possuindo um índice de refração menor do que o do núcleo para permitir o funcionamento da fibra. * Capa: A capa protege a fibra óptica, possuindo um diâmetro de 250 μm ou de 500 μm. Dois outros elementos são adicionados quando a fibra óptica é alojada dentro de um cabo: fibras fortalecedoras – que previnem a quebra da fibra óptica durante o seu manuseio e instalação e o revestimento externo. CLASSIFICAÇÃO As fibras ópticas são classificadas de acordo com o diâmetro do núcleo e do revestimento, em mícron. Assim, uma fibra óptica 50/125 significa que ela possui um núcleo com 50 μm de diâmetro e um revestimento com 125 μm de diâmetro. TIPOSExistem dois tipos de fibras ópticas: modo múltiplo (MMF, Multiple Mode Fiber) e modo único (SMF, Single Mode Fiber). Essa classificação diz respeito a como a luz é transmitida por intermédio da fibra. As fibras de modo múltiplo são mais grossas do que as fibras de modo único.Fibras de modo múltiplo são normalmente 50/125 ou 62,5/125, enquanto as fibras de modo único são normalmente 9/125. Como efeito, a luz reflete mais de uma vez nas paredes da fibra e, com isso, a mesma informação chega várias vezes ao destino, defasada da informação original.
- NUCLEO COM O DIAMETRO MENOR MELHOR PARA CONEXÕES MAIS LONGAS, MENOS ATENUAÇÃO
- Em resumo, as fibras de modo múltiplo são usadas para conexões de curta distância (normal-mente até 2 km), enquanto as fibras de modo único são usadas para conexões de longa distância (dezenas de quilômetros).
- CONECTORES
- GUIADO
- PAN
- TOPOLOGIA
- Uma topologia descreve a forma com que os computadores em uma rede local estão conec-tados. Outro ponto importante é que a topologia pode ser física ou lógica. Sendo assim, podemos definir topologia física como a aparência (layout) da rede, ou seja, como os dispositivos estão conectados ao meio físico. Já a topologia lógica determina como os dados serão transmitidos por intermédio da rede.É importante destacar que não existe uma ligação entre a topologia física e a topologia lógica. Portanto, é possível que uma mesma rede utilize um tipo de topologia física e outro tipo de topologia lógica
- BARRAMENTO
- TOPOLOGIA BARRAMENTO OU LINEAR Neste tipo de topologia, todas as estações ficam diretamente conectadas em um cabo que é o meio físico compartilhado, ou seja, como todos os computadores estão compartilhando o mesmo cabo, fica bastante claro que nenhum computador pode usar o cabo enquanto uma comunicação é efetuada. Uma transmissão de qualquer estação se propaga pela extensão do meio nas duas direções, e pode ser recebida por todas as outras estações.A grande desvantagem da topologia barramento que utiliza cabo coaxial é que, se o cabo partir, todos os computadores deixam de ter acesso à rede. Normalmente não precisa ser um rompimento visível: basta que o cabo apresente mau contato para a rede deixar de funcionar, por exemplo: mau contato no conector tipo T.A inclusão de novas estações no cabo era uma tarefa relativamente simples, bastava incluir um conector do tipo T no cabo e inserir mais uma estação. Por fim, em cada ponta do barramento existe um terminador, que absorve qualquer sinal, removendo-o do barramento.IMPORTANTE: A topologia barramento também é conhecida como topologia linear. Portanto, pode aparecer na sua prova: topologia barramento ou linear.
- * Topologia Linear * Cabo coaxial 10base2 * Só uma máquina pode transmitir por vez. * sem o terminador a rede não funciona * se o cabo romper a rede toda parará * se uma placa de rede der problema ou o computador der problema as outras maquinas funcionarão, o cabo está intacto
- ESTRELA
- TOPOLOGIA EM ESTRELA Na topologia estrela todos os computadores são conectados a um dispositivo central, que pode ser um equipamento concentrador, chamado hub, ou um outro equipamento mais moderno, conhecido como switch. A grande vantagem da topologia em estrela é a sua flexibilidade. Como ela possui um periférico concentrador, caso um dos cabos da rede (par trançado) se rompa, apenas a comunicação entre o periférico concentrador e a máquina na qual o cabo estava conectado será interrompida – a rede continuará funcionando perfeitamente, ao contrário do que ocorre na topologia barramento, que utiliza cabo coaxial.É importante destacar que, se a rede estiver usando um hub, fisicamente, a topologia é em estrela, e cada computador tem seu próprio cabo interligado ao concentrador. Contudo, como o hub é um equipamento que trabalha apenas por broadcast – isto é, quando um computador envia um quadro na rede –, todos os computadores ligados ao hub recebem o mesmo quadro, logo, podemos concluir que, embora fisicamente a rede seja em estrela, o seu funcionamento lógico é em barramento. Sendo assim, apenas um computador pode transmitir por vez.
- O hub é um equipamento que trabalha na camada física do modelo OSI. Ele pode ser classificado como ativo ou passivo. Nesse caso, os hubs ativos são equipamentos que regeneram os sinais que recebem de suas portas antes de enviá-los para todas as demais portas, e, portanto, necessitam de alimentação elétrica, funcionando, assim, como repetidores. Já os hubs passivos não regeneram os sinais, logo, não funcionam como repetidores. Outra característica dos hubs é que eles só operam no modo half-duplex.
- O que é o modo half-duplex? Quando estudamos transmissão de dados, entendemos que existem três modos de transmis-são: simplex, half-duplex e full-duplex. * Simplex: nesse modo de transmissão de dados, um dispositivo é o transmissor e o outro é o receptor, sendo que esse papel não se inverte, isto é, o dispositivo A é sempre o transmissor e o B é sempre o receptor, sendo que B não tem como transmitir informações para o A. Podemos concluir que a transmissão de dados simplex é unidirecional.
- Half-duplex Esse modo de transmissão de dados é bidirecional, porém, por compartilharem um mesmo canal de comunicação, não é possível transmitir e receber dados ao mesmo tempo. Dessa forma, tanto o dispositivo A quanto o dispositivo B podem transmitir, mas um de cada vez, ou seja, não há como os dois transmitirem dados simultaneamente.
- Full-duplex: esse modo de transmissão de dados implementa a verdadeira comunicação bidirecional, ou seja, A e B podem transmitir e receber dados simultaneamente. IMPORTANTE: redes de computadores podem transmitir no modo half-duplex ou no modo full-duplex, dependendo de como a rede estiver configurada
- PLACA ADAPTADORA DE REDE Também conhecida como NIC (network interface card), é responsável pela conexão do computador à rede. Todos os computadores e dispositivos que fazem parte da rede necessitam de uma placa de rede.
- ENDEREÇO MACT odo adaptador de rede tem um endereço de camada de enlace gravado em uma memória presente na própria interface de rede. Um endereço de camada de enlace é também denominado um endereço de LAN, um endereço físico ou um endereço MAC (media access control – controle de acesso ao meio). Normalmente, as questões de prova utilizam a expressão endereço MAC.O endereço MAC tem 6 bytes (48 bits) de comprimento. Estes endereços de 6 bytes são tipi-camente expressos em notação hexadecimal, com cada byte do endereço expresso como um par de números hexadecimais. Os endereços MAC são atribuídos às placas de rede pelos fabricantes.ENDEREÇO MAC80-2B-F9-23-F7-A9Estrutura do Endereço MACUm endereço MAC no padrão ethernet é constituído por 6 bytes, como visto anteriormente, sendo os 3 primeiros conhecidos como endereço OUI (organizationally unique identifier). Eles indi-cam o fabricante (atribuído pelo IEEE), e os 3 últimos são controlados pelo fabricante, identificando de forma exclusiva cada interface fabricada
- * hub é camada física do modelo OSI, ele não guarda o endereço MAC das placas de rede. * Hub é obrigado a enviar o mesmo quadro para todos os computadores. * Trabalha em Half-Duplex.
- CSMA/CD
- Quando os computadores estão interconectados com um hub, a LAN ethernet é uma verdadeira LAN de broadcast – isto é, quando um adaptador transmite um quadro, todos os adaptadores na LAN recebem o quadro. Sendo assim, a ethernet precisa de um protocolo de acesso múltiplo – ela usa o famoso protocolo CSMA/CD(Carrier Sense Multiple Access with Collision Detection – Pro-tocolo de acesso múltiplo com detecção de colisão).Como o protocolo CSMA/CD funciona?Para o CSMA/CD, um computador que deseja transmitir primeiro escuta o meio para determinar se outra transmissão está em andamento (percepção da portadora – carrier sense). Se o meio estiver ocioso, o computador pode transmitir.Pode acontecer de dois ou mais computadores tentarem transmitir ao mesmo tempo. Se isso acontecer, haverá uma colisão. O procedimento a seguir especifica o que um computador deverá fazer se o meio estiver ocupado e o que ele deverá fazer se houver uma colisão:Se o meio estiver ocioso, transmita; caso contrário, vá para a etapa 2.Se o meio estiver ocupado, continue a escutar até que esteja ocioso, e depois transmita imediatamente.Se uma colisão for detectada durante a transmissão, transmita um rápido sinal de colisão para garantir que todos os computadores saibam que houve uma colisão e, depois, pare de transmitir.Depois de transmitir o sinal de colisão, espere por um tempo aleatório, conhecido como bac-koff, em seguida, tente transmitir novamente (repita a partir da etapa 1)
- MEIO É O CABO, MEIO DE TRANSMISSÃO
- SWITCH LAYER 2
- REDES DE COMPUTADORES SWITCH LAYER 2 (CAMADA DOIS) É um equipamento de rede que trabalha na camada de enlace do modelo OSI (camada 2), ou seja, trabalha analisando o endereço MAC dos adaptadores ligados à rede. Com isso, é possível transmitir quadros de dados somente para a porta de destino do quadro, ao contrário do hub, no qual os quadros são transmitidos simultaneamente para todas as suas portas, permitindo, assim, melhorar o desempenho da rede. Como funciona a tabela de comutação? A tabela de comutação contém registros para alguns nós (dispositivos conectados em rede, por exemplo, computadores) da LAN, mas não necessariamente para todos. Explicando, se o endereço MAC do quadro for desconhecido pelo switch (se este não souber para qual porta deve entregar o quadro) ele gera um processo conhecido como inundação (flooding): o quadro é enviado para todas as portas (menos para a porta de origem do quadro). Podemos concluir que durante o processo de inundação, o switch opera da mesma forma que o hub.ATENÇÃO − Outra diferença importante entre hubs e switches é que hubs só operam no modo half-duplex, enquanto os switches permitem a operação da rede no modo full-duplex.Aprendizagem automáticaUm switch (comutador) tem a capacidade de montar sua tabela de forma automática.Funciona assim:ͫ A tabela de comutação está inicialmente vazia.ͫ Para cada quadro recebido em uma interface, o comutador armazena em sua tabela inicialmente o endereço MAC que está no campo de endereço de fonte do quadro e, em seguida, armazena a informação sobre a interface de onde veio o quadro e, por último, armazena o horário corrente. Dessa maneira, o comutador registra em sua tabela o seg-mento MAC no qual reside o nó remetente. Se cada nó da LAN finalmente enviar um quadro, então cada nó será finalmente registrado na tabela. Dessa forma, ao encaminhar um quadro, o switch verifica se o MAC de destino está na tabela de comutação e, caso esteja, o switch o encaminha apenas para essa porta listada na tabela. Porém, se o MAC de destino não estiver registrado na tabela de comutação, o switch realiza o processo de inundação (flooding) do quadro.ͫ O comutador apagará um endereço na tabela se nenhum quadro que tenha aquele endereço como endereço de fonte for recebido após um certo período de tempo (tempo de envelhecimento). Desse modo, se um computador for substituído por outro computa-dor (com um adaptador de rede diferente), o endereço MAC do computador original acabará sendo excluído da tabela de comutação.
- * Trabalha na camada 2 (OSI) enlance de dados * Analisa os endereços MAC, assim transmite os quadros apenas para quem é de direito. * Melhora o desempenho da REDE. * Tabela de comutação, registos para alguns nós (dispositivos conectados em rede, por exemplo computadores) da LAN. * Flooding (inundação) o switch não encontra a porta para entregar o quadro ele envia para todos os dispositivos na rede menos para a porta de origem ou seja no flooding (inundação o switch opera como o HUB. * Toda vez que envia o pacote para todos ele pergunta a quem pertence, quando ele descobre, guarda em sua memória o endereço MAC, para que na próxima vez ele encaminhe o pacote diretamente para ele.* Diferença entre hubs e switches e que hub opera de half-duplex e switches em full-duplex.* cada porta do switech corresponde a um domínio de colisão diferente. * 1 domínio de broadcast, quando uma mensagem de broadcast e enviada para a rede, todos os computadores, há perde de desempenho. * VLAN -> Oferecido por alguns modelos de switch cria redes diferentes, criando assim 2 domínio de broadcast, 1 para cada rede. * Switch de camada 2 não permite comunicação de uma VLAN com outra VLAN. Para isso é possível utilizar um rotador.
- Switch Layer 3 - Opera na camada 3 (OSI) - Trabalha com endereço IP - Ele é multi camada, trabalha na camada 2 - Interliga rede diferentes, - Permite comunicação entre VLANs - Mellhora o desempenho da rede
- - ANEL 1 manda para o 2, 2 para o 3, 3 para o 4, 4 para 1 - Só pode mandar mensagem quem tiver o token, o - computador 1 está com o Token manda mensagem para o computador 3. então o computador envia para o dois o dois perceve que o token não está livre e percebe que ele esta com um conteúdo que é para o 3, então ele passa o token para frente
- ANEL
- PADRAO DE REDE CABEADO Criada pela IBMARQUITETURA TOKEN RING (IBM)IEEE802.5 (I-TRÊS-E)para concorrer 802.3- 4 mbps- 16 mbps
- MAU
- MULTISTATION ACCESS UNIT
- FÍSICA
- LÓGICA
- BROADCAST
- O broadcast de rede é uma tecnologia que permite a transmissão de informações para vários destinatários simultaneamente. É uma forma de comunicação em massa que é utilizada em diversos setores, como televisão, rádio, internet e telefonia.
- Tenho uma LAN em minha casa e quero que a minha LAN se conecte a internet, precisarei usar um roteador. Roteador interliga redes.
- Switch e roteadores são equipamentos utilizados para definir a origem e o destino de pacotes de dados que trafegam entre máquinas de usuários ou de servidores e podem ser utilizados para interligar varias redes de computadores entre si. Pegadinha da CESP ela não falou se era ou não Layer 2 ou 3, ela generalizou e considerou como certa.
- SISTEMA DE NUMERAÇÃO CONVERSÕES
- BINÁRIO
- DECIMAL
- HEXADECIMAL
- BINÁRIO
- MÁSCARA DE SUB-REDE
- CÁLCULO DE MÁSCARÁ DE SUB-REDE AVANÇADO
- CÁLCULO DE MÁSCARÁ DE SUB-REDE AVANÇADO
NOÇÕES DE PROGRAMAÇÃO
- algoritmo
- Um algoritmo nada mais é do que um texto contendo comandos (instruções) que devem ser executados numa determinada ordem. Ou seja, algoritmo é um conjunto de instruções, como uma receita de bolo, constituído de um número finito de passos. De forma simplificada, em computação o que fazemos é * analisar o problema *criar um algoritmo genérico que resolva esse problema *escrever um programa que implemente esse algoritmo *testar o programa para verificar se ele realmente funciona
- linguagem de programação
- A forma como implementamos esse programa é por meio das linguagens de programação * Linguagens formais, precisas e cujas instruções podem ser executadas por um computador. Basicamente, as linguagens de programação podem ser divididas em: linguagem de baixo nível e linguagem de alto nível
- linguagem compilada
- Nessa linguagem, um compilador lê o programa de alto nível (denominado código-fonte) e traduz esse código completamente antes de executá-lo, ou seja, o compilador traduz o código-fonte para código de máquina de uma plataforma específica e salva o código gerado em um arquivo executável. Uma vez que o programa tenha sido compilado, você pode executá-lo quantas vezes quiser, sem que seja necessário usar o compilador novamente
- C
- C#
- linguagem interpretada
- Linguagem interpretada Linguagem interpretada As linguagens interpretadas funcionam da seguinte forma: um interpretador lê as linhas do código-fonte uma de cada vez, e para cada linha interpretada uma ação é executada internamente no computador, a qual irá gerar algum tipo de saída. Dessa forma, se o código do programa tiver dez linhas e a nona linha possuir um erro, você só irá descobri-lo quando a nona linha for interpretada e tiver feito todas as operações das linhas anteriores.Já em uma linguagem compilada, o compilador verifica todas as linhas do programa antes de executá-lo, ou seja, um programa compilado só é executado se todo o código estiver corretamente escrito e for antes verificado, o que não acontece com um código de programa em linguagem interpretada.
- PYTHON
- Python é uma linguagem de programação de alto nível. Essa linguagem é muito interessante como primeira linguagem de programação devido à sua simplicidade e clareza. Embora simples, Python é uma linguagem poderosa, podendo ser usada, por exemplo, para análise de dados, inteligência artificial e machine learning.Python é software livre e pode ser utilizado em praticamente qualquer arquitetura de computadores ou sistema opera-cional, como Linux, Microsoft Windows e Mac OS.Uma grande vantagem do Python é a legibilidade dos programas escritos nessa linguagem. Outras linguagens de pro-gramação utilizam inúmeras marcações, como ponto (.) ou ponto e vírgula (;), no fim de cada linha, além dos marcadores de início e fim de bloco como ({ }) ou palavras especiais (begin/end). Esses marcadores tornam os programas um tanto mais difíceis de ler e felizmente não são usados em Python.
- CARACTERÍSTICAS
- Principais características: * Python é uma linguagem dinamicamente tipada: não há declaração explícita de tipos de variáveis; * Fortemente tipada: impede operações entre tipos incompatíveis; * Case-sensitive; * Indentação obrigatória: define blocos e hierarquias. INDENTAÇÃO Python é uma das poucas linguagens de programação que utiliza o deslocamento do texto à direita (recuo) para marcar o início e o fim de um bloco. Exemplo While < condição > .....bloco
- DINAMICAMENTE tipada
- Python é uma linguagem dinamicamente tipada: não há declaração explícita de tipos de variáveis;
- FORTEMENTE tipada
- case - sensitive
- Indentação obrigatória
- Fortemente tipada: impede operações entre tipos incompatíveis; * Case-sensitive; * Indentação obrigatória: define blocos e hierarquias.
- variável e atribuição
- Em programação variáveis são utilizadas para armazenar valores e para dar nome a uma área de memória do computador onde armazenamos dados.
- nomes e validade
- $
- IMPORTANTE - A versão 3 da linguagem Python permite a utilização de acentos em nomes variáveis, pois, por padrão, os programas são interpretados utilizando-se um conjunto de caracteres chamado UTF-8, capaz de representar praticamente todas as letras dos alfabetos conhecidos
- o nome da variável não pode começar com . (ponto)
- $
- tipos de dados
- operadores relacionais
- operadores matemáticos
- operadores lógicos
- EXPRESSÃO MATEMÁTICA
- print
- print
- not
- not true = false not false = true
- and
- true and true = true true and false = false false and false = false false and true = false
- or
- true or true = true true or false = true false or true = true false or false = false
- $
- Expressão lógica Quando tiver mais de um operador lógico, avalia-se 1º not 2º and 3º or
- EXPRESSÃO MATEMÁTICA
- operadores lógicos
- $
- = atribui
- = =
- igual a
- ! =
- deferente de
- <
- menor que
- < =
- menor igual a
- >
- maior que
- > =
- maior igual a
- operadores matemáticos
- operadores relacionais
- $
- type() informa o tipo da variável
- STRING
- (" texto ")
- len
- Essa função retorna o número de caracteres na string. Dizemos que a função retorna um valor, quando podemos substituir o texto da função por seu resultado. A função len retorna um valor do tipo inteiro, representando a quantidade de caracteres contidos na string. Se a string é vazia (representada simplesmente por “”, ou seja, duas aspas sem nada entre elas, nem mesmo espaço em branco), seu tamanho é igual a zero.
- Como dito anteriormente, outra característica de strings é poder acessar seu conteúdo caractere a caractere. Sabendo que uma string tem um determinado tamanho, podemos acessar seus caracteres utilizando o número inteiro para repre-sentar sua posição. Esse número é chamado de índice, e começamos a contar de zero. Isso quer dizer que o primeiro caractere da string é de posição ou índice 0.Para acessar os caracteres de uma string, devemos informar o índice ou posição do caractere entre colchetes ([ ]). Como o primeiro caractere de uma string é o de índice 0, podemos acessar valores de 0 até o tamanho de uma string menos 1. Logo, se a string contiver 9 caracteres, podemos acessar os caracteres de 0 a 8.Se tentarmos acessar um índice maior que a quantidade de caracteres da string, o interpretador emitirá uma mensagem de erro.
- - índice começa em zero - índice tem que ser entre colchetes
- * Resultado da função len é um número inteiro
- concatenação
- Os conteúdos de variáveis strings podem ser somados, ou melhor, concatenados. Para concatenar duas strings, utilizamos operador de adição (+) são assim como “AB” + “C” é igual a “ABC”. Um caso especial de concatenação é a repetição de uma string várias vezes. Para isso, utilizamos operador de multiplicação (*): “A”* 3 é igual a “AAA”.
- "AB"+"C" = "ABC"
- OPERAÇÃO LÓGICA
- string * string = erro concatenar tem que ser com duas strings fortemente tipado
- fatiamento
- composição format
- fstring
- imput + conversão
- imputa um valor o python recebe como String, mas é possível converter colocando o tipo da variável desejável na frente.
- ESTRUTURA DE REPETIÇÕES
- While
- break
- break
- Operadores de atribuições especiais
- for
- range
- range
- While
- ESTRUTURA CONDICIONAL
- if
- estruturas aninhadas
- pode ser float no lugar INT
- estruturas aninhadas
- if
- IMPORTANTES
- lista
- - a lista tem índices - variável composta
- fatiamento da lista
- copiar e mudar
- len
- adição de elementos
- coloca no final
- append
- insert
- ordenação dos elementos da lista
- excluir elementos
- tupla
- - valor imutável - usamos parênteses para criar
- diferença
- - Lista usa [colchetes]. - Tupla (parênteses). Tupla não se pode alterar. - Tabela usa {chaves}, apenas o valor do elemento. - Dicionário usa {chaves}, mas tem combinação de chave + valor. - Não aceita valores repetidos e nem indexação. - Dicionário vazio {} - Conjunto vazio () - Valor, entre chaves, sozinho é conjunto, valor, entre chaves, chave + valor é dicionário.
- dicionários
- conjuntos
- Conjunto, set em Python, é uma estrutura de dados que implementa operações de união, intersecção e diferença, entre outras. A principal característica dessa estrutura de dados é não admitir repetição de elementos. Outra característica importante é que conjuntos não mantém a ordem de seus elementos, ou seja, não suportam indexação.
- adicionar elementos
- operador in
- função união
- função intersecção
- função diferença
- função remove
- função descarte
- diferença
- discard não dá erro quando se tenta deletar um número que não existe.
- diferença
- função descarte
- função diferença simétrica
- criando
- lista
- PYTHON
- AMBIENTE R
- - Uso de pacotes estatísticos para a análise de dados
- Parte inicial
- Operadores aritméticos
- operadores de comparação
- tipos de dados
- class
- tipos de dados
- operadores de comparação
- características
- Como o R é uma linguagem de programação orientada a objetos o usuário pode criar suas próprias funções, e sua própria rotina na análise de dados.
- fins estatísticos
- - O R torna-se, portanto, uma importante ferramenta na análise e na manipulação de dados, com testes paramétricos e não paramétricos, modelagem linear e não linear, análise de séries temporais, análise de sobrevivência, simulação e estatística espacial, entre outros, além de apresentar facilidade na elaboração de diversos tipos de gráficos, no qual o usuário tem pleno controle sobre o gráfico criado. Além dos procedimentos estatísticos o R permite operações matemáticas simples, e manipulação de vetores e matrizes. Assim como confecção de diversos tipos de gráficos.
- gratuito
- orientado ao objeto
- Objetos são entidades lógicas que podem ser usadas pelo programa R para armazenar valores, ou seja, um objeto é um espaço na memória do computador que pode ser utilizado para armazenar dados.
- interativo
- Outro atributo do R é sua capacidade de interagir com outros programas estatísticos, bem como de banco de dados.
- atribuição
- case-sensitive
- logical
- Tem que ser maiúscula -TRUE -FALSE
- criar objeto
- É importante dizer que o nome de um objeto pode começar com uma letra qualquer, maiúscula ou minúscula, que pode ser seguida de outra letra, número, ponto (.) ou sublinhado (_).
- tipos de objetos
- vetor
- indexando vetores
- indexando vetores
- vetor
- criar objeto
- listar objeto
- A função ls() mostra os objetos criados até o momento.
- apagar objeto
- É possível apagar objetos com o uso do rm ou remove.
- remover lista completa
- Além disso, é possível apagar todos os objetos de uma só vez. Nesse caso, podemos utilizar: rm(list=ls()) ou remove(list=ls()).
- remover lista completa
- apagar objeto
- funções
- seq
- a = 1:20 a = seq ( 1, 20 ) a = seg( 4, 61, 8) [1] 4 12 20 28 36 44 52 60 o ultimo pode não entrar
- :
- a = 1:100 Para criar vetores de númeors com intevalo fixo unitario ( intervalo de 1 ) se utiliza o operadora sequencia l (:)
- sqrt
- função utilizada para calcular a raiz quadrada aqrt ( 9) [1] 3
- factorial
- factorial (4) [1] 24
- rep
- rep (1,6) [1] 1 1 1 1 1 1 rep ( c (10,30),6 ) [1] 10 30 10 30 10 30 10 30 10 30 10 30
- length
- > a = c (1,5,6,20:100) > length (a) [1] 84
- sample
- Na linguagem R, a função sample permite realizar amostras aleatórias de determinado conunto de dados com ou sem reposição. reposição = valores repetidos
- list()
- admite armazenar vários valores diferentes, mesmo de tipos diferentes
- - são introduzidos de forma usual (nome = argumento) -
- if e else
- Diferente Python if ( 1 + 1 = 2 ) { TRUE } else { FALSE } pode se usar apenas o IF sem o else
- matrix
- são objetos que admitem armazenar vários valores diferentes em varias linhas e colunas, porém tudo do mesmo tipo.
- data.frame
- mean
- função utilizada para calcular a média aritmética > x <- c ( 5, 3, 4 ) mean (x) [1] 4
- median
- função utilizada para calcular a mediana > x <- c (7,30,1,0,9,5,100) > median (x) [1] 7
- max
- função utilizada para retornar o maior valor de um conjunto
- min
- função utilizada para retornar o menor valor de um conjunto de dados
- sum
- sum (x)
- seq
- GRÁFICOS
- baixo nível
- Quando pensamos no hardware do computador, precisamos compreender que ele só entende uma linguagem de baixo nível, também conhecida como linguagem de máquina, nesse caso, essa linguagem trabalha com uma sequência de zeros e uns, ou seja, em código binário. Portanto, podemos concluir que essa linguagem é muito difícil de programar
- alto nível
- Diferentemente da linguagem de baixo nível, a linguagem de alto nível possui comandos que utilizam palavras que estão bem mais próximas da nossa linguagem (da linguagem humana), portanto, é mais fácil e agradável de aprender. Como essas linguagens são entendidas pelo computador? A implementação de qualquer linguagem de programação requer que os programas nessa linguagem sejam analisados e traduzidos para serem executados em computadores. Nesse caso, existem basicamente dois tipos diferentes de linguagens: a linguagem compilada e a linguagem interpretada.
- variáveis do tipo lógico
- True e False têm que ser com as iniciais maiúsculas.
- algoritmo
EXERCÍCIOS
Images and files in the map


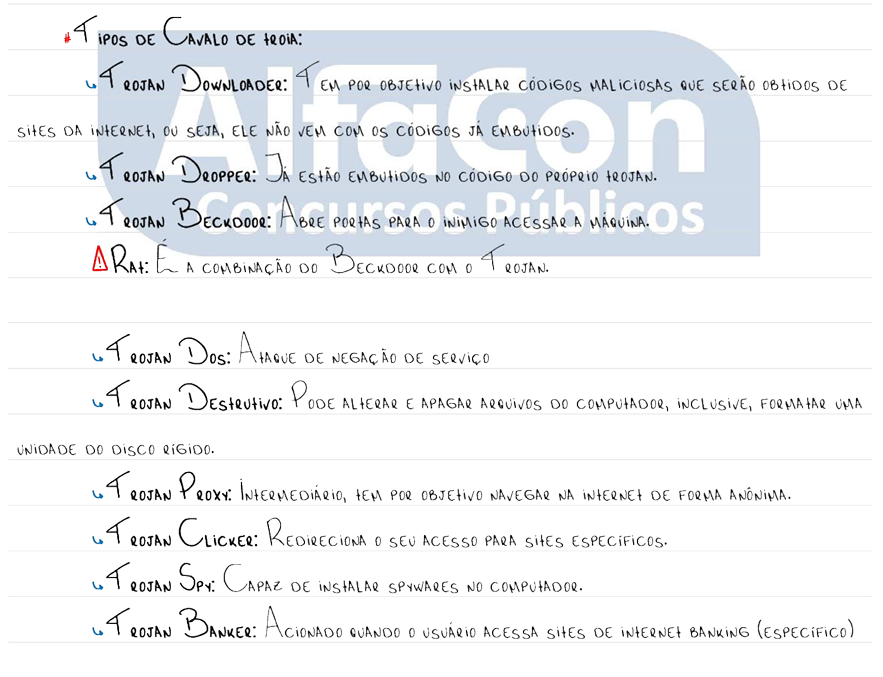
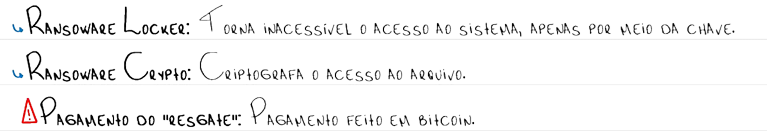
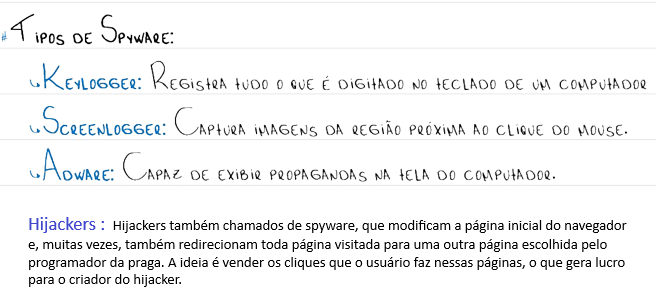
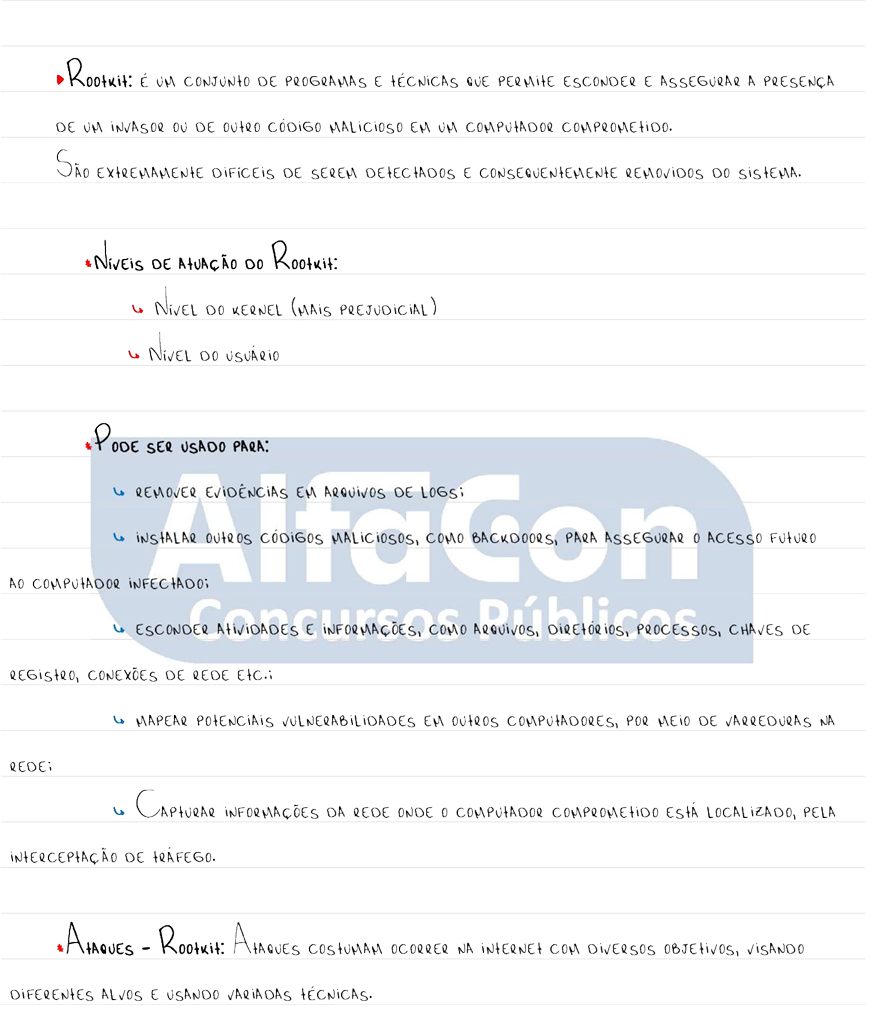
- O Que é Sharepoint #Shorts (video/mp4)
- Definição E Benefícios (application/pdf)
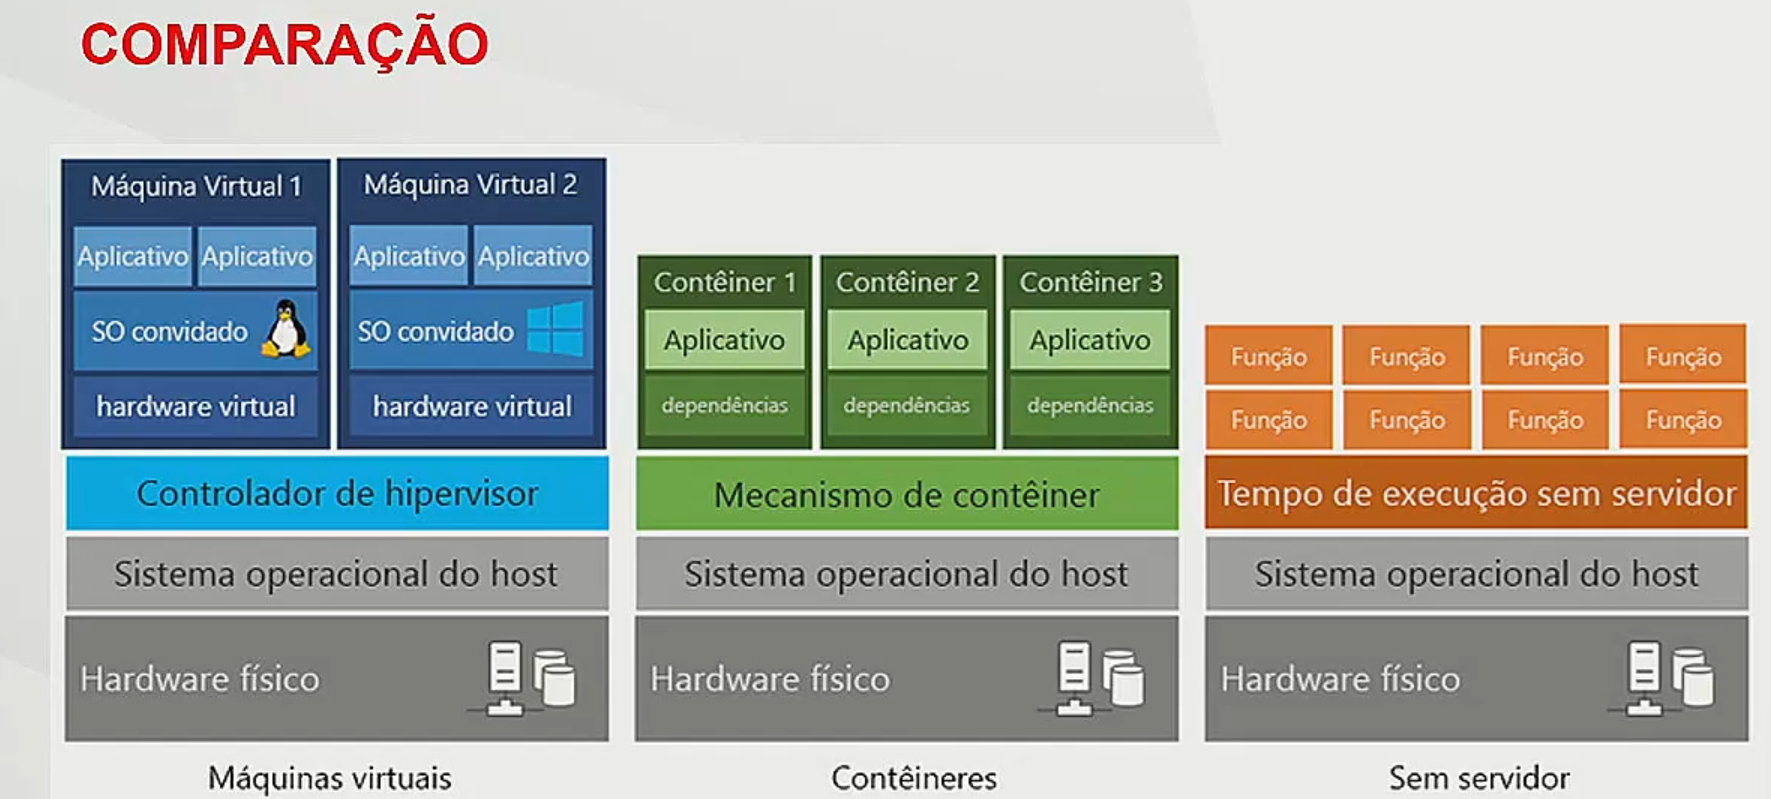


- Criptografia (video/mp4)


- Fusao De Tabelas (video/mp4)


- Pacote Exercicios Informatica Rafael Araujo (application/pdf)
Information
- Description
- concurso Arquivo Mind Map on Alpha INFORMÁTICA, created by JOHNATAS R on 10/08/2024.
- Created by
- JOHNATAS R
- Views
- 1
- Rating