
Mind map
Machine Learning
Map content
Machine Learning
Algoritmos
- Aprendizagem supervisionada
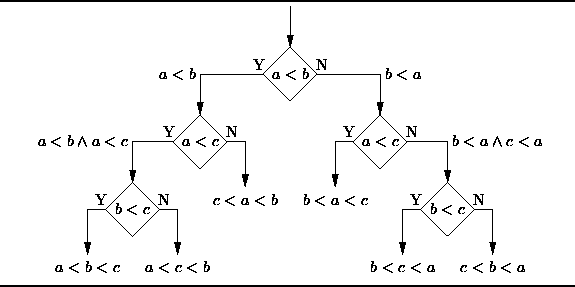
- Árvores de decisão
- Uma árvore de decisão é o número mínimo de perguntas que devem ser respondidas para avaliar a probabilidade de tomar uma decisão correta, na maioria das vezes. Como um método, permite-lhe abordar o problema de uma forma estruturada e sistemática para chegar a uma conclusão lógica.
- Classificação Naïve Bayes
- Família de classificadores probabilísticos simples com base na aplicação do teorema de Bayes - teorema com forte independência entre as características. Equação – em que P (A| B) é a probabilidade posterior, P (B|A) é a probabilidade, P (A) é a probabilidade prévia e P (B) é preditor de probabilidade prévia.
- Alguns exemplos reais são: Para marcar um e-mail como spam ou não spam /Classificar um artigo de notícias sobre tecnologia, política ou esportes/ Verificar um pedaço de texto expressando emoções positivas ou negativas / Usado para software de reconhecimento facial
- Família de classificadores probabilísticos simples com base na aplicação do teorema de Bayes - teorema com forte independência entre as características. Equação – em que P (A| B) é a probabilidade posterior, P (B|A) é a probabilidade, P (A) é a probabilidade prévia e P (B) é preditor de probabilidade prévia.
- Regressão Linear de Mínimos Quadrados
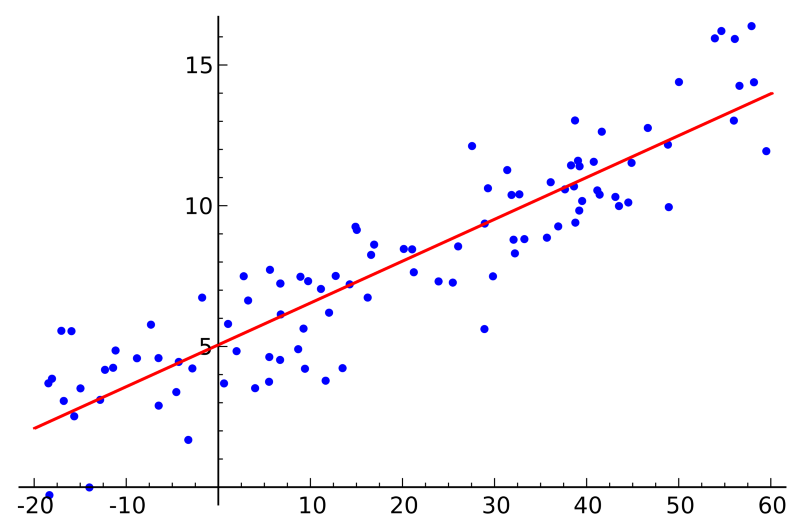
- Tarefa de encaixar uma linha reta através de um conjunto de pontos. “Mínimos quadrados comuns” é assim: desenhar uma linha e, em seguida, para cada um dos pontos de dados, medir a distância vertical entre o ponto e a linha e somá-los. A linha ajustada seria aquela em que esta soma de distâncias é a menor possível. Linear refere-se ao tipo de modelo usado para ajustar os dados, enquanto mínimos quadrados refere-se ao tipo de métrica de erro que se está minimizando.
- Regressão logística
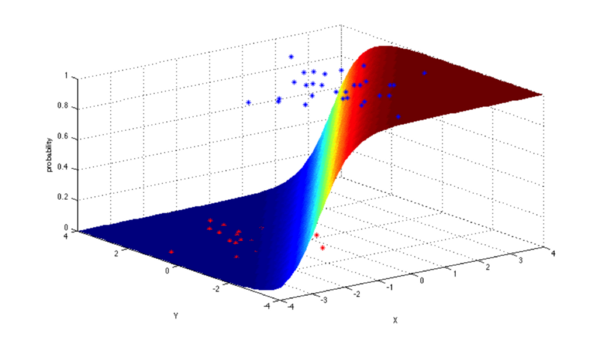
- Forma estatística de modelar um resultado binomial com uma ou mais variáveis explicativas. Mede a relação entre a variável dependente categórica e uma ou mais variáveis independentes, estimando as probabilidades usando uma função logística, que é a distribuição logística cumulativa.
- Em geral, as regressões podem ser usadas em aplicações reais, tais como: Pontuação de crédito / Medir as taxas de sucesso das campanhas de marketing / Prever as receitas de um determinado produto / Haverá um terremoto em um determinado dia?
- Forma estatística de modelar um resultado binomial com uma ou mais variáveis explicativas. Mede a relação entre a variável dependente categórica e uma ou mais variáveis independentes, estimando as probabilidades usando uma função logística, que é a distribuição logística cumulativa.
- Support Vector Machine
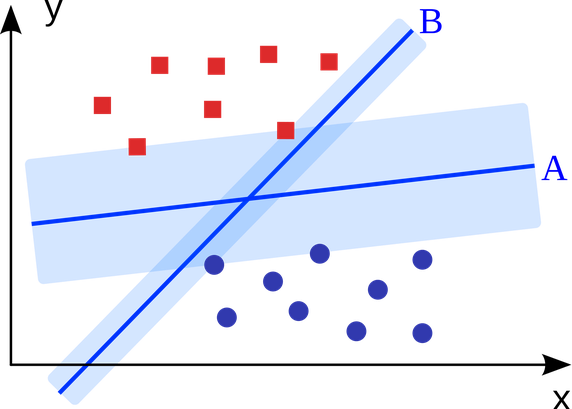
- SVM é um algoritmo binário da classificação. Dado um conjunto de pontos de 2 tipos em lugar N dimensional, SVM gera um hiperplano (N – 1) dimensional para separar esses pontos em 2 grupos. Digamos que você tem alguns pontos de 2 tipos em um papel que são linearmente separáveis. SVM encontrará uma linha reta que separa esses pontos em 2 tipos e situados o mais longe possível de todos esses pontos.
- Em termos de escala, alguns dos maiores problemas que foram resolvidos usando SVMs (com implementações adequadamente modificadas) são publicidades em display, reconhecimento de site de splice humano, detecção de gênero baseada em imagem, classificação de imagem em grande escala etc.
- SVM é um algoritmo binário da classificação. Dado um conjunto de pontos de 2 tipos em lugar N dimensional, SVM gera um hiperplano (N – 1) dimensional para separar esses pontos em 2 grupos. Digamos que você tem alguns pontos de 2 tipos em um papel que são linearmente separáveis. SVM encontrará uma linha reta que separa esses pontos em 2 tipos e situados o mais longe possível de todos esses pontos.
- Ensemble Methods
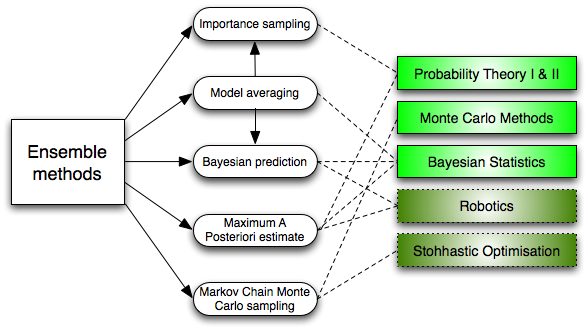
- Constroem um conjunto de classificadores e, em seguida, classificam novos pontos de dados, tendo um ponderado voto de suas previsões. O método de conjunto original é a média bayesiana, mas os algoritmos mais recentes incluem codificação de saída, correção de erros, bagging e reforço. Superiores aos modelos individuais, reduzem a variância: a opinião agregada de um monte de modelos é menos barulhenta do que a opinião única de um dos modelos. É por isso que seus modelos serão melhores com mais pontos de dados do que menos. É improvável que eles se sobreponham: se você tem modelos individuais que não se sobrepõem e está combinando as previsões de cada modelo de uma maneira simples (média, média ponderada, regressão logística), então não há espaço para sobrecarga.
- Em finanças, isso é chamado diversificação – uma carteira mista de muitas ações será muito menos variável do que apenas um dos estoques sozinho.
- Constroem um conjunto de classificadores e, em seguida, classificam novos pontos de dados, tendo um ponderado voto de suas previsões. O método de conjunto original é a média bayesiana, mas os algoritmos mais recentes incluem codificação de saída, correção de erros, bagging e reforço. Superiores aos modelos individuais, reduzem a variância: a opinião agregada de um monte de modelos é menos barulhenta do que a opinião única de um dos modelos. É por isso que seus modelos serão melhores com mais pontos de dados do que menos. É improvável que eles se sobreponham: se você tem modelos individuais que não se sobrepõem e está combinando as previsões de cada modelo de uma maneira simples (média, média ponderada, regressão logística), então não há espaço para sobrecarga.
- Árvores de decisão
- Aprendizagem não supervisionada
- Clustering
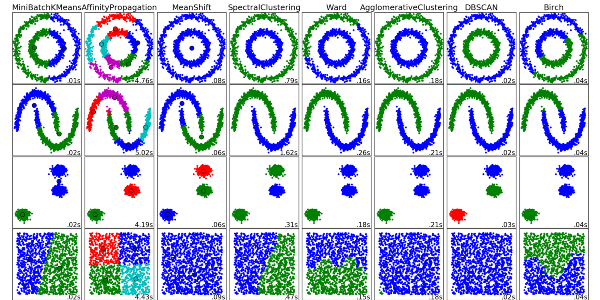
- É a tarefa de agrupar um conjunto de objetos de tal forma que os do mesmo grupo (cluster) são mais semelhantes uns aos outros do que aqueles em outros grupos. Cada algoritmo de agrupamento é diferente, e aqui estão alguns deles: Algoritmos baseados em Centroid / Algoritmos baseados em conectividade / Algoritmos baseados em densidade / Probabilístico / Redução da Dimensionalidade / Redes Neurais / Aprendizagem Profunda
- Decomposição em valores singulares
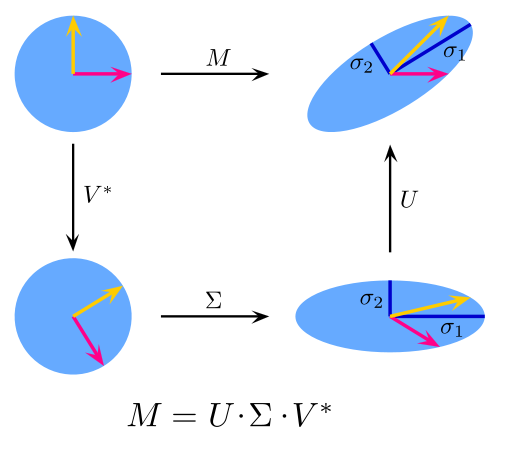
- Na álgebra linear, a SVD é uma fatorização de uma matriz complexa real. Para uma dada matriz m* n M, existe uma decomposição tal que M = UΣV, onde U e V são matrizes unitárias e Σ é uma matriz diagonal.PCA é realmente uma aplicação simples de SVD.
- Na visão computacional, os algoritmos de reconhecimento de primeira face usaram PCA e SVD para representar faces como uma combinação linear de “eigenfaces”, fazer redução de dimensionalidade e, em seguida, corresponder faces a identidades através de métodos simples. Embora os métodos modernos sejam muito mais sofisticados, muitos ainda dependem de técnicas semelhantes.
- Na álgebra linear, a SVD é uma fatorização de uma matriz complexa real. Para uma dada matriz m* n M, existe uma decomposição tal que M = UΣV, onde U e V são matrizes unitárias e Σ é uma matriz diagonal.PCA é realmente uma aplicação simples de SVD.
- Análise de Componentes Principais
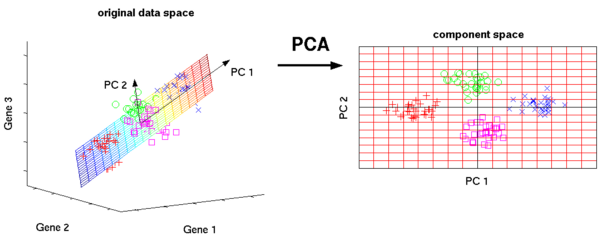
- PCA é um procedimento estatístico que usa uma transformação ortogonal para converter um conjunto de observações de variáveis, possivelmente correlacionadas em um conjunto de valores de variáveis linearmente não correlacionadas, chamadas componentes principais.
- Algumas das aplicações do PCA incluem compressão, simplificação de dados para facilitar o aprendizado e visualização. Observe que o conhecimento do domínio é muito importante ao escolher se deseja avançar com PCA ou não. Não é adequado nos casos em que os dados são ruidosos (todos os componentes da PCA têm uma variação bastante alta).
- PCA é um procedimento estatístico que usa uma transformação ortogonal para converter um conjunto de observações de variáveis, possivelmente correlacionadas em um conjunto de valores de variáveis linearmente não correlacionadas, chamadas componentes principais.
- Análise de componentes independentes
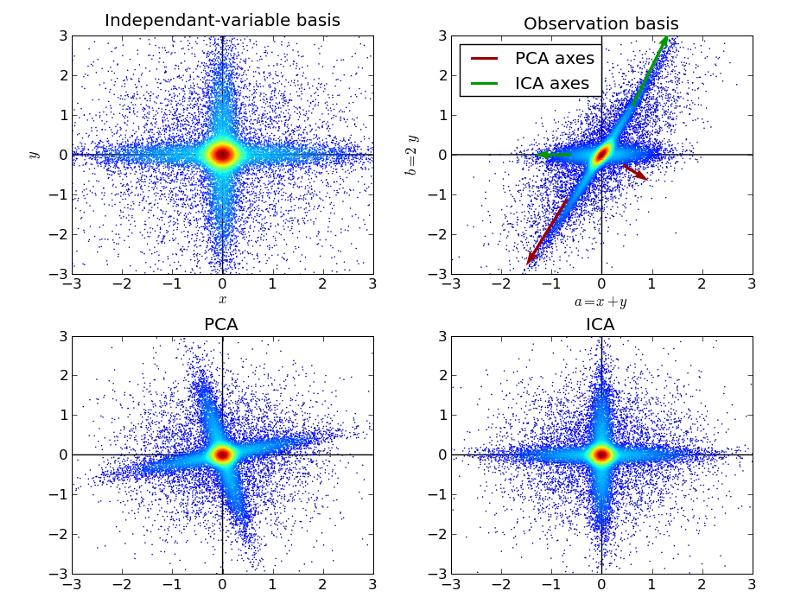
- ICA é uma técnica estatística para revelar fatores ocultos que estão subjacentes a conjuntos de variáveis aleatórias, medições ou sinais. A ICA define um modelo generativo para os dados multivariados observados, que normalmente é dado como um grande banco de dados de amostras. No modelo, as variáveis de dados são assumidas como misturas lineares de algumas variáveis latentes desconhecidas, e o sistema de mistura também é desconhecido. As variáveis latentes são consideradas não-gaussianas e mutuamente independentes, e são chamadas de componentes independentes dos dados observados.
- A ICA está relacionada ao PCA, mas é uma técnica muito mais poderosa, capaz de encontrar os fatores subjacentes das fontes quando esses métodos clássicos falham completamente. Suas aplicações incluem imagens digitais, bancos de dados de documentos, indicadores econômicos e medições psicométricas.
- ICA é uma técnica estatística para revelar fatores ocultos que estão subjacentes a conjuntos de variáveis aleatórias, medições ou sinais. A ICA define um modelo generativo para os dados multivariados observados, que normalmente é dado como um grande banco de dados de amostras. No modelo, as variáveis de dados são assumidas como misturas lineares de algumas variáveis latentes desconhecidas, e o sistema de mistura também é desconhecido. As variáveis latentes são consideradas não-gaussianas e mutuamente independentes, e são chamadas de componentes independentes dos dados observados.
- Clustering
- Aprendizado por reforço
- Redes Neurais
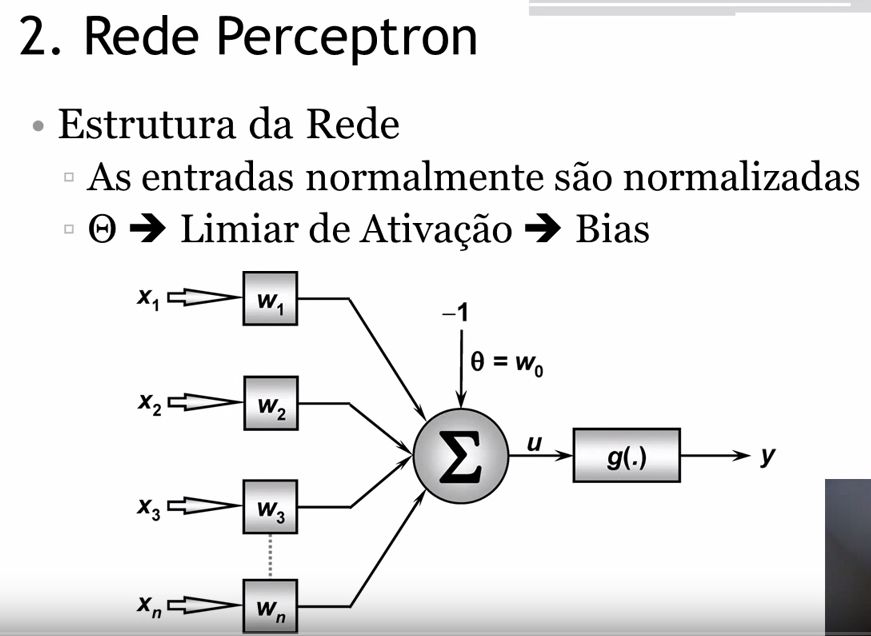
- As redes neurais artificiais (RNA) têm muitas vantagens, porque se baseiam na estrutura do sistema nervoso humano, principalmente o cérebro. Sua Aprendizagem: as RNAs têm a capacidade de aprender através de uma fase chamada fase de aprendizagem. Trata-se de fornecer dados como entrada RNA, por sua vez, informando qual é a saída (resposta) que é esperada. Auto-organização: uma RNA cria sua própria representação de informação no seu interior, desobrigando o usuário disto. Tolerância a falhas: Como uma RNA armazena informações de forma redundante, pode continuar a responder de uma forma aceitável, mesmo que esteja parcialmente danificada. Flexibilidade: Uma rede neural não pode lidar com grandes mudanças na informação de entrada, tais como sinais ruidosos ou outras alterações na entrada (por exemplo, se a informação de entrada é a imagem de um objeto, a correspondente resposta mantém-se inalterada, mesmo se a imagem muda um pouco de brilho ou o objeto muda um pouco de formato). Real
- Assim como outros métodos de aprendizado de máquina, sistemas que aprendem a partir dos dados, redes neurais têm sido usadas para resolver uma grande variedade de tarefas que são difíceis de resolver utilizando programação baseada em regras comuns, incluindo visão computacional e reconhecimento de voz.
- As redes neurais artificiais (RNA) têm muitas vantagens, porque se baseiam na estrutura do sistema nervoso humano, principalmente o cérebro. Sua Aprendizagem: as RNAs têm a capacidade de aprender através de uma fase chamada fase de aprendizagem. Trata-se de fornecer dados como entrada RNA, por sua vez, informando qual é a saída (resposta) que é esperada. Auto-organização: uma RNA cria sua própria representação de informação no seu interior, desobrigando o usuário disto. Tolerância a falhas: Como uma RNA armazena informações de forma redundante, pode continuar a responder de uma forma aceitável, mesmo que esteja parcialmente danificada. Flexibilidade: Uma rede neural não pode lidar com grandes mudanças na informação de entrada, tais como sinais ruidosos ou outras alterações na entrada (por exemplo, se a informação de entrada é a imagem de um objeto, a correspondente resposta mantém-se inalterada, mesmo se a imagem muda um pouco de brilho ou o objeto muda um pouco de formato). Real
- Redes Neurais
- Aprendizagem supervisionada
Para fazer previsões ou sugestões calculadas com base em grandes quantidades de dados.
Netflix, Amazon, Spotify...
Images and files in the map
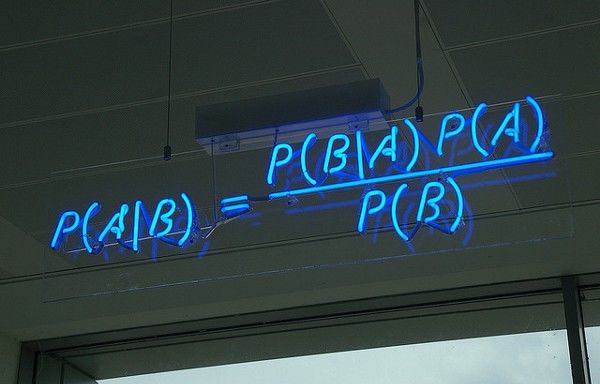
Information
- Description
- Computação Mind Map on Machine Learning, created by José Luiz Jr. on 17/07/2017.
- Created by
- José Luiz Jr.
- Views
- 5
- Rating